ARTICLE · 1257265
HTML 转 PDF 不用装浏览器了:等了这么多年,纯 C# 的渲染引擎可算来了
HTML 转 PDF 不用装浏览器了:等了这么多年,纯 C# 的渲染引擎可算来了做过服务端 PDF 生成的同学,大概都经历过这样的崩溃时刻: 凌晨三点告警——Docker 容器 OOM。排查半天,发现是某个报表服务跑了十几个 Puppeteer 实例,每个吃 300MB 内存,峰值直接把机器打穿。 更恶心的是部署。你要在 Alpine 镜像里塞一个 300MB 的 Chromium,处理各种依赖冲突,CI 里要加 --no-sandbox,K8s 里要考虑共享内存……你只是想生成一张 PDF 发票,但运维同事看你的眼神像在看一个恐怖分子。 Playwright、Puppeteer、wkhtmltopdf、WeasyPrint……工具不少,但它们有一个共同的问题:本质上都是「启动一个完整浏览器,让它帮你画一帧」。 如果是为了渲染复杂交互页面,这没问题。但如果你只是想把一段 HTML 模板转成 PDF——发票、报表、合同、证书——杀鸡真的不用牛刀。
最近发现了PaperSharp,一个 .NET 生态的纯托管 HTML/CSS → PDF/图片渲染引擎。 它的核心主张很简单:把 CSS 排版引擎直接编译进你的 .NET 进程,不调任何外部浏览器。 项目地址: Gitee(国内可达):https://gitee.com/SpringHgui/papersharp GitHub:https://github.com/SpringHgui/papersharp NuGet 包名 PaperSharp,安装一行搞定: 然后用起来是这样的: 两行。一个矢量 PDF,一个高清 PNG。 没有子进程,没有端口监听,没有内存黑洞。它就是你的类库里的一个方法调用。 在线体验 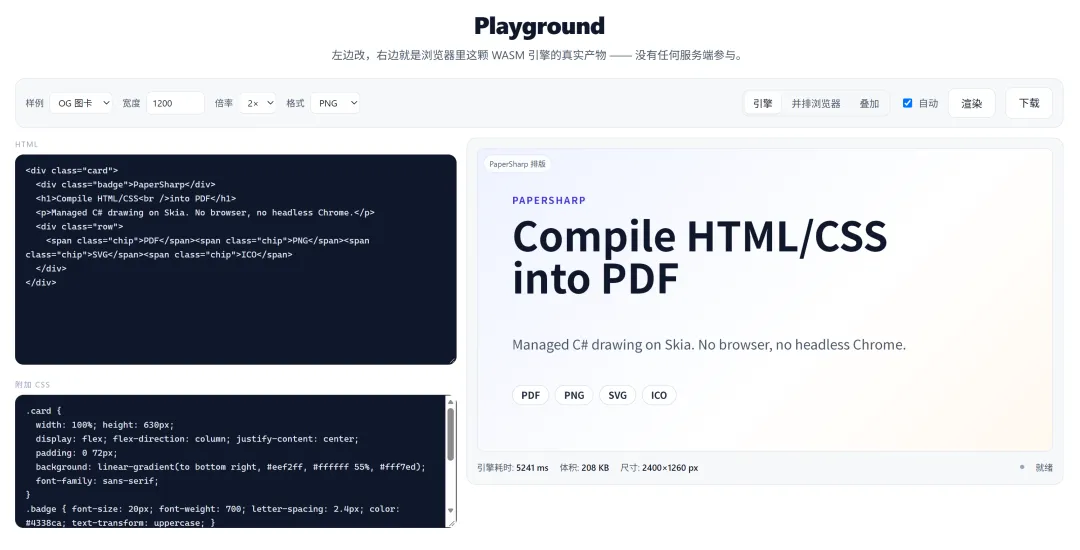
用过 iText 或者 PDFSharp 的人都知道,中文 PDF 生成的痛点不只是「能渲染」——而是排版语义。 PaperSharp 在这方面的处理让我印象深刻: 逐字级 CJK 断行:中文字符不会在行中间被截断成半字 汉字页码:counter(page, cjk-ideographic) 直接输出「壹 / 贰 / 叁」 字形级字体子集化:一页纯文本发票只有 50–120KB,而且文字可选中、可搜索 举个实际例子。一个跨页长表格,表头自动重复,中文数字页码,表格行不被拆散——全是一个 CSS 搞定: 这种打印级语义,大部分 PDF 库做不到,浏览器能但代价太大。PaperSharp 把它做到了原生。
性能数据(README 实测): 单页 PDF 中位耗时~30ms 单线程吞吐~40 页/秒 线程安全,可直接并发处理多请求 对比一下:一个典型 Puppeteer 实例生成单页 PDF 大约 200–800ms,而且并发能力极差(每个实例一个 Chrome 进程)。 这不是一个量级的差距。 而且因为是纯托管代码,在 .NET 进程内跑 GC、内存可控、不需要管理外部进程生命周期。部署到 K8s 里就是一个普通的 .NET Pod,不需要特殊 volume 挂载 /dev/shm。
同样的输入,永远产出 byte-identical 的结果。 别小看这一点。在电子发票、合同、审计报表这类场景里,「可复现」意味着合规。浏览器渲染受 GPU 驱动、字体 hinting、OS 版本影响——同一份 HTML 在 Windows 和 Linux 上像素级不一致。 PaperSharp 默认离线,不请求网络资源,渲染管线全在自己控制下。这意味着你可以做 snapshot 测试、可以存哈希做审计、可以让 QA 环境完美复现生产结果。
假设你要做一个「季度财务报表」PDF 导出功能: 几百行的财务表格自动跨页、表头重复、页码生成、水印页眉——全搞定。
快速过一遍能力范围: 布局引擎:block flow、flexbox(含 wrap/reverse/gap/嵌套)、Grid 子集、表格、浮动 + 文字环绕、定位 视觉效果:渐变(线性/径向/锥形)、圆角(含 squircle)、阴影、透明度、混合模式、clip-path、filter 链 复杂文字:HarfBuzz 阿拉伯文整形、RTL/bidi、grapheme 安全断行(emoji ZWJ) 伪元素:::before/::after + attr() + counter()/counters() PDF 增强:h1–h6 书签、可点击链接标注、文档元数据 多格式输出:PDF / PNG / JPEG / WebP / ICO / SVG JS/WASM SDK:编译到 WebAssembly,在 Node.js/Bun 里调用(甚至可以给前端直接用)
用 .NET 后端的业务系统——发票、合同、报表、证书,凡是需要 PDF 导出的 被 Headless Chrome 折磨过的运维——容器瘦身、消除子进程管理 做文档/打印类产品的独立开发者——HTML/CSS 模板 = 用户可编辑的 WYSIWYG 需要确定性渲染的合规场景——审计、金融、政务 如果你用的是 Python/Node/Go,目前还没直接受益(npm 包有 WASM 版但成熟度不同)。但如果你是 .NET 生态——这就是你等的那个东西。
它不是浏览器。不执行 JavaScript,不支持 ``、Web Components、Service Worker。复杂动态页面它搞不了。 CSS 覆盖度是「子集」不是全部。Grid 只支持一部分,某些冷门属性会 fallback 或忽略。 项目还在活跃开发中(MIT 协议),API 可能有 breaking change。 但对于**「模板 → PDF」这个垂直场景**——发票、报告、合同——它的覆盖度已经非常实用了。
我其实一直在等 .NET 生态出现这样一个东西。不是「又一个封装 iText 的库」,而是真正理解了 CSS 打印语义、从零实现了排版管线、把浏览器能力裁剪到恰好够用的引擎。 PaperSharp 目前做到这一步了。虽然还年轻,但方向是对的。 觉得有用的话,去点个 Star: Gitee → https://gitee.com/SpringHgui/papersharp GitHub → https://github.com/SpringHgui/papersharp
服务器内存又被 Chromium 吃掉了?
PaperSharp:不装浏览器,两行代码出 PDF
dotnet add package PaperSharpusing PaperSharp;byte[] pdf = Renderer.RenderPdf(html, css);byte[] png = Renderer.RenderPng(html, css, width: 794, scale: 2);
https://papersharp.netlify.app
在线测试papersharp的渲染能力,浏览器使用WASM 实现前端浏览器直接运行c#代码,生成速度会额外增加,只用于演示。
杀手级特性一:原生中文排版
@page {@bottom-right {content: counter(page, cjk-ideographic) ” / ” counter(pages) ” 页”}}thead { display: table-header-group }tr { break-inside: avoid }
杀手级特性二:30ms 一页,线程安全
杀手级特性三:确定性输出
怎么用?一个完整例子
using PaperSharp;var html = """2026 Q3 财务报表科目金额营业收入¥12,345,678.00<!-- 几百行... -->""";var css = """@page { size: A4; margin: 25mm 20mm;@top-center { content: ”机密文件”; font-size: 8pt; color: #999 }@bottom-center { content: ”第 ” counter(page) ” 页 / 共 ” counter(pages) ” 页” }}table { border-collapse: collapse; width: 100% }thead { display: table-header-group }tr { break-inside: avoid }td, th { padding: 6px 12px; border: 1px solid #ddd }""";byte[] pdf = Renderer.RenderPdf(html, css);// → 直接写响应流或存对象存储