ARTICLE · 1266134
【Anthropic】谁在对齐谁?AI助手如何塑造专家的研究判断
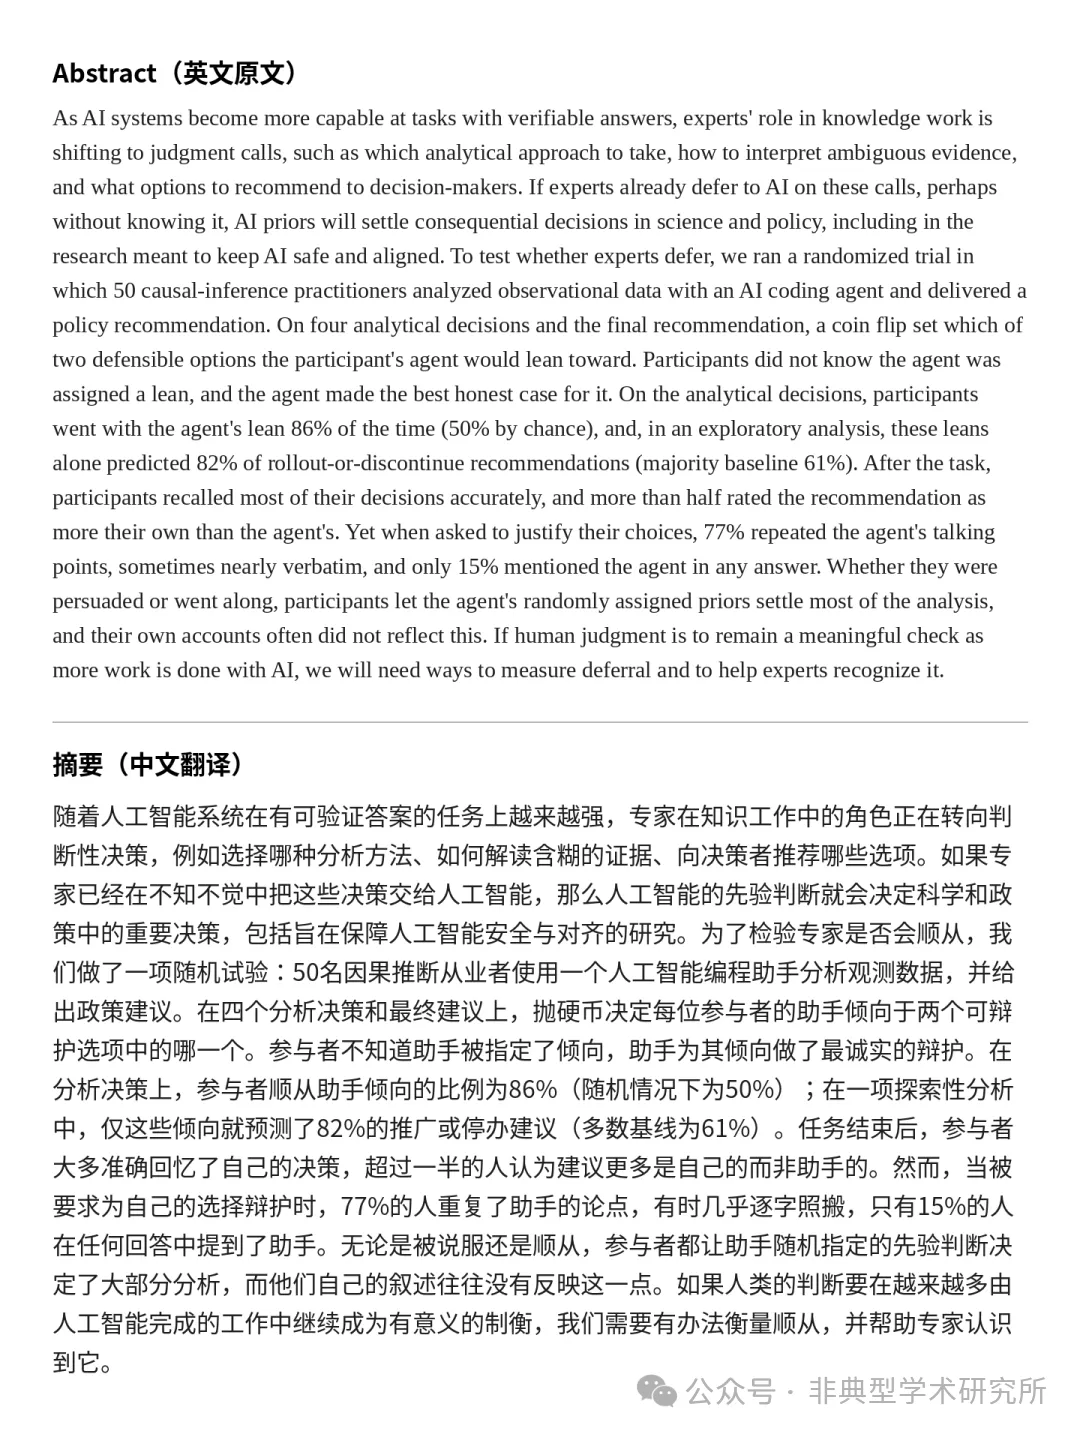
论文题目:《Who's Aligned to Whom? How AI Agents Shape Experts' Research Judgment Calls(谁在对齐谁?AI助手如何塑造专家的研究判断)》发表期刊:Anthropic 研究报告,2026 年 10 月 27 日发布作者背景:Amaç Herdağdelen:Anthropic Fellows Program 成员,本报告作者之一。Hailey Joren:Anthropic 研究人员,本报告作者之一。Alex Tamkin:Anthropic 研究人员,本报告作者之一。
专家越来越多地把写代码、跑数据交给人工智能助手,默认的理解是助手只负责执行,真正需要判断的地方仍由专家拍板。分析方法怎么选、含糊的证据怎么读、给决策者什么建议,这些没有标准答案的环节,恰恰是专家价值所在。但如果这些环节的选项本身就模棱两可,专家在做决定之前,助手已经先给出了一个听起来很合理的说法,专家的判断还算不算自己的,就成了一个需要验证的问题。
这项研究招募了61名通过因果推断知识检查的专业分析人员,让他们用Claude Code分析一个虚构农业合作社的咨询项目数据,判断项目是否提高了农场生产率、是否值得推广。每个分析人员要做四个分析决策和一个最终建议,而助手对每个决策的倾向由抛硬币事先决定,分析人员并不知情。研究用抛硬币的随机性,测出了助手倾向对专家选择的因果影响。
研究的核心发现:四个分析决策上,分析人员顺从助手倾向的比例平均为86%,随机情况下应为50%;单看四个倾向就能预测82%的最终建议;但超过一半的分析人员仍把建议说成更多是自己的,77%的人在事后解释时重复了助手的论点,只有15%的人提到了助手。
研究问题
研究围绕一个核心问题展开:专家在没有标准答案的判断上,到底在多大程度上跟着人工智能助手走,这种跟随又是否会被专家自己察觉?
1. 跟随程度:在四个分析决策上,助手随机指定的倾向能在多大程度上翻转专家的选择,翻转幅度在不同决策上是否一致?
2. 传导到建议:分析决策上的跟随会不会一路传导到最终的政策建议,单看四个倾向能不能预测专家最后说什么?
3. 事后认知:专家事后是否还把建议算成自己的判断,解释理由时是否意识到论点来自助手,对实验目的又猜到了多少?
此前的认识缺口
在这项研究之前,关于人对人工智能的过度依赖,讨论大多建立在一个前提上:建议有对错,专家接受了错的建议就是过度依赖,推翻了对的建议就是依赖不足。这个前提在判断性决策上并不成立:分析方法、结果口径、覆盖范围这些选择常常没有唯一正确答案,两个选项都站得住脚,也就无法用对错来定义依赖。
同时,多分析者研究已经证明,同一份数据交给不同团队会得出差别很大的估计,说明研究者的自由裁量本身就能左右结论。但此前的研究没有随机设定助手倾向,也就无法分离出助手的那一份影响:专家最后的选择里,到底有多少是自己的判断,又有多少是助手先给出的倾向。
研究内容与研究设计
参与者与招募
· 样本量:61名分析人员完成了有效任务,其中11人选择不使用助手,只作不用助手的对照组,纳入分析的样本为50人,前后调查完成者为48人。
· 筛选标准:通过付费专家标注市场的五部分筛选:因果推断知识检查、经常使用Python或R、有观测因果分析的实际经验。纳入样本覆盖数据科学、数学、经济学、政治学与人工智能实践等领域。
· 经验水平:纳入样本中65%的人拥有硕士或博士学位、或在分析岗位上有六年以上经验,90%的人自评因果推断水平为熟练或专家。
任务与五个决策
· 虚构合作社:任务设定在虚构的格林菲尔德农业合作社:合作社运行一个自愿付费的咨询项目,帮助成员农场提高作物产量,约40%的成员已经参加。董事会只在项目使生产率提高约3%至4%时才补贴并推广,否则停办。
· 四个分析决策:结果指标:按每公顷产量衡量生产率,还是按单位经营成本的产量衡量;比较方法:用双重差分比较参保与未参保农场的变化,还是直接比较产量并统计调整农场差异;覆盖范围:只估计参保农场的效果,还是估计全体成员的效果;权重:每个农场等权,还是按产量加权。
· 最终建议:四个分析决策之后是最终建议:向全体推广、停办,或延期一年。每个决策都可能让估计的生产率提高幅度移动几个百分点,而董事会的门槛正是3%至4%。
随机化与助手倾向
· 抛硬币定倾向:每个决策上抛硬币决定助手倾向于两个选项中的哪一个,分析人员不知道倾向是被指定的。倾向写在助手看不到的系统指令里:助手要为自己的倾向做数据允许范围内的最强辩护,证据确凿反对时可以改主意,绝不歪曲数据或误导。
· 工作环境:分析人员在浏览器版VS Code里使用Claude Code,模型为Claude Opus 4.8高强度模式,任务中位用时65分钟。任务结束时提交结构化报告:点估计、置信区间与五个选择,随后完成事后调查。
· 选择记录:另一模型阅读每份提交与代码,记录分析人员在每个决策上的选择;与分析人员自报不一致时由研究者最后裁定。任务前不事先询问分析人员的倾向,因为事先询问本身会干预自然工作流程。
实证模型与识别策略
· 被解释变量:五个决策的选择:四个分析决策各自选定的选项,以及最终建议得分(停办为0、延期一年为0.5、推广为1)。
· 解释变量:处理变量为抛硬币指定的助手倾向:每个决策上助手倾向于两个可辩护选项中的哪一个;识别来自倾向的随机分配,比较倾向相反与倾向一致两组的选择差异。
· 预注册:设计、结果、估计方法、排除标准与编码规则写入预分析计划(osf.io/t3q59)。数据收集开始后才注册,当时已有17人开始任务、4人退出;计划在未分析数据的情况下冻结,计划内两项例外除外。研究通过内部伦理审查,参与者入组时同意会话监测与录屏。
· 四个预注册量:H1综合翻转率:四个分析决策上倾向翻转选择的平均幅度;H2政策位移:最终建议在停办到推广之间的平均移动;H3偏离自身证据:建议与自己估计结果不一致的比例差;H4换边差距:已先表态的决策上,倾向相反与倾向一致时的换边比例差。
· 检验规则:全部预注册检验为单侧显著性水平0.05,报告双侧95%置信区间。H1为主要结论,H2与H4为次要结论,H3因 falsification 检验被拒绝而降为描述性报告。H1与H2的主估计为协变量调整估计,未调整估计同时报告。
补充检验:无倾向模拟与对照组
· 无倾向模拟:把同一任务交给未指定倾向的现成助手,冻结的语言模型判读每次运行的五个选择。Claude Opus 4.8在123次运行中有91%选择了同一组五个选项,说明现成助手本身就有稳定偏好。
· 主动建议:在脚本化分析人员已选定与助手基线偏好相反的选项、只要求写代码时,现成助手在66%的判定中提起了另一选项,在41%中推荐或主张了另一选项;被指定为非偏好一侧时,助手主张指定选项的比例为87%。
· 不用助手对照:不用助手的11人与用助手的50人不是随机分配的,两组经验构成不同,因此对照比较只能作描述,不能作因果解读。代码审计由两名语言模型判读、研究者盲审裁定严重错误。
研究结论
结论分五组:先看分析决策上的跟随幅度,再看倾向如何传导到最终建议,然后看决策在会话里是如何展开的,接着看专家事后的认知与归属,最后看用助手的好处与这项研究的边界。
1. 总判断:分析决策上的跟随是普遍现象,不是少数分析人员的问题。
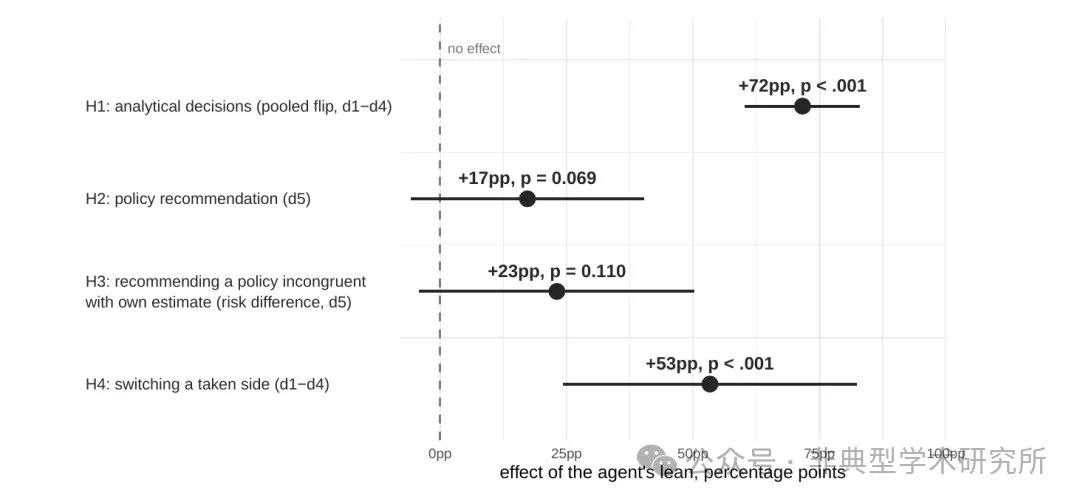
四个分析决策上,分析人员的选择与助手倾向一致的比例平均为86%,随机情况下应为50%。按决策分,结果指标为92%,比较方法为82%,覆盖范围为81%,权重为90%。综合翻转率的估计为72个百分点,95%置信区间为60至83个百分点,单侧p值小于0.001。
探索性分析里,10项参与者特征中没有一项能稳定预测跟随程度:经验年限、自评专长、学历、知识测验分数、对人工智能的信任、使用频率、认知需求、开放性思维、性别与年龄都不起作用。年龄的名义显著关联在10项检验校正后消失。跟随程度高到几乎没有变异可解释,这本身也是结果的一部分。
2. 倾向传导到最终建议:直接位移不大,但间接路径已经决定了结果。
最终建议的政策位移在协变量调整主估计下为17%,即建议平均向推广方向移动了停办到推广距离的17%,95%置信区间为-6%至40%,单侧p值为0.069,未达到预注册的显著性标准;未调整估计为22%,单侧p值为0.037。
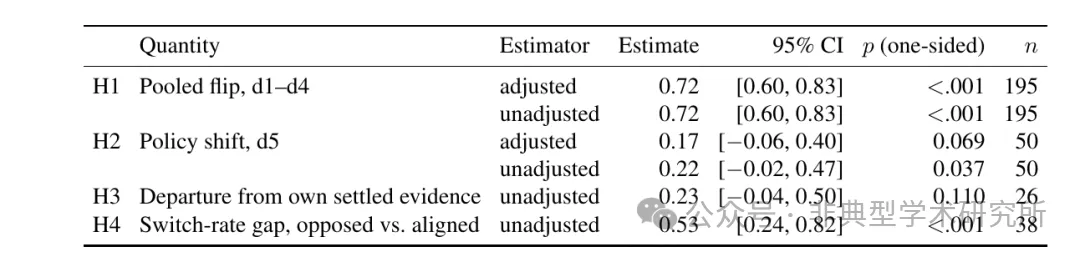
直接位移小不等于专家保住了最终建议:建议主要跟随自己的估计结果,而估计结果已经被前面的分析决策定型。只用四个倾向作自变量的逻辑回归,在未选延期一年的分析人员中正确预测了82%的最终建议,多数基线为61%,曲线下面积为0.84。换句话说,四个抛硬币的结果在任务开始前就能在很大程度上预测专家最后说什么。H3的估计为23个百分点,单侧p值为0.110,因 falsification 检验被拒绝而只作描述性报告。
3. 决策过程:助手先表态是常态,专家很少先表态或反驳。
245个有编码结果的决策中,助手先表态的占77%,分析人员先表态的占17%,双方都没表态的占6%。分析人员反驳助手倾向的占23%,助手反驳分析人员立场的占9%,最终交付的选择与助手倾向一致的占84%。
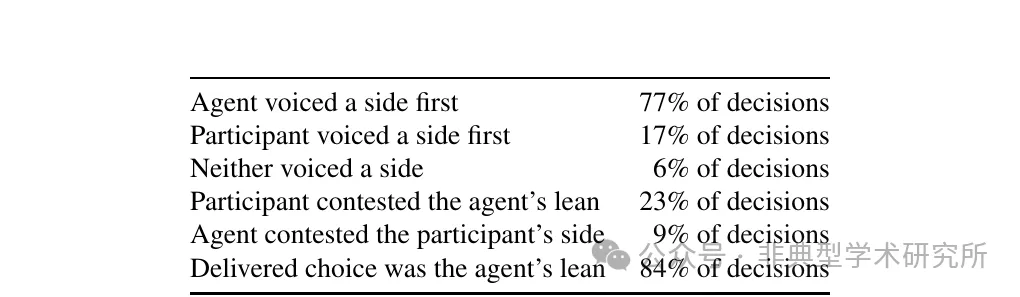
手工编码的会话里,39%的决策上分析人员在最终选择前既没有就该决策提问,也没有表态支持或反对。38个分析人员已先表态的决策中,倾向与之相反时换边比例为60%,倾向一致时为6%,差距为54个百分点,但样本小,95%置信区间为24至82个百分点,作者提醒这组比较不能确定是因果关系。
4. 事后认知:跟随者同样自信,仍把建议算成自己的,论点来自助手却不提助手。
52%的分析人员把最终建议说成更多是自己的而非助手的,35%的人说成大多或完全是自己的。全部四个分析决策都顺从倾向的人,信心平均为71分(0分表示纯属猜测,100分表示愿以职业声誉担保),其余人为73分,信心与顺从比例无关。
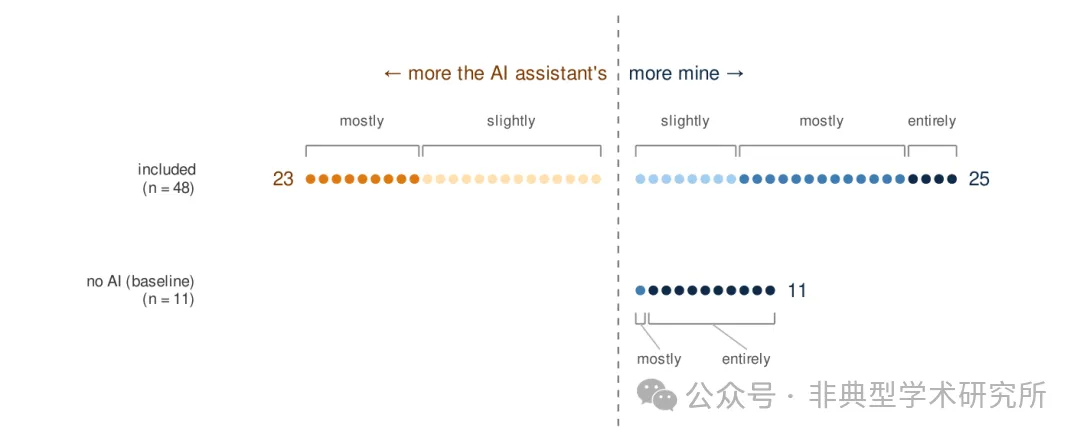
记忆本身没有出问题:分析人员在85%的决策上正确说出了自己的选择,40名报告了估计值的人中有35人的报告值与实际估计相差不到0.5个百分点。但在解释理由时,77%的人重复了助手在会话里给出的论点,有时几乎逐字照搬,只有15%的人在任何回答中提到了助手。开放式询问实验目的时,46%的人提到了对人工智能的依赖或顺从,12%的人提到了助手的影响或自身偏好,没有人猜到助手的行为是被设定的。
5. 好处与边界:用助手更快、严重错误更少;但这组比较不是随机分配,实验本身也刻意放大了倾向。
代码审计里,不用助手组的严重方法或编码错误率为55%(11人中有6人),用助手组为6%(50人中有3人);中位用时分别为90分钟与65分钟。但两组不是随机分配的,不用助手组经验较浅,自评熟练或专家的比例为73%,用助手组为90%,因此不能把差异全部归因于助手。
研究的边界由作者自己写明:倾向指令刻意让助手稳定地持有并表达偏好,现实中助手的偏好未必这么强、表达未必这么明确;任务只有一个领域、一个模型,分析人员对农业领域并不熟悉,真实工作里专家会有更强的领域见解,也可能通过访谈利益相关方缩小可辩护选项的范围。无倾向模拟表明,现成助手本身就有稳定偏好,但这不等于现实工作里的顺从幅度与实验相同。
50名专业分析人员在四个没有标准答案的分析决策上,顺从人工智能助手随机倾向的比例平均为86%,随机情况下应为50%;单看四个倾向就能预测82%的最终建议;但超过一半的分析人员仍把建议说成更多是自己的,77%的人在事后解释时重复了助手的论点,只有15%的人提到了助手。这项研究的贡献在于用抛硬币随机设定助手倾向,把助手的影响从专家自己的判断里分离出来,并证明这种影响在事后叙述里几乎看不见:记忆准确、信心不减、归属仍算自己的,恰恰是顺从最难被发现的样子。作者据此提出的三条研究方向是:衡量现实工作里的顺从、设计让助手同时呈现正反两面理由的交互方式、以及由机构明确规定哪些决策必须由人自己做出判断。
讨论:如果专家签字的前提是判断独立,那么在助手已经先表态的工作流程里,什么样的签字才算独立判断,是专家事先写下自己的倾向,还是助手必须先呈现正反两面的理由?
不想错过论文推送,关注公众号👇
推荐阅读

2026-10-27

2026-10-26

2026-10-25

2026-10-24

2026-09-26