ARTICLE · 1271558
OpenAI重磅研究:今天60%的工作80年前没名字!AI催生的新饭碗还没词
作者 | 周学· 编辑 | 刘进
假如你坐时光机回到1976年
你在街头拦住一个美国小男孩,神秘兮兮地告诉他:“嘿,等你长大后,有一份特别吃香的工作,叫为云端视频流媒体应用优化搜索广告。”
小男孩大概率会觉得你疯了
这怪不得他在1976年的世界里,搜索引擎、智能手机应用和云计算全都尚未诞生。要想给他讲明白这份工作,你得先把未来四十年的科技史从头剧透一遍。
当年那个小男孩叫罗尼·查特吉(Ronnie Chatterji)。如今,他是 OpenAI 的首任首席经济学家。
2026年9月下旬,查特吉与 OpenAI 应用科学家哈里森·萨切尔(Harrison Satcher)在团队官方专栏《AI经济学》上抛出了一篇引起广泛讨论的文章,标题只有冷峻的一句话:《我们还没有那些名词》(We don’t have the nouns yet)。
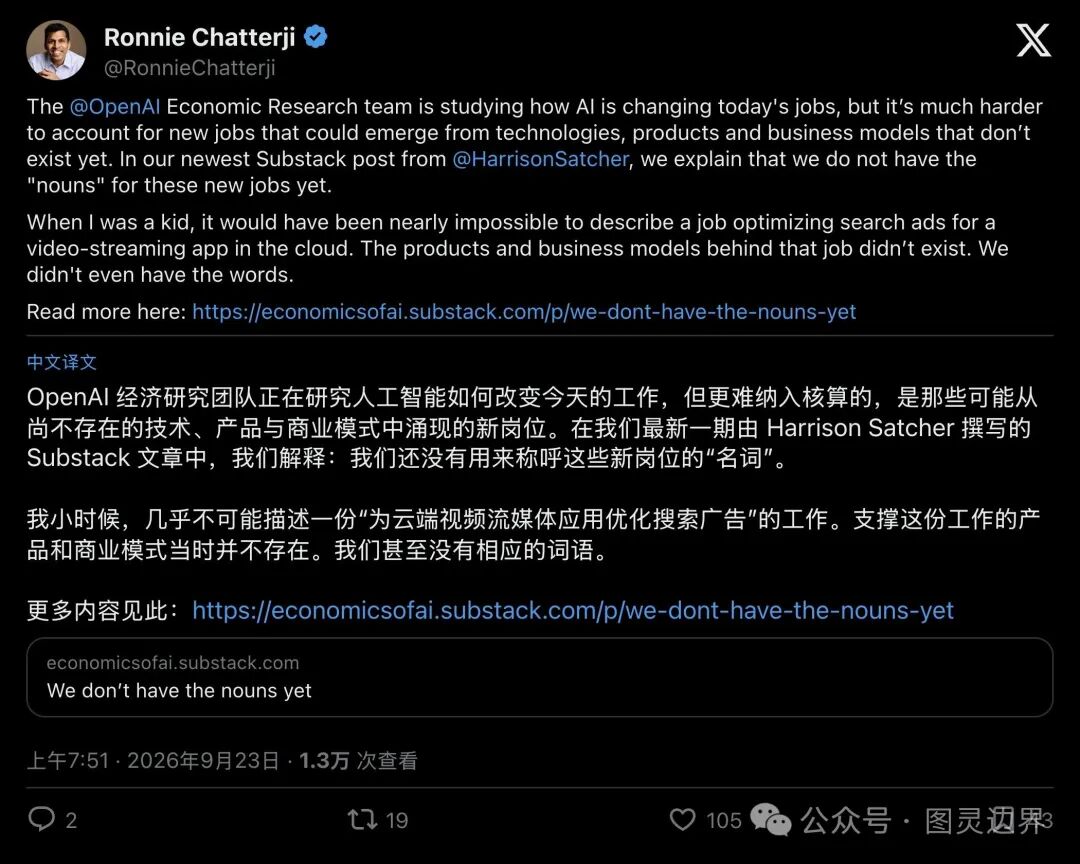
▲ OpenAI 首席经济学家罗尼·查特吉发文导读团队最新研究:人类甚至还没有造出描述未来新岗位的“名词”。
当下,全世界都在拿着放大镜盘算:AI 到底会抢走多少人的饭碗?
但 OpenAI 的经济学家们却捅破了这层窗户纸:今天几乎所有关于 AI 就业的预测,都存在一个致命的算法漏洞。 我们总是很容易算出哪些旧工作会消失,却根本算不出哪些新工作会诞生。原因很简单,那些即将养活数千万人的未来新工作,人类今天连叫它们的“词儿”都还没造出来。
旧饭碗是怎么碎的?那些“没名字”的新工作又是从哪条缝隙里长出来的?我们来一层层拆解这台看不见的就业机器。
01第一层机制:统计学的盲区与“迟到的名词”
为什么每次看到 AI 就业预测报告,大家都会觉得天要塌了?
这要从经济学家最爱用的工具,“曝光度测算”说起。研究人员把今天社会上现有的岗位列成一张大表,拆解成几万个具体动作,然后挨个打钩,看 AI 能替代多少。
这本质上是在做减法想象报社的广告撰稿人失业,不需要任何想象力;但要做加法,去预测一个连产品形态都还不存在的新职业,现有的统计模型瞬间就失灵了。
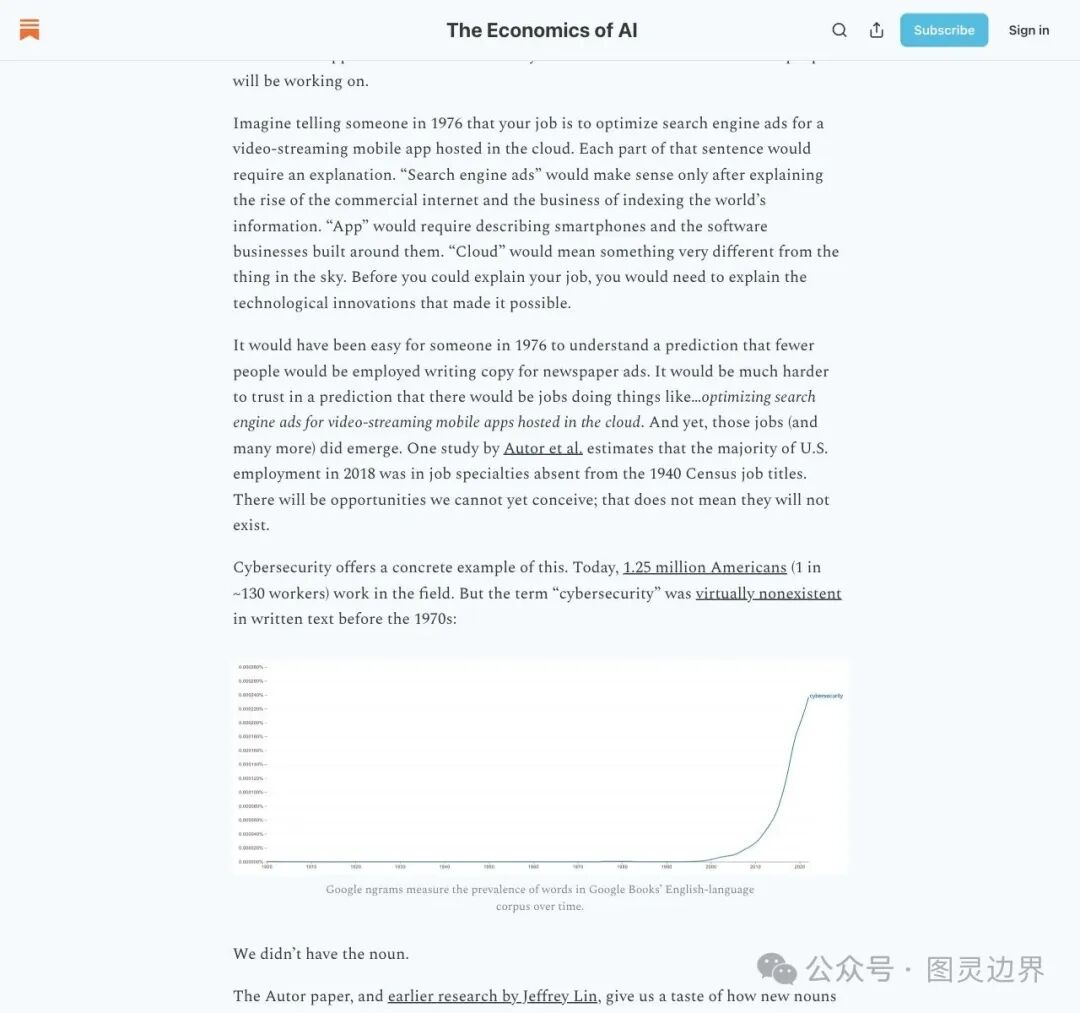
▲ 萨切尔在文章开篇抛出核心质问:“我们如何为无法描述的事物定价?”
这就是“名词”的力量在劳动力市场里,没有名词,就意味着无法被统计、无法写进招聘启事、在宏观经济表里彻底隐形。
看一个最直观的例子:网络安全(Cybersecurity)。今天,每130个美国打工人里就有1个吃这碗饭,全行业养活了125万人。但在1970年代之前的人类书面语料库里,这个词根本不存在。先有了互联网和黑客攻击,最后才迟迟诞生了“网络安全工程师”这个头衔。
这种“没名字的新工作”到底占多大比例?麻省理工学院(MIT)经济学名宿大卫·奥托尔(David Autor)团队做过一项极其硬核的考古。
为了揪出那些还没被官方正式编码的民间新饭碗,奥托尔团队翻烂了美国人口普查局内部供记录员使用的秘密工具书,《职业与行业字母索引》。每十年人口普查时,老百姓会在表格上手写自己五花八门的头衔。一旦记录员发现某个怪名字频繁出现,就会把它增补进《字母索引》。到2018年,这本册子已经攒下了约 35,000 个具体职业头衔。
结果令人瞠目结舌:2018年,大约60%的美国就业人口,干的都是1940年人口普查表里根本不存在的工作!
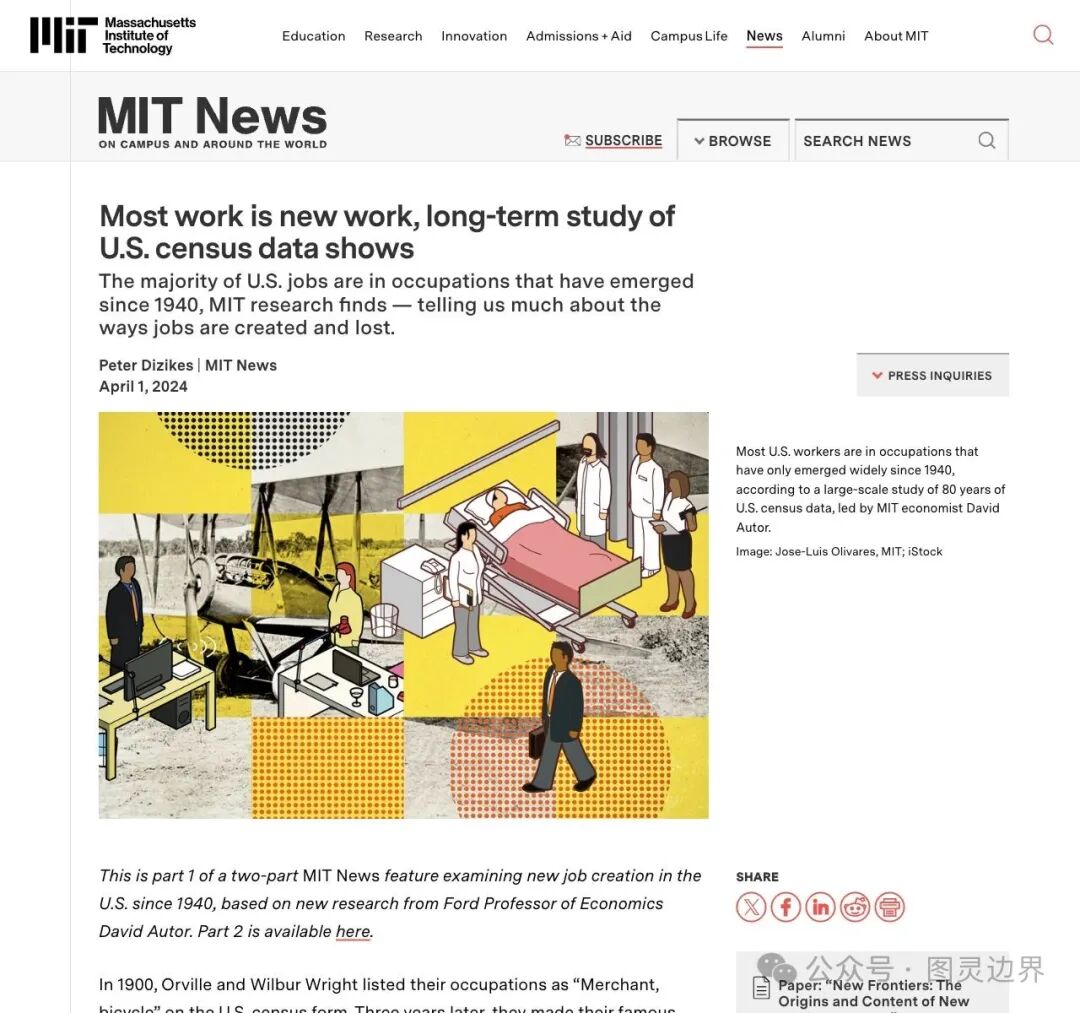
▲ MIT News 专题报道奥托尔团队发表于《经济学季刊》的研究:当今约六成工作都是1940年之后才冒出来的“新物种”。
翻开这本跨度八十年的账本,就像在看一部人类折腾史:
- 1940年代
,商场里第一次装上电动扶梯,人类有了“自动扶梯操作员”; - 1950年代
,民航起飞与城市绿化兴起,催生了“飞机空乘”和“树艺师”; - 2000年代
,初代互联网泡沫与新能源起步,长出了“聊天室主持人”和“风力涡轮机技术员”; - 2010年代
,移动电商与颜值经济爆发,人口普查表里正式写进了“分拣中心助理”、“数据科学家”和“认证贴睫毛师”。
面对这种历史规律,苏黎世大学教授 D. Yanagizawa-Drott 在转发 OpenAI 研究时忍不住感叹:“真正的超级智能,大概就是能准确预测出它自己会创造出哪些新岗位的‘名词’,那得是多么逆天的世界模型。”
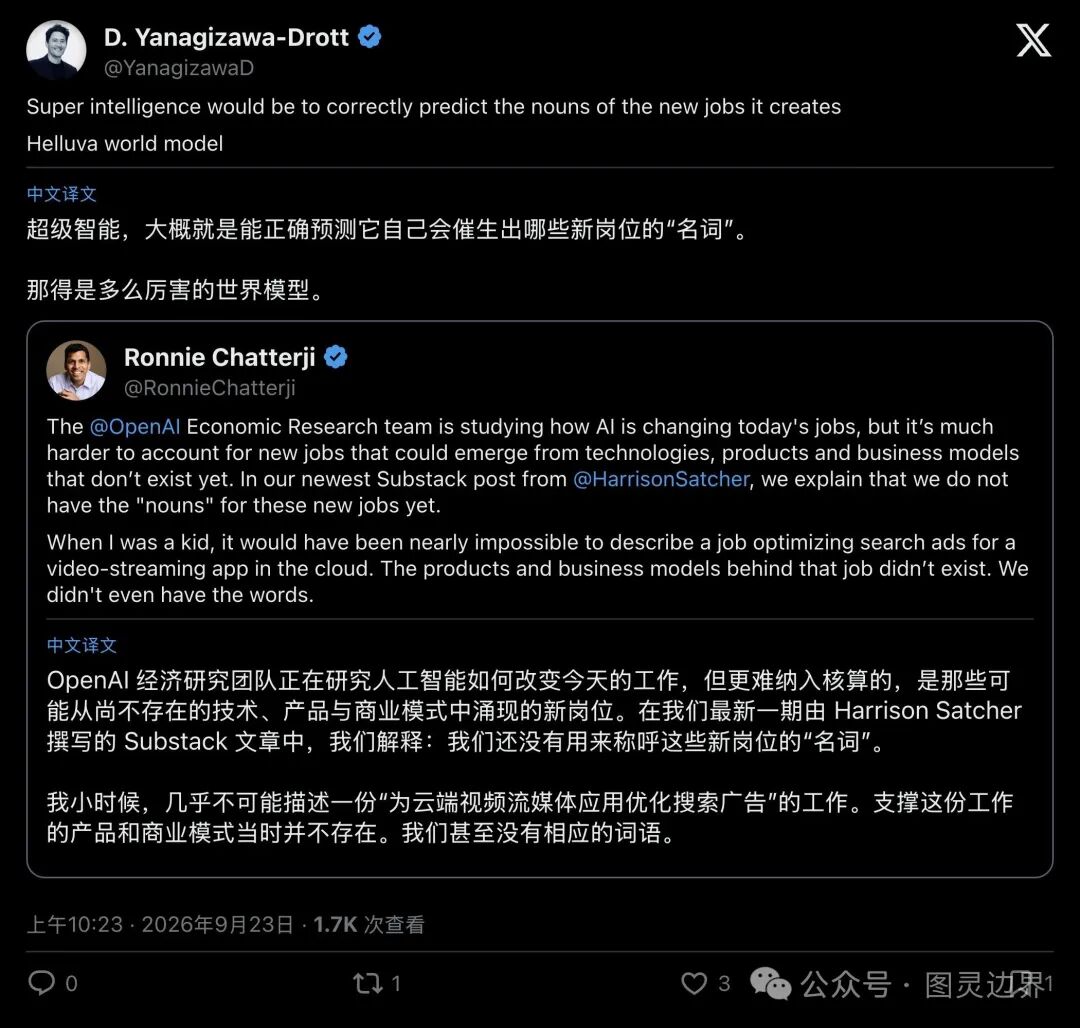
▲ 学者评论:能提前猜中未来新工作的名字,才叫真正的超级智能。
02第二层机制:从“邻近可能”到胶水代码,新饭碗怎么长出来?
你可能会问:现在网上不是已经有很多 AI 岗位了吗?
没错领英(LinkedIn)数据显示,2023到2025年间,全球冒出了约 130万个 AI 相关新岗位,比如数据标注员、前沿部署工程师;电信巨头 T-Mobile 甚至专门招起了“AI 成本管理分析师”;美国非 IT 行业要求具备生成式 AI 技能的招聘启事,短短两年暴增了9倍。
但萨切尔一针见血地指出:这仅仅是故事的前半段。 因为这些岗位,还只是围着“已经造出来的模型”打转。
真正庞大的下半场,藏在两个精密的演化机制里。
第一个机制,叫“邻近可能”(Adjacent Possible)。这是复杂性科学家斯图尔特·考夫曼提出的概念:每一项新发明,都会像推开一扇暗门一样,改变你下一步能造出什么东西。
想想看,人类先造出了火箭,火箭让发射卫星成为可能;卫星上天,才有了 GPS 定位;等到 GPS 撞上智能手机,突然催生出了网约车与外卖软件。而这一个小小的软件,瞬间在地面上变出了成百上千万个软件交互设计、算法调度、地推销售与专车司机的饭碗。如果你让1950年代造火箭的工程师去预测“网约车调度员”,他哪怕把脑子想破也算不出这条价值链。
那么,在技术落地的微观瞬间,新岗位究竟卡在哪一秒诞生?
在查特吉的推文下,网友 @ADLXBT 用一句话道破了天机:“新角色通常在 API(应用程序接口)层稳定之后才会涌现,因为这时第三方终于可以编写定义这份工作的‘胶水代码’了。”
▲ 高赞评论一语道破技术转化为职业的瞬间:底层接口稳定后,打通业务的“胶水层”就是新饭碗的温床。
说白了,底层大模型就像刚通电的高压电网,普通企业根本不敢直接用手摸。谁能站在高压电和泥泞的传统业务之间,写出一层把两边粘起来的“胶水流程”,谁的动作就会沉淀为一个全新的工种。2025年的一项全球调查就是明证:36%的网络安全从业者起初并未读过相关专业,他们原本干着普通 IT 活儿,顺手接了点安全杂活,干着干着,试出了一个新饭碗。
这些新饭碗还极其“挑地方”费城联储经济学家林杰弗里(Jeffrey Lin)追踪了数十年《职业名称词典》的修订记录后发现,新工作高度聚集在高学历人口密集、且产业门类五花八门的大都市。经济学上管这叫“雅各布斯外部性”,只有让写代码的、搞金融的、拍短剧的和做医疗的人每天在同一条街上喝咖啡、跨界碰撞,杂交出来的古怪需求,才会长成新职业。
03第三层机制:财富溢出与注意力稀缺,AI催生的工作未必姓“AI”
拆解到这里,全篇最反直觉的转折来了:AI 时代催生的新工作,一定得跟 AI 有关吗?
答案是:很可能毫无关系
在《大西洋月刊》紧随其后发表的深度报道《非 AI 的 AI 岗位》中,记者安妮·劳里与耶鲁大学预算实验室执行主任玛莎·金贝尔(Martha Gimbel)撕开了另一幅图景。
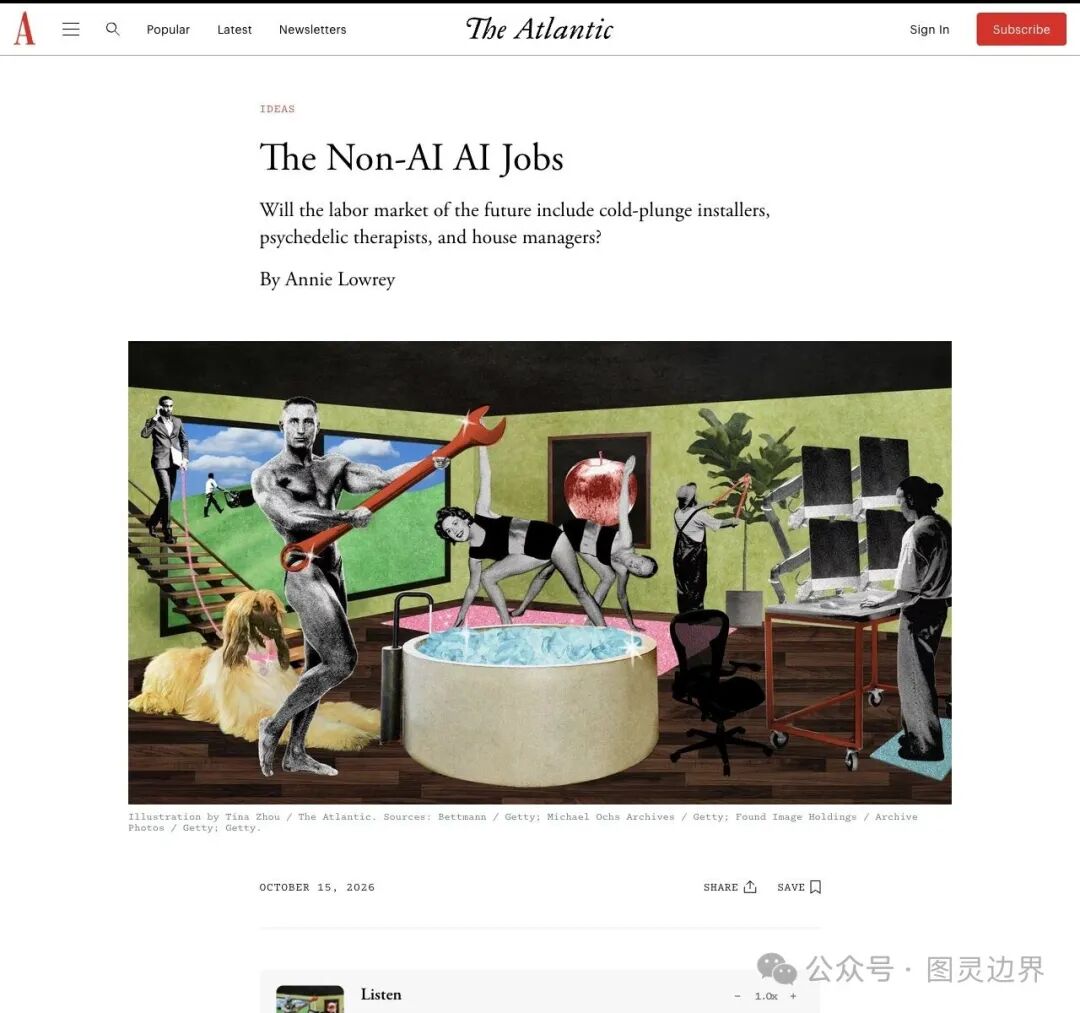
▲ 《大西洋月刊》撰文探讨:AI 造富之后,未来的热门新工作可能是冷水浴安装工与家庭事务经理。
她们把技术引发的就业洗牌拆成三阶:
- 一阶效应
看得见摸得着:呼叫中心客服减少,数据中心电工和算法专家暴增; - 二阶效应
是外围衍生:比如深伪(Deepfake)调查员、AI 风险核保人; - 三阶效应
最容易被忽略,叫“财富岗位”。
金贝尔讲了一个让人忍俊不禁的洞察:当技术进步让社会变得更富有时,人类赚了钱,一定会花在老一辈人觉得极其荒唐的事情上。 比如请婚礼策划师、花高价练 CrossFit、请私宅冷水浴安装工,甚至餐厅里出现了专门帮客人搭配矿泉水的“水侍酒师”。
金贝尔调侃道:“每次我们跟父母辈提起这些花销,老一辈第一反应都是‘太败家了!’但停顿两秒后,他们又会忍不住问一句:‘那……体验真的爽吗?’”
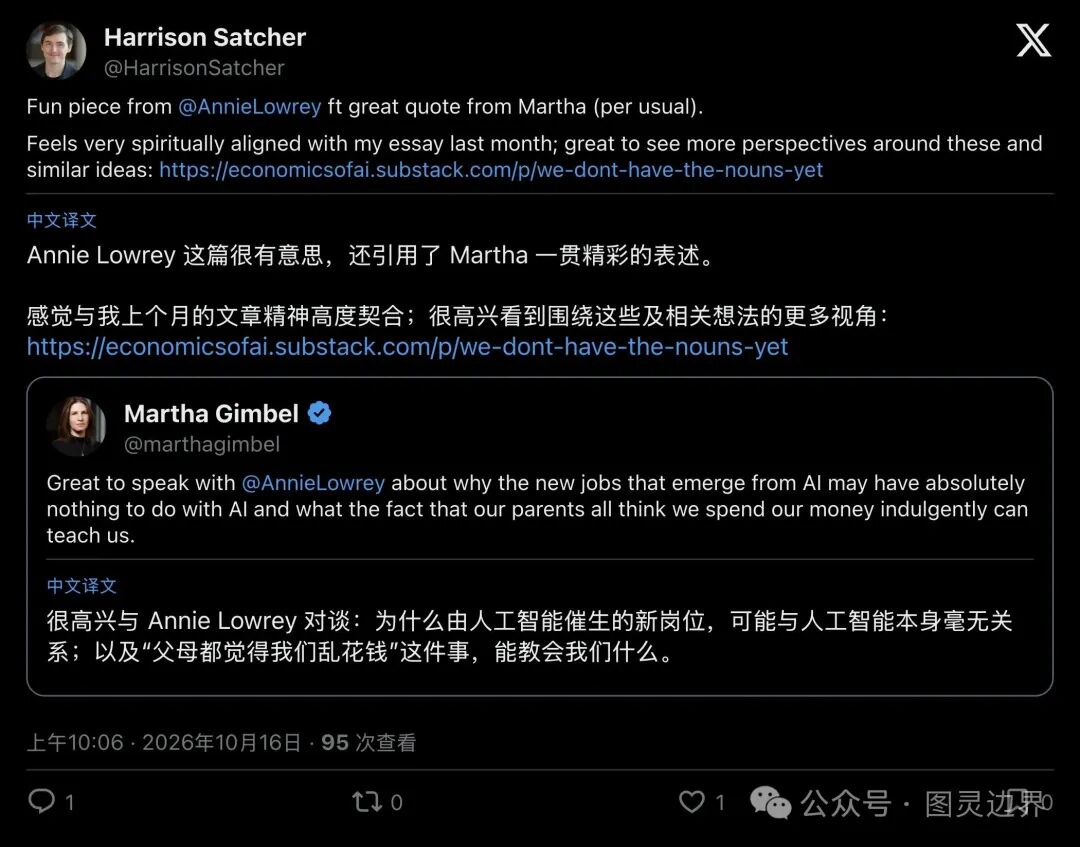
▲ 萨切尔转发金贝尔与《大西洋月刊》的讨论,称其与“没有名词”的研究精神高度契合。
这种现象背后有着被历史反复验证的铁律。奥托尔团队通过自然语言处理技术,把1920年以来的美国专利文本与人口普查职业做匹配后发现:1980年之后,新增岗位一直在向两极分化,一头是高精尖的技术专家,另一头正是围绕人的身体、情绪与体验打转的个人服务与健康照料。
这也恰好印证了 OpenAI 经济研究团队在8月发表的另一篇姊妹篇长文:《当智能变得丰裕,我们需要的是注意力》。
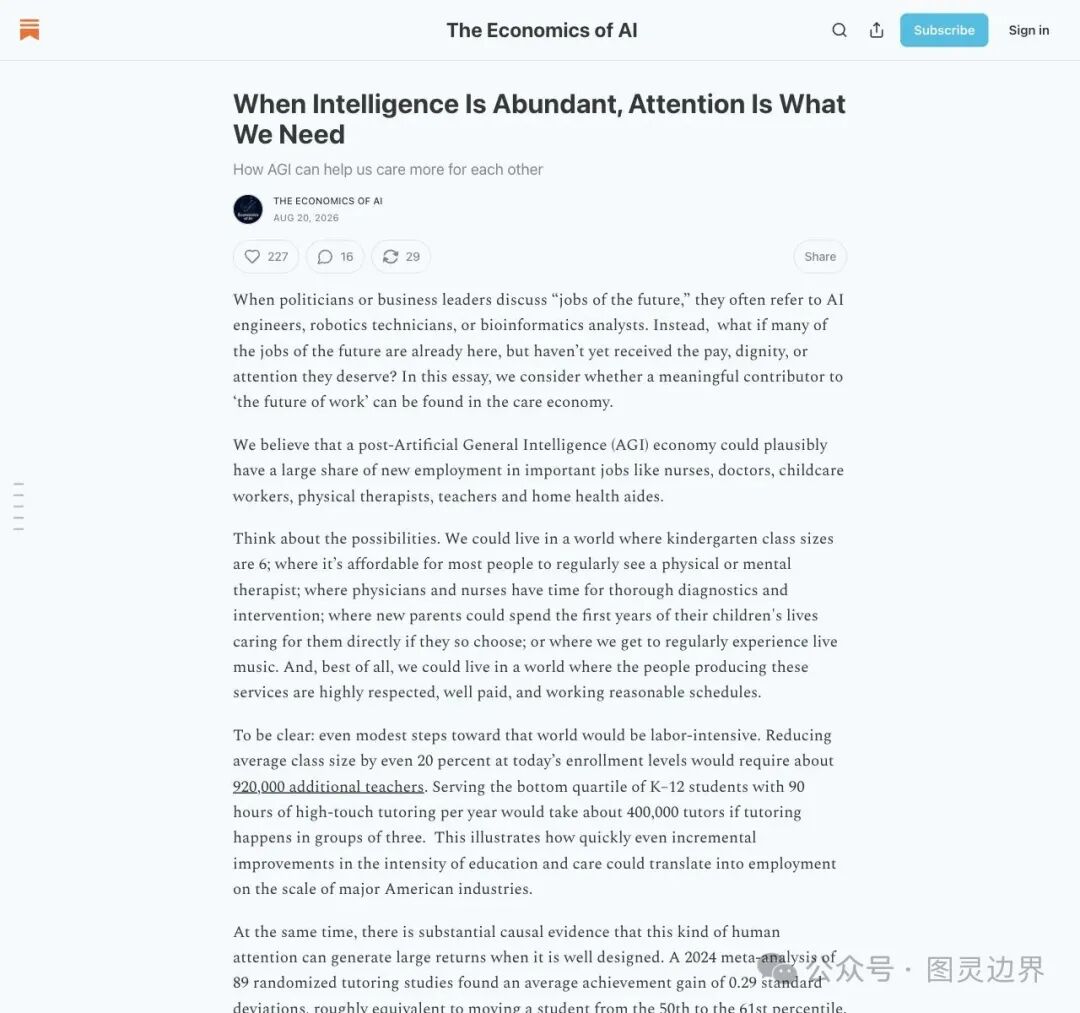
▲ OpenAI 团队另一篇重磅文章指出:当智能变得像自来水一样便宜,人类的“注意力与在场”将成为最昂贵的稀缺品。
商业世界最底层的定价逻辑永远只有一条:什么稀缺,什么就贵。
当通用人工智能把“算力与智力”变成像自来水一样廉价的基础设施时,什么东西是显卡集群绝对造不出来的?是人类的真实注意力,是人与人面对面的温度与在场。
把幼儿园的班级规模砍半、给落后的学生提供一对一高强度辅导、更耐心的慢病问诊、老年居家陪护、心理创伤治疗……算力可以无限复制,但握住一位老人的手、倾听一个孩子的委屈,永远无法被自动化压缩。
04尾声:在词典追上现实之前,人们还得吃饭
读懂了这三层机制,我们该彻底高枕无忧了吗?
恰恰相反看清历史的长期乐观,绝不能用来掩盖眼前的短期残酷。
奥托尔的专利匹配数据里藏着一个极其冰冷的警告:1980年至2018年间,替代型自动化对旧岗位的摧毁力度,比前四十年扩大了一倍以上;而同期技术创造新岗位的速度,却没有同比例加快。
这就是历史最残忍的地方:宏观账本上的“动态平衡”,落到微观个体头上,往往是一代人的颠沛流离。因为新长出来的工作,几乎从来不会在同一时间、同一座城市,原封不动地发给刚刚失业的那批人。
社交平台上,一条被反复转发的评论一针见血地戳中了现实痛点:在词典追上现实、为那些还没名字的新工作赋予头衔之前,普通人依然面对着真金白银的生计压力,每天都得吃饭。
这或许才是 OpenAI 这份研究留给每个普通人最毒辣的启示:
永远不要等着某个新职业被写进大学专业目录、写进官方统计词典里,才去考证入行。 等一个工作有了标准化的“名词”,它的第一波红利往往已经吃尽了。
在未来的词典印出来之前,真正的逃生通道只有两条:要么站在旧业务与新 AI 的裂缝之间,动手去写那层连接现实的“胶水”;要么转身扎进算法永远无法模拟的深水区,去经营那些需要人类滚烫注意力与信任的事业。