ARTICLE · 1272870
AI智慧预问诊系统要不要接 AI 大模型?采集工具和生成能力的边界(SpringBoot+UniApp源码交付)
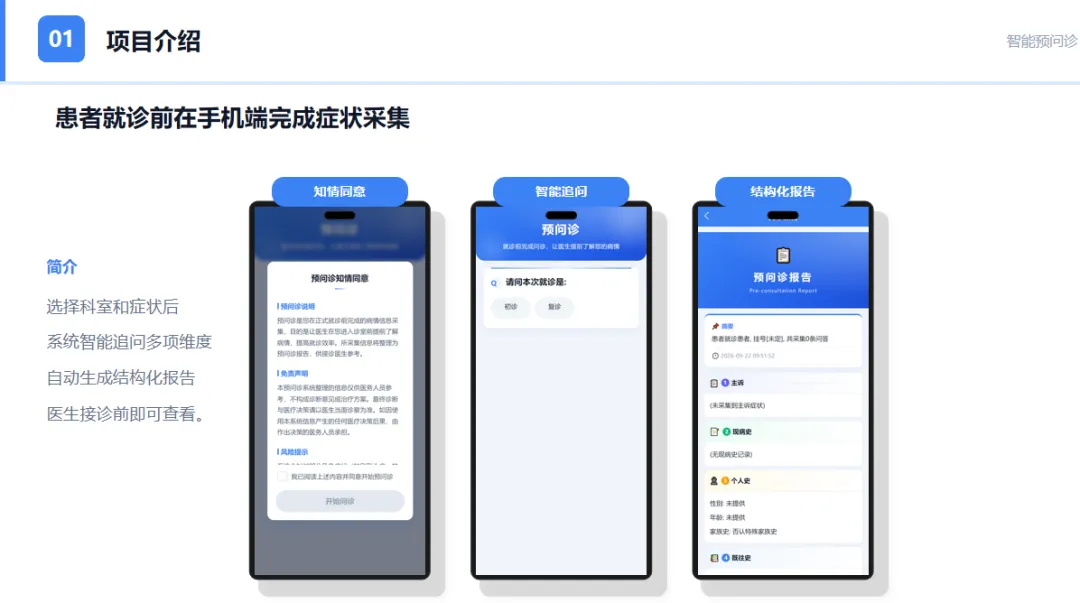
智能预问诊系统,本质是一套面向门诊与互联网医院场景的就诊前病史信息采集工具。这两年"AI 问诊"的概念很火,采购方评估方案时几乎都会问:你们接大模型了吗?接了是不是更智能?不接是不是就落后了?
这篇文章把这个问题讲清楚:大模型适合做什么、不适合做什么,结构化采集为什么依然是预问诊的主流做法,以及采购方怎么判断一个方案里的 AI 成分。
一、先分清两类"AI 问诊"产品
市面上叫"AI 预问诊"的产品,其实是两种完全不同的东西:
两种形态都能做,但性质完全不同。对采购方来说,关键不是哪个"更先进",而是哪个的责任边界更清楚。
二、大模型在预问诊里的正确位置
大模型不是不能用,而是要用在对的环节:
一句话:大模型适合在后台帮运营的人,不适合在患者端替系统说话。
三、大模型不适合做什么
不适合生成呈现给医生的内容。预问诊记录的价值在于"患者真实说了什么",大模型的输出是概率生成,改写、概括、遗漏都可能发生。一份被 AI 加工过的记录,医生没法确定哪句是患者原话、哪句是模型补的,可追溯性就没了。采集工具坚持原样记录、原样呈现,正是为了守住这条底线。
不适合承载"判断"类期待。有些方案宣传"AI 自动分析病情、给出提示",听起来能力强,实际是把产品推向了另一个性质:判断类功能在监管上是另一回事,采购方等于把风险买回了家。
用一段示意代码说明两种处理方式的差别:
# 结构化采集的处理方式(示意):只记录,不生成patient_said = "这两天咳嗽,晚上更厉害,有点痰"record = { "content": patient_said, # 原样保存 "display": patient_said, # 原样呈现,不做改写}# 生成式方案的处理方式:内容经过模型加工# record = model_rewrite(patient_said)# 输出可能是漂亮的段落,但没人能保证每个字都是患者说过的前者朴素,但每个字都能对上患者;后者漂亮,但内容不再完全属于患者自己。面向医疗场景的记录,朴素与可控是优点。
四、为什么题库加流程依然是主流
这不是大模型技术不行,而是场景决定的:病史采集要的是确定、完整、可追溯,恰好都是概率生成不擅长的地方。题库看起来"笨",但笨得可靠。
五、采购方怎么判断一个方案的 AI 成分
评估"带 AI"的预问诊方案时,核对四件事:
- 患者填写的内容有没有被改写
:填"咳嗽有痰",看记录里是不是原句,还是被模型润色过 - 有没有明确的边界声明
:方案里写不写"不生成结论、原样呈现",敢不敢写进合同 - 主流程靠什么
:题库引导还是自由对话,演示里试两下就能看出来 - 生成能力的位置
:AI 用在后台辅助运营,还是直接面对患者生成内容——前者是提效工具,后者是性质变化
常见问题
Q:接了大模型的预问诊是不是更先进?
看用在哪。用在后台辅助内容运营是提效,用在患者端生成内容则改变了产品性质。预问诊的核心指标是采集信息的完整和真实,这两样要靠确定性的题库流程来保证,不是靠生成。
Q:大模型生成的内容能直接给医生看吗?
不建议。记录里的每个字都应该能对上患者的原话,大模型的改写、概括、补全都会破坏这一点。医生读一份被加工过的记录,等于在猜哪些是患者说的,记录就失去价值了。
Q:那预问诊系统就完全不用 AI 吗?
不是不用,是用在运营环节做辅助。患者端的主流程靠题库与流程引导,保证采集的内容确定、完整、可追溯。
Q:以后想给系统接大模型,可以吗?
可以,源码在自己手里,扩展是常规二开。但建议先把边界定清楚:接入的位置放在运营辅助还是患者端、生成的内容记不进结构化记录、输出前要不要人工确认——这些定了再动手,比先接上再补救省得多。
结语
AI 大模型是好的工具,但要放对位置。预问诊的价值在"采集得完整、记录得真实",这靠确定性的题库流程来保证;大模型的价值在后台帮运营提效。边界分清,两者不冲突;边界混了,风险归采购方。
如果你在评估预问诊方案,想看在线演示或了解源码细节,欢迎留言或私信。
本系统为在线病史信息采集工具,用于患者自述信息的采集与结构化整理,不提供诊断结论、治疗建议或病情判断,不属于医疗器械,不能替代医师面诊。