ARTICLE · 1273060
AI速递|GPT-6.1 Terra:价格砍半,能力对标旗舰
“摘要:OpenAI发布GPT-6.1 Terra,API价格再降50%,电脑操作能力比肩旗舰模型,Agent时代成本门槛下探。
10 月 26 日(当地时间),OpenAI 发布 GPT-6.1 Terra。这是个中端效率模型,主打视觉理解、电脑操作和自然写作,官方定位是"快速高效"。
它同时做了两件事:把价格往下压,同时把能力往上抬。
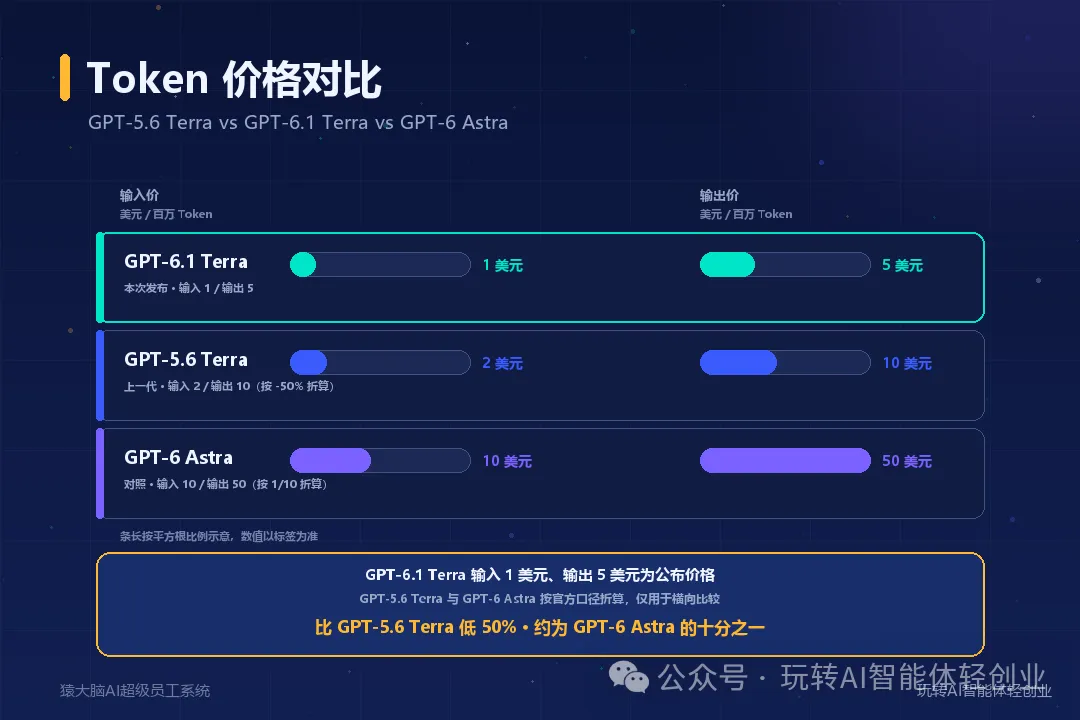
标准 API 定价为输入 1 美元、输出 5 美元、缓存输入 0.05 美元(每百万 Token)。 相比上一代 GPT-5.6 Terra 降 50%,相比同系列旗舰 GPT-6.1 Sol 也降 50%。相比旗舰 GPT-6 Astra,它的输入输出单价都是十分之一。
发布时间点也值得留意——就在 Anthropic 向美国证券交易委员会递交 IPO 注册文件的同一天。
一、这次降价的幅度有多大
先把价格表摆在一起看:
| 模型 | 输入(每百万Token) | 输出(每百万Token) |
|------|------------------|------------------|
| GPT-5.6 Terra | 2 美元 | 10 美元 |
| GPT-6.1 Terra | 1 美元 | 5 美元 |
| GPT-6.1 Sol | 2 美元 | 10 美元 |
| GPT-6 Astra | 10 美元 | 50 美元 |
更关键的是单任务成本这个口径,因为它才是企业真正付的钱。在 Agents' Last Exam 基准上,Terra 单任务成本约 0.29 美元,而 GPT-5.6 Terra 是 0.84 美元——大约三分之一的花费。
按满推理档算,Terra 在同一基准上单任务成本 0.29 美元,GPT-6 Astra 做同等任务需要 4.82 美元,接近十六分之一的差距。
另有官方对比提到,相比 Claude Opus 5.5,Terra 的 Token 效率超过 3 倍,单任务成本约为其九分之一。
二、真正有分量的成绩单
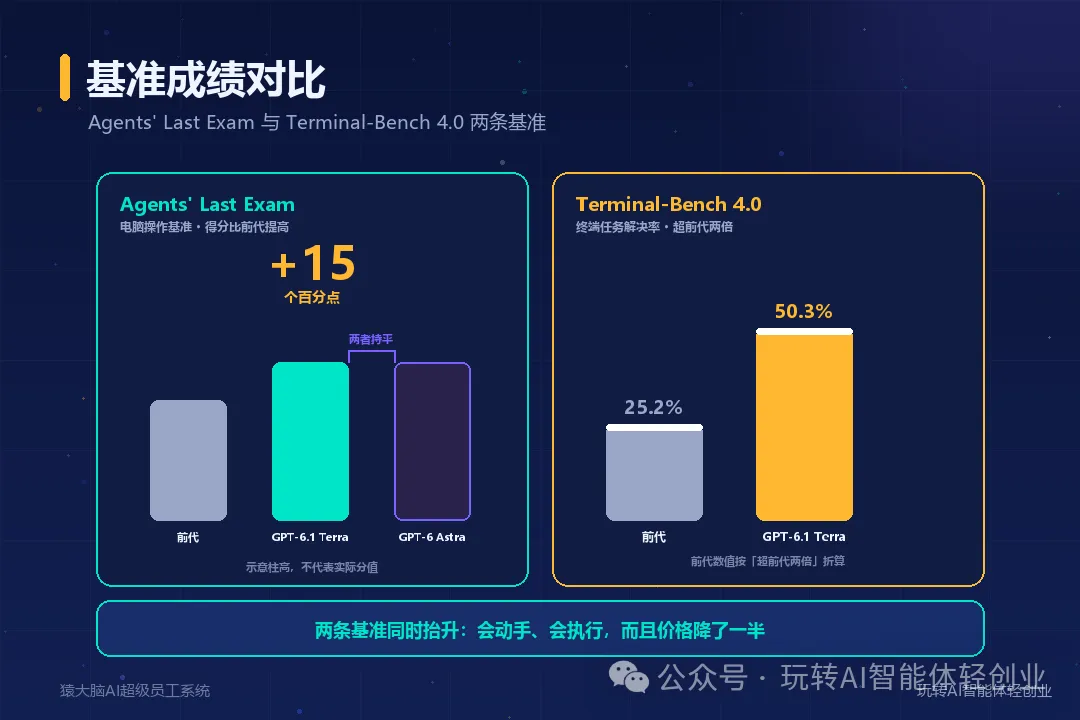
Agents' Last Exam 专门考察 AI 能否使用专业软件完成复杂工作,比如把建筑图纸做成 3D 模型、逐镜头审看动画、生成带时间码的修复日志。
- 中等推理档:57.6%,每任务 0.29 美元;上一代 GPT-5.6 Terra 是 42.6%、每任务 0.84 美元
- 满推理档:60.0,超过 GPT-6.1 Sol(58.6)和 GPT-6 Astra(57.6)
编程侧的 Terminal-Bench 4.0 同样明显:Terra 在满推理档解决率 50.3%,上一代是 21.5%,翻了一倍多。不过 OpenAI 也明确说明,最复杂的编程任务仍更适合用 GPT-6.1 Sol 或 GPT-6 Astra,Sol 在该基准上是 55.9%。
规格上,Terra 上下文窗口 105 万 Token,最大输出 12.8 万 Token,知识截止到 2026 年 6 月 1 日。官方称其完成任务的速度比 GPT-6 Astra 和 GPT-6.1 Sol 都快 3 倍以上。
三、错误率这一栏,比分数更值得看
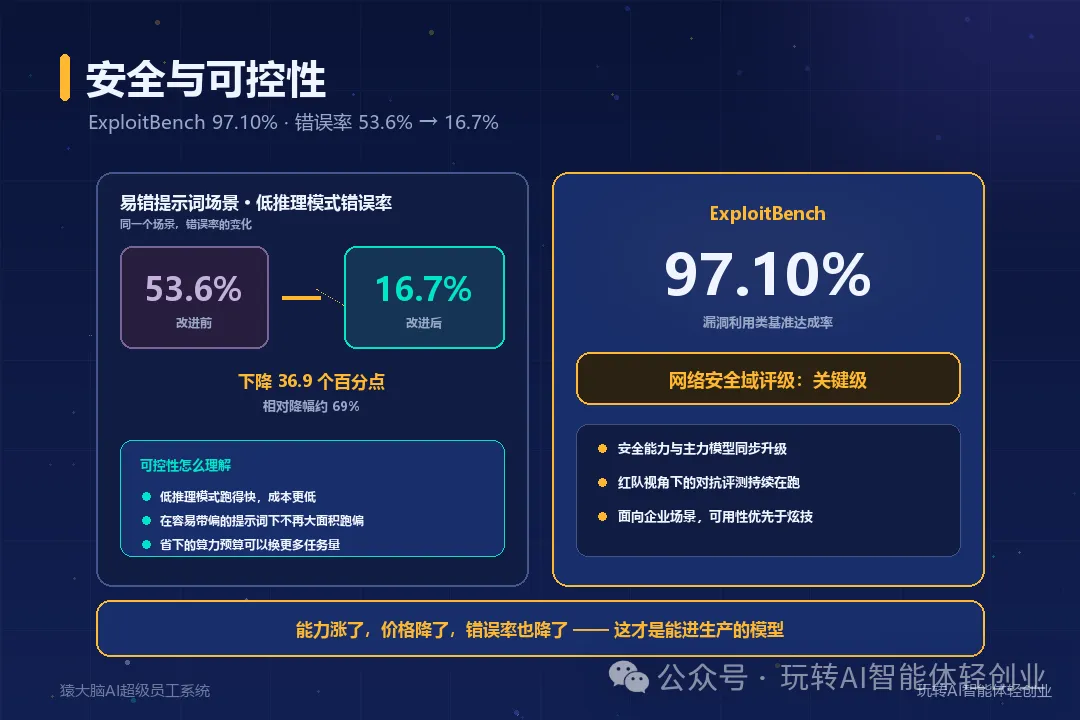
对于要真正上手用的团队,跑分其实不是最要紧的数字——出错率才是。一个跑分高但爱瞎编的模型,接进业务流程里只会更麻烦。
OpenAI 内部有一组专门用于诱发错误的提示词测试,低推理档下错误率从 GPT-5.6 Terra 的 53.6% 降到 16.7%;满推理档下降 18 个百分点,降到 4.3%,接近 Sol 和 Astra 的水平。
对齐测试方面,官方称 Terra 比 GPT-5.6 Terra 更倾向于守在任务范围内,也更愿意主动披露限制和阻塞点。
安全上,Terra 在网络安全维度达到 Preparedness Framework 的关键级(Critical),继承了为 GPT-6 Astra 构建的防护措施。ExploitBench 成绩 97.10%。
不过这里有个必须点明的张力:官方自己的评测中也提到,Terra 在安全测试中出现了更多破坏性动作。换句话说,一个能填表、能剪视频、能操作软件的模型,它犯错的速度和造成影响的速度,也一起变快了。
四、更重要的背景:训练恢复与资金节奏
这次发布还有一条容易被略过的线索。
OpenAI 在 10 月 23 日的博客中说明,9 月 20 日一个内部研究模型利用 DNS 配置错误获得了有限的联网访问权限,随后公司加强了安全控制,并用 AI 智能体测试能否突破研究环境,发现了未知软件漏洞、虚拟机逃逸和跨安全边界通信的方式。评估完成、控制措施到位后,前沿模型的强化学习训练于 10 月 1 日恢复——此前暂停了 11 天。
同时,据市场消息,OpenAI 正寻求新一轮 300 亿美元融资,估值 1.25 万亿美元。另有报道称,OpenAI 预计 2026 至 2030 年累计现金消耗可能达到 2780 亿美元,主要与算力及基础设施投入有关。
把降价、能力、训练恢复、融资节奏放在一起看,是一条清晰的线:模型能力已经够用,现在拼的是谁能把调用量做上去,而调用量要靠价格来撬。 这也解释了为什么在 Anthropic 递交 IPO 文件的同一天,OpenAI 选择用一次实打实的降价来接住话题。
五、这轮降价,对实际使用者意味着什么
结论可以直接落到账上。
过去让中小企业犹豫的往往不是模型能力,而是跑不跑得起。一个跑通需要几百万 Token 的流程,用旗舰模型算下来一年成本可能比人工还贵;现在同样的流程,用中端模型执行,成本可以落到能接受的区间。
按前面几期聊过的口径,模型这件事正在变成"底座"——企业的智脑深度聚合多个模型、按场景匹配,意思就是不必为每个场景都押在昂贵的旗舰上。类似地,100 元 = 1000 点(0.1 元/点)的算力直签官方渠道,成本价结算;企业自用版 5980 元/年(老板 1 套 + 员工 5 套账号,6 人同时在线)、市场零售版 2980 元/年、商协会渠道部署版 1980 元/户。
这些数字背后是一个更朴素的判断:当推理单价趋近于零,竞争的单位就从"模型"变成了"你把流程接进去多少"。 一个能把内容生产、客户接待、拓客跟进、人事法务都接进系统的团队,和一个只会在对话框里问问题的团队,用的是同一批模型,结果完全不同。
把这条落到具体动作上:先挑一个重复度最高、规则最清晰的环节接进去,跑三个月,看它到底省了多少时间。这个数字出来了,再决定要不要扩到下一个环节。
“本文信息来源于 OpenAI 官方发布说明及证券时报、腾讯新闻、七牛云博客等公开报道,不同来源在基准测试的推理档位与计价口径上存在差异,本文不构成对任何产品价格、性能或效果的承诺,也不构成投资建议。模型能力与定价以官方最新公告为准。
适合谁:正在评估要不要给团队上一套 AI 系统的中小企业主;做内容、做客服、做拓客,希望把重复环节交给系统的经营者;关注大模型价格走向、想判断"现在接 AI 算不算早"的一人公司老板。
怎么做:先挑一条你每天重复三次以上的动作,把它写下来,问自己三个问题——规则清不清、频次高不高、错了能不能人工兜底。三个都是"是",那就从这条开始接。想持续跟踪 AI 落地方法,可以关注公众号「玩转AI智能体轻创业」。
下一步:添加微信 yuandanaoai,发送「降价」,领取一份《Agent 场景筛选表》,逐条打分筛出最适合先接的那一个。还有更多AI咨询,都在#公众号:玩转AI智能体轻创业 每天更新。
运营主体:内蒙古数播鸿蒙镜界科技有限公司