ARTICLE · 1280269
我给 AI 编程助手换了个"外壳",token 账单直接砍半——SoL-Pi 本地搭建实录
我给 AI 编程助手换了个"外壳",token 账单直接砍半——SoL-Pi 本地搭建实录先说个背景。 我平时让 AI 帮我写代码、跑量化实验,用的是按 token 计费的 API。上个月翻行程账单,一个晚上挂机跑批任务,三个小时烧掉了几十块钱。一开始我以为是任务本身重,后来导出对话记录逐条复盘,才看清一个反直觉的事实:真正花在"干活"上的 token 是少数派,大头全耗在重复携带上——agent 改一次文件,把它读过的几十 KB 输出原样再发一遍;每发一次请求,工具说明、技能清单这些"家底"也要重新报一遍。 这个发现让我很不爽,但也没辙,agent 的行为是外壳(harness)决定的,我改不了。直到 9 月中旬,英伟达开源了一个专治这个的东西。 先补一个概念。你平时用的 Claude Code、Codex 这类编程 agent,其实是两部分:里面的模型是发动机,外面还有一整套"外壳"在管着工具怎么调、结果怎么回传、上下文怎么塞——这套外壳叫 harness。同样的发动机,底盘不同,油耗天差地别。 SoL-Pi 干的事就是重造底盘。它是英伟达一个"递归自动研究循环"项目的产物:让 agent 自己去优化自己的外壳,批量跑实验、互相淘汰,最后活下来四个机制,打包成了 SoL-Pi。项目 9 月开源,一个月 GitHub 三千多 star,我克隆的时候顺手看了下目录,四个机制各占一个平级文件夹,互相不牵扯,关掉任何一个不影响另外三个——这个切分方式本身就很讲究,后面会讲为什么。 四个机制,每一个都对着我上面说的某类浪费: 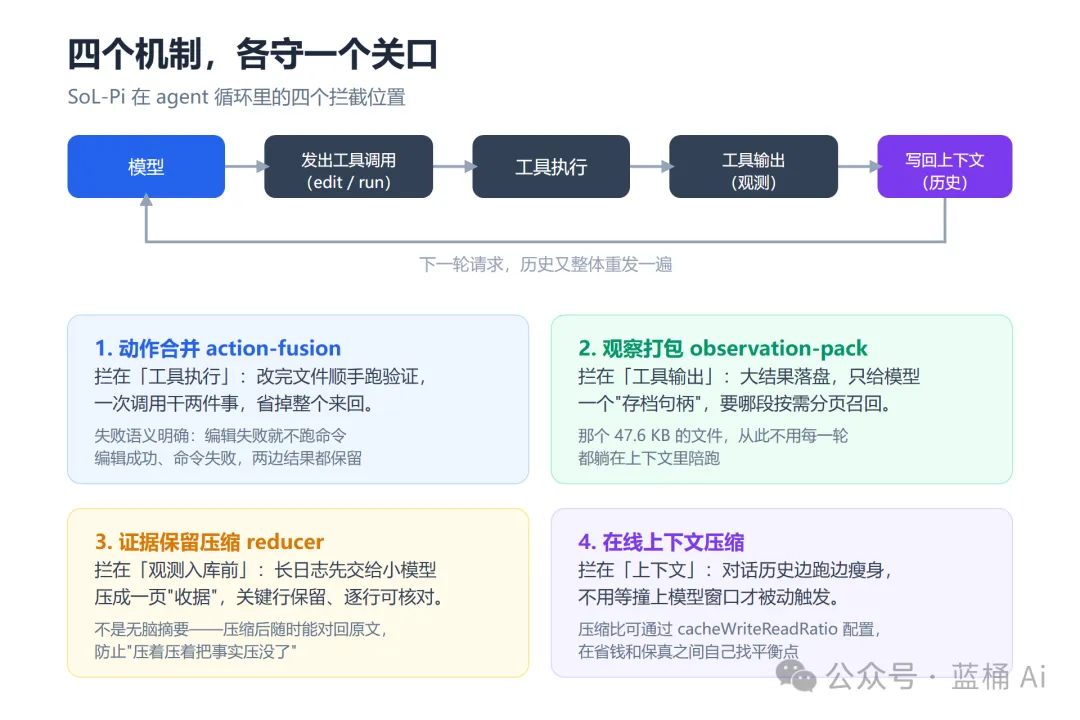
动作合并(action-fusion)。以前 agent 改个文件要两个来回:先调 edit,等结果回来,再调一次 run 跑测试。它把这两步合成一次调用,改完文件顺手把验证命令跑了。细节做得挺扎实:编辑失败就不执行命令,避免在坏文件上白跑;编辑成功、命令失败,两边的观测都保留,agent 能分清是谁的锅。 观察打包(observation-pack)。我复盘里最刺眼的案例:agent 读了一个 47.6 KB 的日志文件,之后这个文件就赖在上下文里不走了,后面每一轮请求都原样重发,跑三十轮就是 1.4 MB 的冤枉钱。这个机制的思路是大结果先落盘,上下文里只留一个"存档句柄",模型后面要用哪一段,按需分页取回来。原会话记录不动,恢复会话之后召回照常工作。 证据保留压缩(evidence-preserving-reducer)。长日志交给小模型压成一页"收据",但关键行保留原文,随时可以逐条核对回原文。名字里的 evidence-preserving 就是这个意思——压缩可以,不许把事实压没了。这一点对跑量化实验特别重要,压缩把报错细节压丢了,agent 后面就是在瞎猜。 在线上下文压缩(online-context-compact)。对话历史太臃肿时边跑边瘦身,不用等撞上模型窗口才被动触发。压缩比可以配置,省钱和保真之间自己找平衡点。 读源码的时候,有三条设计原则让我印象很深。默认全关:四个机制出厂都是 false,要显式打开,杜绝"我以为开了其实没开";拼错即报错:配置键打错一个字母直接拒启,绝不静默忽略——我一开始嫌它较真,后来发现这设计救过我命(下文有事故现场);失败即放行:任何机制内部出错,一律原样放行数据,不许改变 agent 的行为。降级方向只有一条,这才敢在生产环境里开着睡大觉。 这种项目最怕论文漂亮、实际拉胯,我分两层验的。 第一层是论文。官方在 51 个任务的 EdgeBench 上测,模型覆盖 GPT-5.6 Sol 和 Opus 5:任务表现与原版基本打平,token 流量降 44.7% 到 49%,API 成本降约三分之一。换算成钱:对原生 Codex、Claude Code,每小时大约省 8.75 到 13.5 美元;对已经优化过的 Pi,还能再省 4 到 6 美元。按我每天挂机六小时算,一个月省出来的钱比我的 API 订阅费还多。 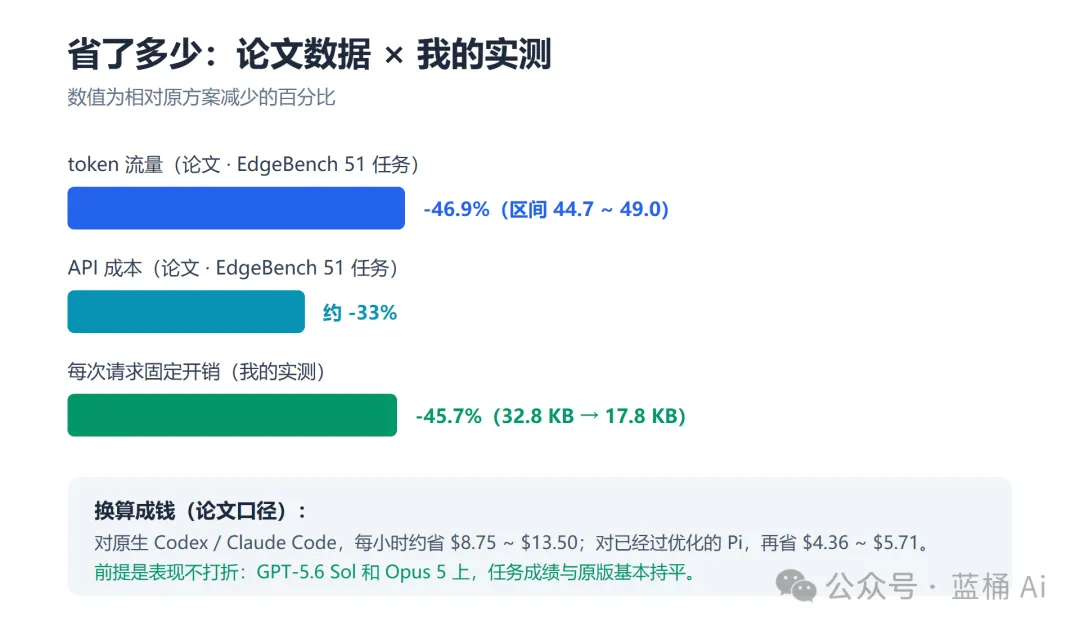
第二层是我自己。为了搞清楚"我的场景里钱到底漏在哪",我给自己的 agent 环境写了个零依赖的计量脚本,监听工具结果和每轮请求,攒了 22 个会话、120 次工具调用的数据。量出来的东西比直觉狠多了: 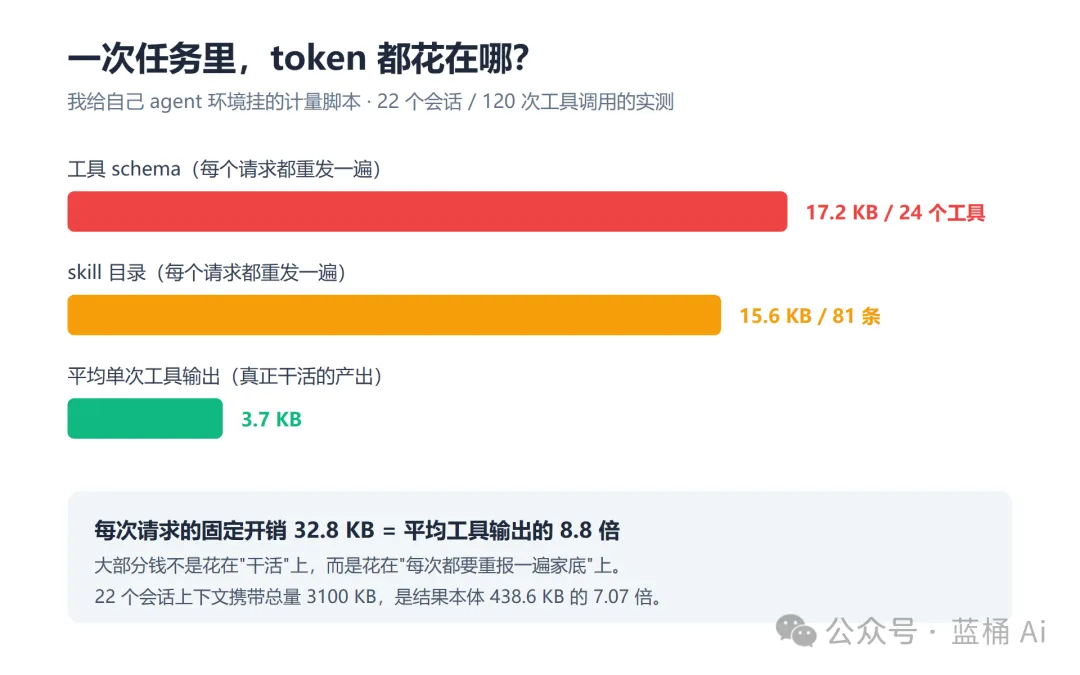
每次请求都要重发的"固定开销"有 32.8 KB:工具 schema 17.2 KB(24 个工具),技能目录 15.6 KB(81 条)。而平均一次工具输出——真正干活的产出——只有 3.7 KB。固定开销是产出的 8.8 倍。 22 个会话上下文携带总量 3100 KB,结果本体只有 438.6 KB,放大了 7 倍多。 也就是说,我每花 8 块 8,只有 1 块钱是花在"活"上的。这组数字出来之后,我对 SoL-Pi 那几个机制为什么有效就彻底不怀疑了:它砍的正是"重报家底"和"历史陪跑"这两块最大的肥肉。我把固定开销收窄之后实测降了 45.7%(32.8 KB 到 17.8 KB),跟论文 44.7% 到 49% 的区间正好对上。 我的环境:Windows 11,Node 20。全程不需要本地显卡,模型都走 API,这点对没显卡的朋友很友好。整个过程我整理成了下面这张图,展开讲: 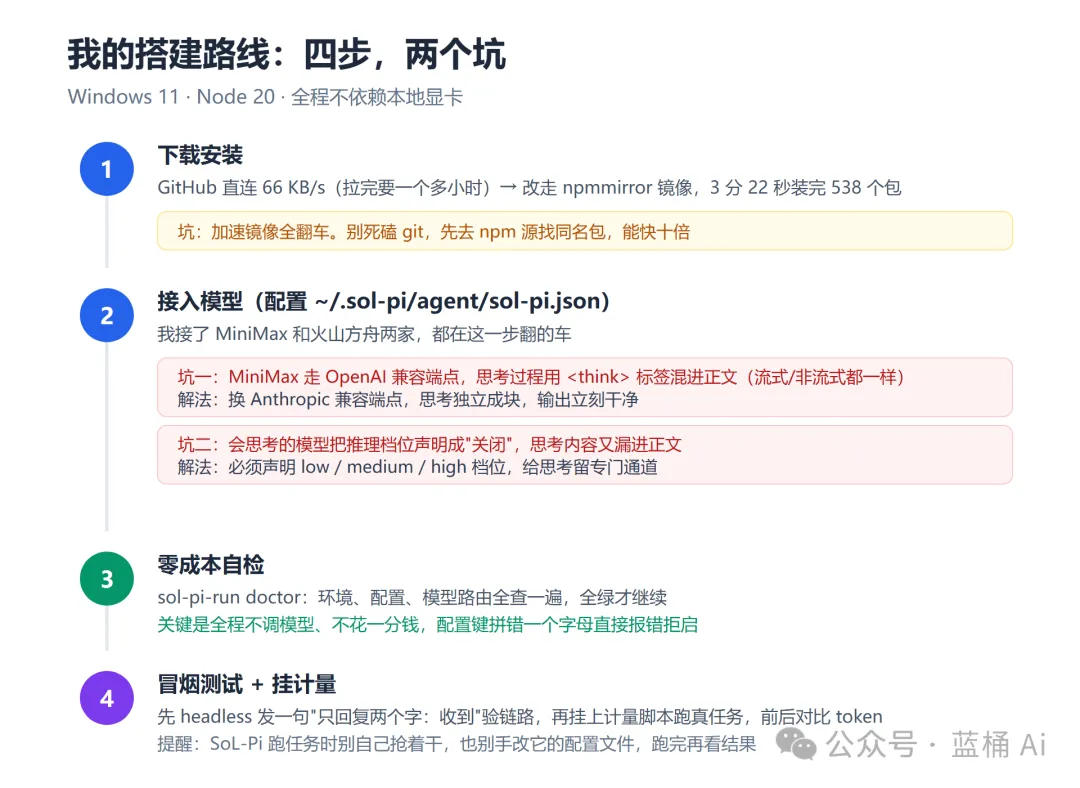
第一步:下载就先撞墙 按惯例 clone 仓库,结果直连速度 66 KB/s,拉完要一个多小时。不信邪,把常见的 GitHub 加速镜像挨个试了一遍——不是超时就是绕一圈反而更慢,全军覆没。 最后换了思路:不碰 git,直接去 npm 源找同名包,挂上国内镜像源装。3 分 22 秒,538 个包,512 MB,全部到位。国内的朋友建议直接抄这条近路,另外装社区插件时同理:先 npm view 包名 查一下有没有发布版,有就装 npm 包,我实测 21 秒搞定,比从源码仓库装省十分钟还少一堆编译报错。 第二步:接模型,两个坑花掉我一晚上 配置文件在 ~/.sol-pi/agent/sol-pi.json,核心是把你的 API 接进去。我接了两家:MiniMax 和火山方舟,一家一个坑。 坑一:思考内容混进正文。MiniMax 走 OpenAI 兼容端点,模型的思考过程会用 标签直接混在正文里返回,流式和非流式都一样,界面上看一团浆糊。我以为是配置问题,翻了一晚上文档才发现是端点行为差异,最终解法:换它的 Anthropic 兼容端点,思考内容独立成块,输出立刻干净。 坑二:推理档位一刀切关掉。接方舟模型时,我声明推理档位为"关闭",结果思考内容又漏进正文。查了半天才明白:这类会思考的模型必须声明 low / medium / high 档位,给思考留专门通道,一刀切反而适得其反。 两个坑其实是同一件事:会思考的模型,要给思考留专门的通道。记住这句,能省你一小时。 这里还有个事故现场,正好呼应前面说的"拼错即报错":我第一次写配置时手滑把一个键名拼错了,SoL-Pi 直接报 Unknown config key 拒绝启动。当时我还嘀咕至于吗,直到想起之前在别的工具里,配置键被静默忽略、我以为开着的机制其实压根没生效、白测一下午数据的事——这种较真是对的。 第三步:先自检,别急着烧钱 SoL-Pi 有个我很欣赏的设计:自检命令 sol-pi-run doctor,把环境、配置、模型路由全查一遍,所有项都是 ok 才继续——关键是全程不调模型,一分钱不花。零成本意味着你可以每次跑真任务前都先过一遍,没有任何心理负担。 第四步:冒烟测试,然后挂上计量 先发一句"只回复两个字:收到"验证链路通不通,确认模型路由正确、输出干净,再跑真任务。真任务开跑前记得官方文档里那句话:SoL-Pi 跑任务的时候,你别自己抢着干,也别去手改它的配置文件。让 agent 独立跑完再看结果,中途插手既污染观测也容易打架。 我自己多加了一步:挂计量脚本,前后对比。结果跟论文对得上——token 流量降四成多,其中"观察打包"贡献最大,我的任务经常出大段日志,以前这些全是原样进上下文陪跑的。意外收获是响应速度也快了一截:每次请求携带的内容少了,首 token 延迟肉眼可见地往下掉。 说实话,如果你只是偶尔问 AI 几句代码,没必要折腾,省不了几块钱。但符合下面任意一条,我建议花一个晚上: 经常让 agent 跑长任务、跑批任务,token 是真实成本 做量化、做实验迭代,一天几十上百次调用 对 agent 内部机制好奇,想看看一套被打磨过的外壳长什么样——光那三条设计原则(默认全关、fail-fast、失败即放行)就值得抄回自己的项目里 搭建本身不难,难点全在模型接入那一步,而我踩的这两个坑大概率你也会遇到。
SoL-Pi 是个啥:发动机不改,换底盘
数据到底怎么样:论文一串,我自己也量了一把
搭建实录:四步,两个坑