ARTICLE · 1283875
2026 年 10 月 OCR 更新:长文档怎么读,识别结果谁来验?
导读这批 OCR 更新分别着力于控制长文档开销、针对难例改进训练、为识别结果评分。百度 Unlimited OCR 2 让每一步少算、缓存少存,SoMark OXR 把错误归因转成训练数据,面壁 MiniCPM-OCR Jev 辅助筛选需要人工复核的区域。拆开机制、性能与适用条件,才能判断它们各自解决了什么。
本文 3036 字,阅读约 8 分钟
处理一份文档,会遇到三类问题
2026 年 10 月,SoMark 发布 OXR,百度在 27 日开源 Unlimited OCR 2,面壁智能在 28 日推出 MiniCPM-OCR 系列。往前一个月,还有小米的 Xiaomi-OCR-0。
OCR 原本指光学字符识别,也就是把图像里的字转成文本。这里讨论的文档解析还要恢复表格、公式和阅读顺序;结果质检则负责判断解析得对不对。同样出现在 OCR 更新里,它们承担的任务并不相同。
OCR It 不是 MinerU 的平替:从识字到解析,中间差了什么?
以一份几百页、夹着续表的扫描报告为例。模型可能读到后面越来越慢;也可能反复认错某种表格结构;即使顺利输出了 Markdown,仍有人需要核对关键数字。这是三种不同的困难。
我想沿着这些问题看三条路线:运行时怎样控制长文档开销,训练时怎样补足难例,输出后怎样分配复核。三者作用在不同阶段,本文分别看它们的机制与证据。
Unlimited OCR 2:每一步少算,显存里少存
Unlimited OCR 2 总参数约 3B(30 亿),采用混合专家架构,每次生成只激活其中约 500M(5 亿)参数。参数量描述模型规模,长文档开销还取决于它每一步要读取多少上下文。
页面先经过视觉编码器,变成一组承载图像特征的视觉 Token。Token 是模型处理的基本单元:视觉 Token 表示图像特征,生成的文本 Token 则对应文字或符号片段。解码器参考这些视觉信息和已有输出,逐步生成文字与结构。
困难在于:文档越厚,可参考的视觉信息越多。上一代 Unlimited OCR 已限制近期文本上下文的长度,但每一步仍要对全部页面的视觉 Token 计算注意力,长文档的计算负担会继续增长。
Unlimited OCR 2 的 SR-SWA,即稀疏参考滑动窗口注意力,把视觉信息选择拆成两步。
Page Gate 先按当前解析对应的页面约束候选块范围。Token Sieve 再为候选块计算相关性,只选择固定数量的高相关块参与注意力计算。这里筛选的是图像特征块,不是先把整页读成文字再检索。
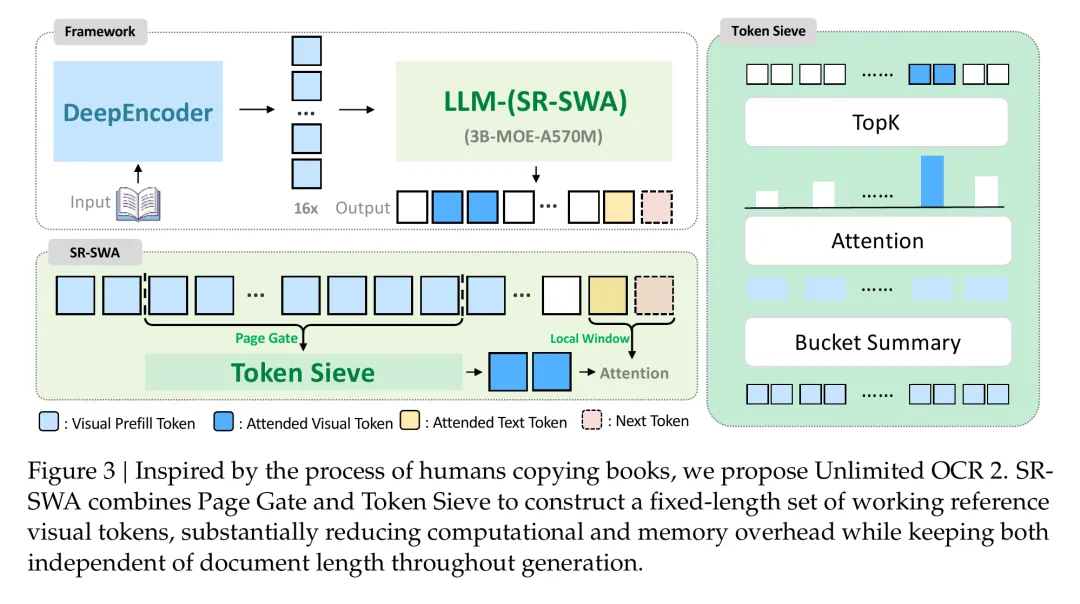 左下是页级范围约束与视觉块筛选,右侧展开 Token Sieve;局部窗口同时保留近期上下文 | 来源:百度 Unlimited OCR Works 2 技术报告,Figure 3
可以把它理解为:转写当前这段内容时,模型只调取有限的视觉证据,再结合近期已经生成的上下文往下写。视觉块的边界可能跨相邻页面,并不要求与纸张边界严格对齐。
但少参与计算的信息,如果仍全部留在显存里,缓存占用依然会增加。因此,还需要第二项设计:Unlimited-Horizon Decoding,即持续推进的分块解码。
它把文档划成大小可控的页面块,相邻块重叠一页。切换时,复用交接页的视觉 KV 缓存,并带上上一段输出末尾的文本缓存;不再需要的历史视觉缓存释放掉。KV 缓存保存的是供后续生成复用的中间计算结果。
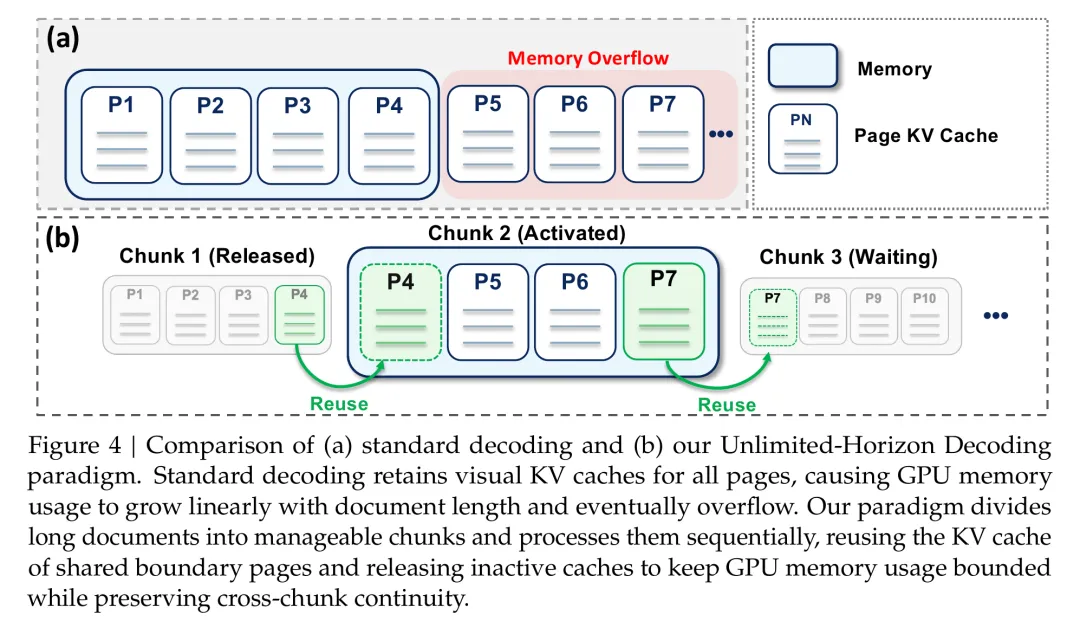 上方同时保留全部页面缓存,下方只保留当前块,并复用相邻块的交接页 | 来源:百度 Unlimited OCR Works 2 技术报告,Figure 4
SR-SWA 缩小每一步的计算范围,分块解码控制驻留缓存规模。两者配合,才把长文档处理的计算和存储问题分开解决。
作者在批量大小为 3、每页固定生成 1024 Token 的百页测试中,报告 SR-SWA 的单步解码速度达到全注意力的 7.0 倍、上一代 R-SWA 的 5.6 倍。这项对照检验的是注意力路径的效率。
技术报告在百页级 MarathonDocBench 上比较两种解码方式:单序列峰值 KV 缓存从 47.00 GB 降到 1.77 GB;另一项 16 路并发测试中,输出吞吐从每秒 360 Token 增至 1315 Token。1.77 GB 只是 KV 缓存,不包含模型权重等开销。
解析质量方面,作者报告 MPDocBench 综合得分 84.59,MarathonDocBench 为 77.06,均为报告所列参评模型中的最高综合分。后者是团队新建的百页基准,包含 100 份、每份 103—300 页的文档;这些分数不能换算成任意文档的识别正确率。
连续处理的能力也有边界。报告明确指出,当前稀疏机制不保留完整的全局文档信息,标题层级等结构理解仍受限。单步开销受控,也不意味着处理整本书的总时间恒定。
OXR:把难例变成下一轮训练题
另一类问题是反复认错同一种版式。即使计算资源够用,模型也可能没学好某种续表或手写公式。OXR 从训练侧入手,考虑怎样让新增数据跟着模型的弱项走。
SoMark 的 OXR 是一个 1.3B 文档解析模型。它在后训练阶段引入 RSI,即递归自我改进:发现薄弱样本,分析原因,再定向生成训练数据。
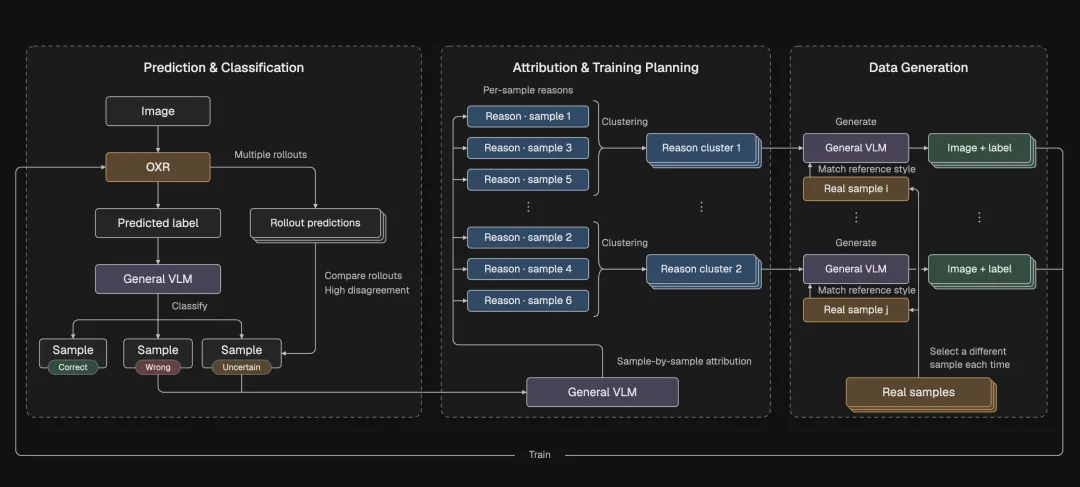 从左到右是预测分类、归因与训练规划、数据生成;底部回路把生成数据送回训练 | 来源:SoMark,OXR 官方仓库
流程先让 OXR 解析真实文档,再由通用视觉语言模型结合原图和预测进行判断,把样本分为正确、错误和不确定。对同一输入多次生成,如果结果分歧很大,也会进入不确定集合。
接着,系统对错误和不确定样本逐个归因,把相近原因聚在一起。生成环节依据这些原因,以真实文档的视觉风格为参照,构造图像与标签,回到下一轮训练。
以跨行单元格为示意:若错误集中在这种结构上,下一轮就定向补充相应表格,而不是只增加普通段落。
关键在于把错误转成可执行的数据需求,再用于下一轮训练。这套循环需要判错、归因与合成组件共同参与,数据质量也取决于这些环节;它不发生在每次解析 PDF 的过程中。
官方评测文档列出 OXR 在 OmniDocBench 上的 97.18 分,在 2026 年 10 月 5 日的比较快照中列第一。其他模型成绩部分来自公开记录,不能单凭这张成绩单,把收益全部归因于 RSI。
在推理管线上,OXR 还有一个独立的工程取舍:把负责划分页面区域的版面分析模型做成可替换组件,内容识别与阅读顺序仍由 OXR 主模型承担。业务可以调整区域划分,保留后面的识别能力。
官方用单张 RTX PRO 6000 Blackwell 96GB,在固定抽取的 100 张页面上测试,OXR 两轮平均端到端耗时约 101 秒,包含阅读顺序处理,列该次 21 款模型的第一,页面吞吐比次名高约 33.5%。这是 1.3B 模型及其管线的整体表现,没有单独分离架构调整或 RSI 的贡献;这里的 100 张页面,也与前面的百页连续文档实验属于不同负载,不能直接比较快慢。
MiniCPM-OCR Jev:输出之后,再判断哪些值得复核
结果生成后,仍有一个问题:哪些区域可以自动接收,哪些应交给人?这需要在解析能力之外,增加判断结果质量的能力。
面壁这次同时发布了两个模型:1.3B 的 MiniCPM-OCR 1.0 负责解析,2B 的 MiniCPM-OCR Jev 负责评价已有解析结果。
Jev 每次判断一个文本、公式或表格区域。内部输入包括原始区域图像、候选识别内容,以及把候选内容重新渲染得到的图像;输出为 0—1 的质量分,越高表示模型越倾向于判对。渲染图让表格、公式的结构也能以视觉形式参与比对。
它基于 Qwen3.5-2B 训练,把生成文字的输出头换成判断对错的二分类头。判别时直接计算评分,省去逐字生成解释的步骤。
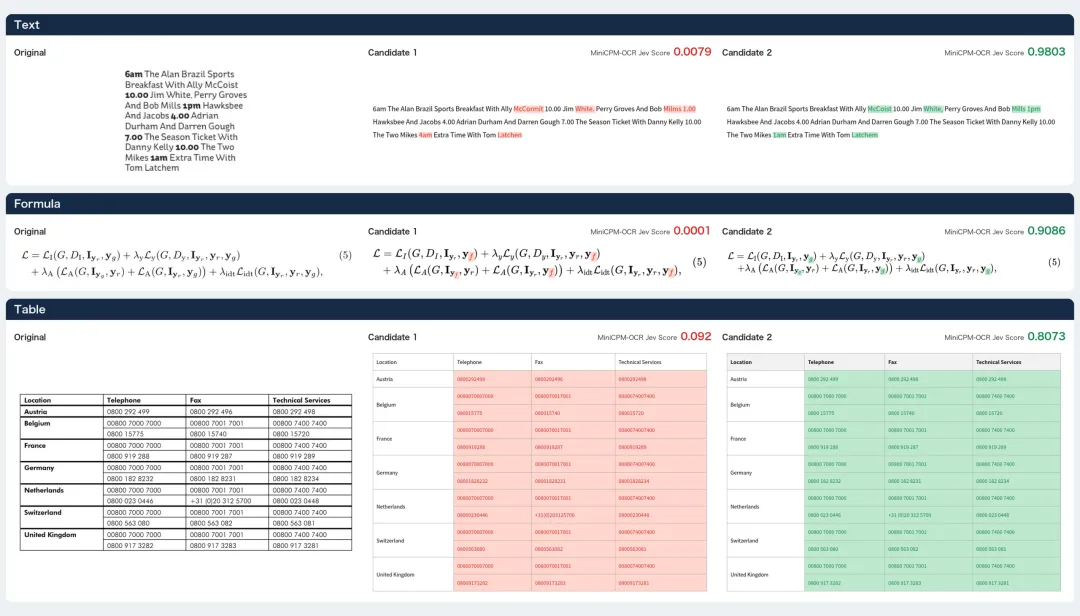 三行分别展示文本、公式和表格;每行比较同一原图的两个候选及其评分 | 来源:OpenBMB,MiniCPM-OCR Jev 官方指南
这对应两种用法:一个候选得分不足,送去人工复核;同一区域有多个解析候选,则优先选择高分项,仍不达阈值的继续交给人。候选必须对应相同的裁图和内容边界,选中的区域再按阅读顺序组合。
这也意味着,质量判断依赖已经送进来的区域与候选。如果上游根本没切出某个区域,后面只给现有区域评分,不能据此保证整页没有漏项。
官方在 JevOCRBench 区域级评测上报告,这个 2B 判别模型的 AUROC 为 0.936,接近同表 Qwen3.5-397B-A17B 的 0.938。AUROC 衡量评分区分正确与错误候选的能力;0.936 也可写作 AUROC ×100 后的 93.6,它并不表示自动接收结果的正确率为 93.6%。
官方还用同样的 200 个样本,分别取得四款 OCR 的结果,Jev 的 AUROC 在 0.919—0.934 之间。这说明它在该组样本上能为不同解析器的候选评分;换到新文档、新解析器,仍需另行验证。
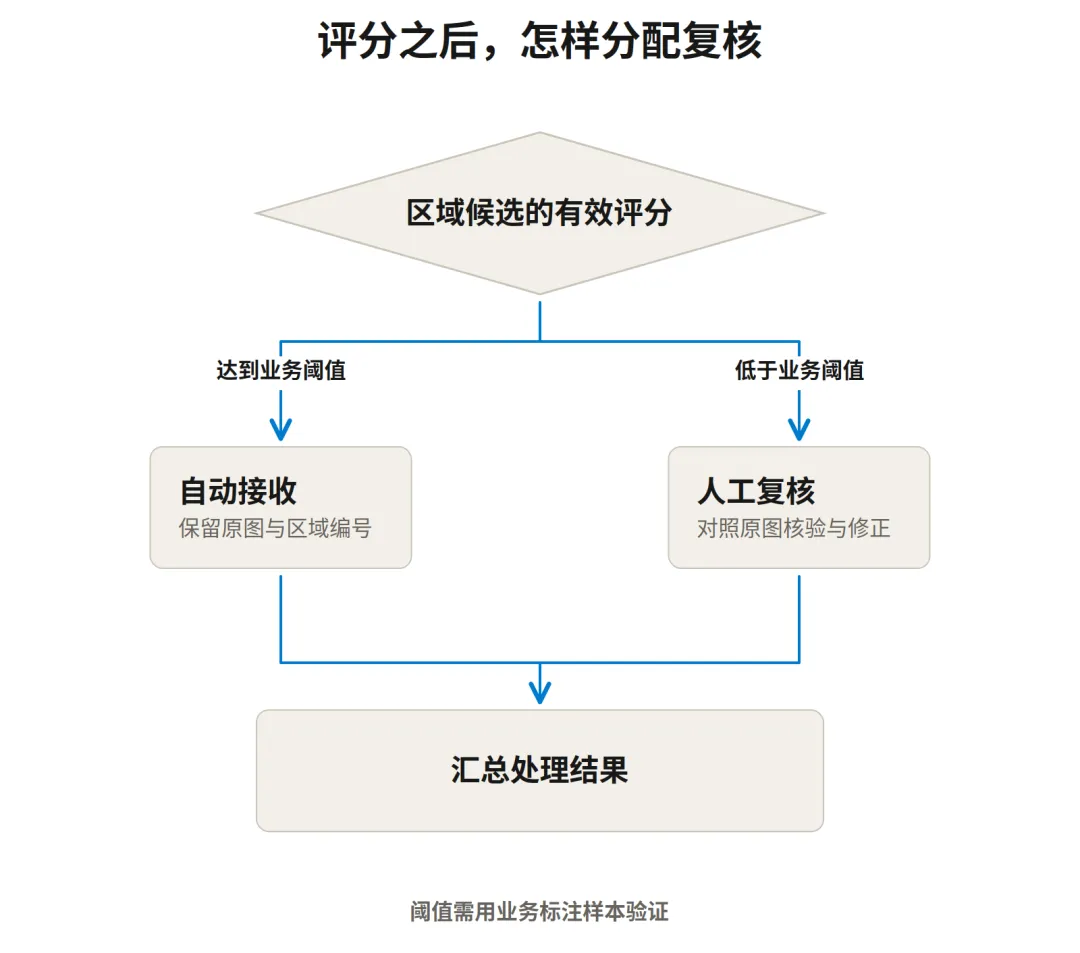
真正设置阈值时,要用自己的文档做人工标注,检查两个量:能自动接收多少,以及接收部分有多少错误。选好阈值,再拿独立样本验证。若要把 0.9 分解释为“九成概率正确”,还需核对这个分数段的实际正确比例。
接入质检还要算时间账:候选渲染、模型评分和必要重试增加了多少处理时间,又减少了多少人工复核。一次前向省去了长文本生成步骤,但在没有完整计时对照前,不能直接认定整条流程更快。
小米:从完整转写,延伸到按任务理解
9 月发布权重的 Xiaomi-OCR-0 则兼顾另一层需求。这个 0.8B 模型既做解析,也支持文档问答与关键信息抽取。
把报告完整转成 Markdown,需要尽量忠实、完整地恢复内容;回答“表里的合计金额是多少”,则需要按问题选择相关信息。两种任务相关,训练目标却有区别。
小米报告的消融实验观察到:解析基础较弱时,过早加入理解任务监督会拖累解析;基础成熟后,同类监督开始带来收益。联合训练的关键还包括何时加入理解任务,两种能力的促进关系有前提。
先找到瓶颈,再决定看哪种证据
回到那份带续表的扫描报告。如果页数增加后速度和缓存压力明显上升,就看长文档条件下的计算、缓存与跨页指标;若总在同类版式上出错,就看难例覆盖,以及定向补数据后这些错误是否减少;结果已经生成、人工却仍逐区核对,就看能自动接收多少、接收部分错了多少,再核算评分的额外开销。
这些问题可以同时存在,三条路线也有配合空间,但具体组合仍需验证。读得长、难例学得好、结果验得准,需要分别拿证据。接入知识库之前,先确认自己的流程究竟卡在哪里,再用对应的任务和指标评估模型。
参考资料
•Unlimited OCR 2:发布记录、推理实现与模型入口: https://github.com/baidu/Unlimited-OCR
•Unlimited OCR Works 2 技术报告:方法、实验与原图: https://github.com/baidu/Unlimited-OCR/blob/main/Unlimited-OCR-2.pdf
•OXR:RSI 机制、版面分析与评测文档: https://github.com/SoMarkAI/OXR
•OXR 发布介绍: https://somark.ai/oxr
•MiniCPM-OCR:解析、Jev 质量判别、案例与评测说明: https://github.com/OpenBMB/MiniCPM-OCR
•Xiaomi-OCR-0 Technical Report:解析与理解的训练分析: https://arxiv.org/abs/2609.36136
•Xiaomi-OCR-0 官方模型卡与发布记录: https://huggingface.co/SeerRay-Lab/Xiaomi-OCR-0
文章仅做学术分享,如有侵权请联系删除,非常感谢!