ARTICLE · 1291340
文档的答案RAG 就是搜不到,检索到底出了什么问题?
本周我们来探讨一个实际问题:RAG听不懂“人话”,资料一多就查不准、找不到,进而答非所问,智能化体现不出来。我们常常会有一个感受:RAG库文档里面明明有相关资料,可是大模型就是搜索不到,答不准。比如:政务窗口的老百姓问“我的房子面积超标了咋办”,明明政策文件里写了“宅基地超占处理”相关政策,可是对AI翻来覆去就是找不到地方,怎么办?
1. 上周遗留的问题
上周结尾我们埋了雷:前两周的召回实验,全部默认用户的问题用词非常专业,和资料库正文匹配度非常高。但实际上真实的用户不可能正好使用我们文档中的专业词汇来“明知故问”,一旦用户口语化提问,我们的查询就崩了。这篇我们来专心拆雷:资料库建好之后,问题查询侧如何优化不裸奔?
2. 解决问题要弄懂的几个关键概念
(这部分来自我第 11 周的学习笔记)
用户的提问不能直接用于检索查询
拿我们自己的测试语料来说:库里《06_聊天历史管理》正文写的是"上下文窗口""历史消息压缩"。但我们的用户大概率不会说“上下文窗口不够了,我的历史消息如何压缩?”,他们可能会说"AI 聊着聊着就忘了前面说的话,咋办?"。
你看,“忘事”两个字在我们的库里一次都没出现,向量余弦的相似度直接干趴下了。 除了专业词汇之外,用户可能还会使用代指,“它支持多长的输入?”它是指哪个模型,检索器不知道,无从查起。
还有一种情况:用户问题一句话塞三件事,“怎么给 AI 外挂技能,要花钱吗,用什么模型跑”,要回答这个问题可能需要查三篇文档,而检索器在某一篇文档中永远无法拿到完整的结果。
那如何把用户的话变成适合检索的查询?以下几种方法适应不同的情况,我们需要混着用:
其中HyDE 最反直觉:为什么让AI编一个假答案会好使?
因为在向量空间中,问句和陈述句本来就属于两个不同的区域,拿用户的问题直接和文档比相似度是区域比较,拿到结果的概率自然不高。假答案和文档同为陈述句,天然挨得近。甚至假答案都不一定要对,它只要"像一篇这个领域的文档",主题和术语对了就行,就能把检索拉到正确文档附近。当然风险也在这里:如果语料是私有冷门领域,LLM 没有相关常识,假答案的术语全靠编,那最后检索就肯定整个跑偏了。
基于这个知识点,我们就要针对性的编排我们的RAG,如果我们的业务语料是公开的能查询到的信息,HyDE 是个好方法;但换成我们私有领域的资料比如自然资源内部政策库,就最好老老实实用查询重写加术语词典的模式。
关于一句话塞了几个子问题的情况,我们也有专门的拆分手法。
还是以“怎么给 AI 外挂技能,要花钱吗,用什么模型跑”这个作为例子:先拆成三个子问题,各自独立检索,最后把三份证据拼在一起交给模型。这实际上就是多查询扩展的流程:一个入口进去,几个查询出来,并行检索、合并结果。区别只在那几个查询怎么来的:多查询是给一个意图换几种说法,拆分是把一个复合问题掰成几个意图。
最难办的是子问题有依赖:问“营收同比涨了多少”,得先查出今年的数,再查出去年的数,最后一步的查询词要用前一步的答案。这种串行拆分得让模型边查边想,是 Agentic RAG 的活,我们以后再说。
关键词查询和向量查询缺一不可
关键词查询有个特点,它认字面:“错误码”、“型号”、“字段名”、“结构化输出”这种专有名词,一个字都不能差。也正因为只认字面,它查得快、查得准,这是它的强项。当然代价就是用户换个说法它就瞎了。
向量查询反过来,它不认字面认语义:“给 AI 外挂技能”和“Agent函数调用”在字面上一个字都不沾,但向量知道它们离得近,这是它的强项。代价是对“不支持”“禁用”这类否定词经常装看不见,“支持 5G”和“不支持 5G”在向量眼里几乎是同一句话;真要精确查某个型号、编号,它也帮不上忙。
基于它俩的特性,我们设计查询的时候必须坚持两条腿并行走,关键词查询保证该命中的词不丢,向量查询确保换种说法也找得到。但两路查询结果最后要合并,就不能简单把结果直接相加。因为向量查询基于余弦,相似度是有界限的,一堆文档挤在 0.7 到 0.8 之间;而关键字查询基于分数,它没有上界,可能是 3 也可能是 30,直接相加等于让关键字查询的优先级无限提升进而一锤定音。通常这里我们使用RRF(倒数排名融合)进行处理:两路都排在前面的文档优先,只在一路露脸的靠后。具体怎么打分,我们第 3 节看。
重排是最后一道精挑
查询动作把相关文档捞回来了,但文档顺序很粗糙:排在第一的,未必是最能回答这个问题的。病根在向量查询的打分方式:文档离线算好存起来,问题和文档各自编码成一个向量,算个相似度,查询时比一下完事,打分的时候两边根本没关联起来。虽然速度快但整篇文档被压成了一个向量,细节全被平均掉,“支持 X”和“不支持 X”压出来可能差不多。
要想排得准,就得让问题和文档关联。重排(Rerank)就是干这个的:换一个更精的打分模型,把候选挨个和问题放在一起重新打分、重新排序。这类模型最常用的是 Cross-Encoder,它把问题和文档拼成一条输入塞进模型,两边每个词都能互相看见。词面相近、意图不同的它能分辨,否定词也读得懂。当然它也有它的问题,它很准,但是准是拿速度换的:输入里含着问题,用户没问之前无法提前算,每个候选都要现跑一次,所以它只用来给融合后的几十条候选精排,全库扫是扫不动的。
重排模型不止Cross-Encoder一家,按“问题和文档怎么见面”分几类,各有各的场合:
做常规中文 RAG,默认选 Cross-Encoder 就够,bge-reranker 是这类里的常客,第 3 节代码用的就是它。
重排把顺序排对了,还剩最后一道选择题:排好的名单,取几条送给模型? 这里正好把 Top-K 正式讲清楚,这个词前面几篇反复出现,一直没展开。它的意思是从排好序的候选里取前 K 条:候选按分数从高到低排好,从头切 K 条交给模型。我们一直说的 Top-3,就是 K 等于 3。放到我们这条链路上:关键词和向量两路各自捞回几十条,合并去重成三五十条的候选池,重排模型挨个打完分,最后放行的就是这 3 条。这个 K 不能贪大,如果K的条数一多,旧版本文档、主题相近的片段全跟着混进来,模型看着一堆证据容易挑花眼,答非所问的风险反而更大。
3. 代码实现
核心思路:改写负责翻译,双路负责兜底,RRF 负责合并,重排负责精挑,每一步的输入输出全部落日志。
上周的 Chunk、VectorStore、RagPipeline、登记簿全部沿用,这周只动查询侧,给它加四段。
① 查询改写:LLM 当翻译,失败回退原问题
REWRITE_PROMPT = """把用户的口语问题改写成适合知识库检索的查询。要求:口语说法换成文档里可能使用的正式术语;“它/这个”这类指代补全;一句话里有多个意图就先拆成子问题,否则换 2~3 种说法。只输出 JSON:{{"rewrite": "...", "queries": ["...", "..."]}}拿不准就原样返回原问题。用户问题:{q}"""defrewrite_query(question: str, provider) -> tuple[str, list[str]]:"""LLM 翻译,失败必须能回退原问题。"""try: resp = provider.chat(REWRITE_SYSTEM, REWRITE_PROMPT.format(q=question)) data = json.loads(extract_json(resp.content)) # 第02周同款 JSON 护栏 rewrite = (data.get("rewrite") or"").strip() or question variants = [v.strip() for v in data.get("queries", []) if v.strip()][:3]return rewrite, [question, *variants] # 原问题永远占一路except Exception: # 模型挂了、格式烂了,都走这return question, [question]关键设计:变体列表里永远保留原问题,改写跑偏时原始路还在参与检索;解析失败直接回退,改写是增强,不能变成依赖。
② 关键词查询路:手写迷你 BM25
关键词查询这一路的打分公式叫 BM25,是检索界的老前辈:一个词在这篇文档里出现得越多,这篇文档的得分越高;这个词如果在库里到处都是,就不值钱。打分前得先把文本切成"词",中文没有天然的词边界,我们偷个懒、不引分词库,把相邻两个字配成一对当词用,使用 2-gram——"结构化输出"进来,切成"结构、构化、化输、输出"四块。
from collections import Counterdefterms(s: str) -> Counter:"""中文不分词,字符 2-gram 当词(偷懒但能跑,分词的坑见 §4)。"""return Counter(s[i:i + 2] for i in range(len(s) - 1))defbm25_scores(query: str, chunks: list[Chunk], k1: float = 1.5, b: float = 0.75) -> list[float]: q, docs = terms(query), [terms(c.text) for c in chunks] N, avgdl = len(docs), sum(map(len, docs)) / max(len(docs), 1) df = Counter(t for d in docs for t in d) # 每个词出现在几篇 out = []for d in docs: s = 0.0for t in q:if t notin d:continue idf = math.log((N - df[t] + 0.5) / (df[t] + 0.5) + 1) s += idf * d[t] * (k1 + 1) / (d[t] + k1 * (1 - b + b * len(d) / avgdl)) out.append(s)return out关键设计:不引分词库,先跑通再说;BM25 分数无上界,这正是融合必须用排名而不能用分数的原因。
③ RRF 融合:五行公式
到这一步,两路已经各自交出一份排名:BM25 给关键词路排了一份,余弦给向量路排了一份,两份名单的先后常常对不上。RRF 负责把它们合成一份,规则只有一条:只看名次,不看分数。
defrrf_fuse(ranklists: list[list[str]], k: int = 60) -> dict[str, float]:"""倒数排名融合:score = Σ 1/(k + 名次)。只看排名不看分数, 两路分数量纲不可比的问题从根上绕开。""" scores: dict[str, float] = {}for ranking in ranklists: # 每路是 chunk_id 的有序列表for rank, cid in enumerate(ranking, 1): scores[cid] = scores.get(cid, 0.0) + 1.0 / (k + rank)return scores关键设计:融合分只用来排序,不进拒答阈值。
④ Cross-Encoder 重排:候选池里精挑
from sentence_transformers import CrossEncoder # 新依赖:torch + sentence-transformersclassCrossEncoderReranker:"""Cross-Encoder:query 和文档拼成一条输入打一个分,准,但只能现算。"""def__init__(self, model: str = "models/bge-reranker-v2-m3"): self.ce = CrossEncoder(model, max_length=512) # 本地目录或模型名都能加载defrerank(self, question: str, cands: list[ScoredChunk]) -> RerankOutcome: pairs = [(question, s.chunk.text) for s in cands] ce_scores = map(float, self.ce.predict(pairs)) ranked = sorted(zip(cands, ce_scores), key=lambda p: -p[1])for s, rerank_score in ranked: s.rerank_score = rerank_score # 融合分留着,别覆盖return RerankOutcome([s for s, _ in ranked], True)关键设计:重排的分数没法预先算好(输入里含着问题),每条候选都要把模型从头到尾跑一遍——36 块的小库无所谓,库到几千块,用户每问一句就是几千次模型计算,等不起。所以只对融合后前 30~50 条精挑。重排前后两个分数都留在日志里,方便对比"谁被捞上来、谁被压下去"。引擎有本地 CrossEncoder 和 LLM listwise 两种,谁快谁准,下面"跑起来"用同一套题实测过。
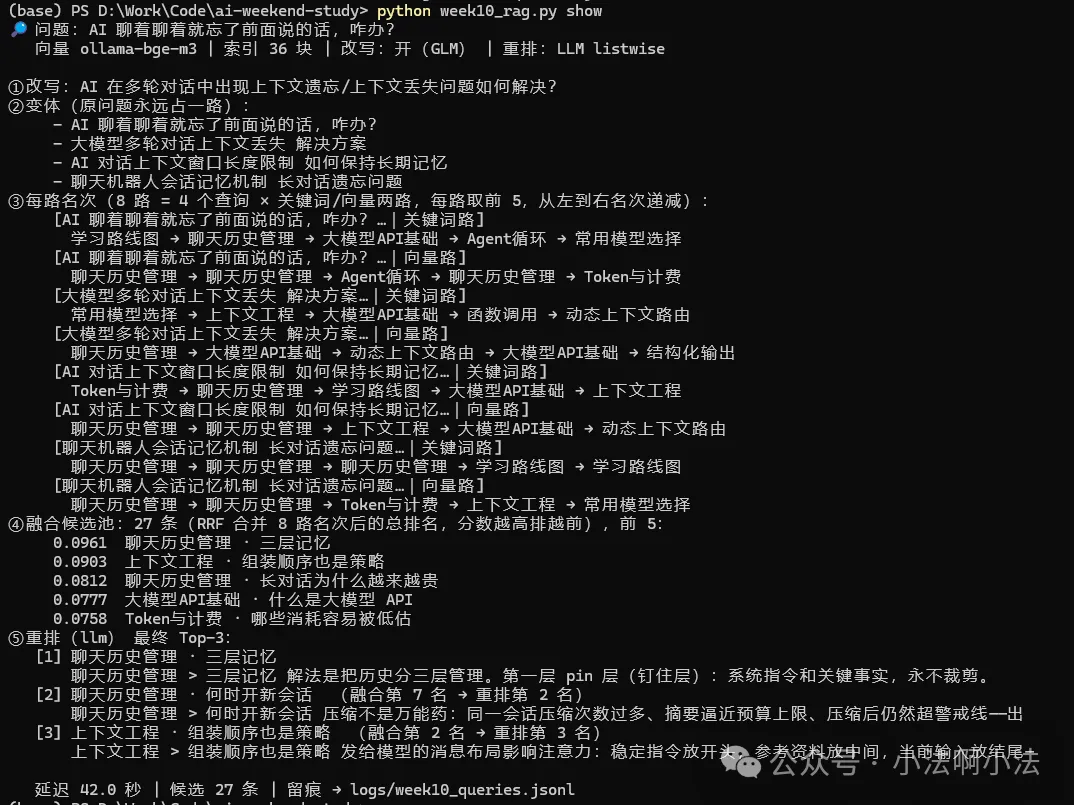
四段代码在 week10_rag.py 里,程序先 rewrite_query 拿到改写和变体,每个变体各跑 BM25 和向量两路;chunk_id 级 RRF 融合后截断 50 条,最后 rerank 取 Top-3。原问题、改写、各路排名、融合分、重排分,整个过程全程留痕,方便排查。
跑起来:四套方案对比实测
10 道口语化题,使用纯向量(基线)、查询改写、改写+混合检索、改写+混合+LLM 重排等四个方案各跑一遍。 其中 9 道是上周原题换了口语化说法,1 道是故意塞了三个子问题的复合题,全部列出:
"AI 聊着聊着就忘了前面说的话,咋办"(期望 06) "让模型按固定格式吐数据,它总不听话"(02) "用大模型一个月大概要花多少钱"(09) "模型怎么自己决定该调哪个工具的"(03) "内网上不了外网,还能不能用大模型"(10) "两份文件里说法打架,AI 听谁的"(07) "AI 干活停不下来怎么办"(04) "网页上扒下来的内容能直接信吗"(05) "temperature 拧到 0 是干嘛的"(01) "怎么给 AI 外挂技能,要花钱吗,用什么模型跑"(复合题,主问题期望 03)
判分标准:每道题的标准答案文档,看它落在检索结果前几名。四个测量指标:Recall@3 看标准答案进没进前三(10 道里进了几道),Recall@5 放宽到前五,Top-1 看它是不是恰好排第一,MRR 是名次综合分(第一名记 1 分、第二名记 0.5、第三名记 0.33,全部题取平均)。简单来说Recall 管找到没有,Top-1 管一击即中,MRR 管平均排多前。
四个方案的成绩摆在一起,差别很清楚。
纯向量基线跑下来,10 道题有 8 道把期望文档送进了前三,Recall@3 是 0.80。这个成绩理论上不应该这么好,原因还是我本地的资料库文档数量少,没有给它上难度。
加上查询改写之后,命中的还是那 8 道题,一道也没有多出来:还是因为这是10 题的小库,口语题靠向量本来就能挤进前五,改写这身翻译功夫没用上劲,唯一的变化是期望文档的平均名次微微前移(MRR 从 0.75 到 0.77,名次综合分,细节看表)。
混合检索这个场景下不但没帮忙,反而把命中数从 8 道拉到了 7 道:BM25 的 2-gram 把"咋办""多少钱"这类口语词切碎,凑巧命中了一堆文档的开头块,忘事和花多少钱两道题被这些噪声挤出了前五——在这个具体的语料上,2-gram 版 BM25 反而起了反作用。
加上LLM重排之后,10 道题全部命中,期望文档全部排到了第一,四项指标全是 1.00。重排比的不是"像不像",是"能不能回答":忘事那道题,库里真正教你怎么办的那一节(《06》的"压缩不是万能药")融合完只在候选池排第 7,重排直接把它提到第 2;复合题在另外三个方案全军覆没,也只有重排把它救回了第一。但是满分的成绩是拿延迟买来的。LLM重排版平均一题要 38.5 秒,基线只要 2 毫秒;重排版的大头全在 GLM 调用上:改写调一次,重排再调一次。
刚才那轮用的是 LLM 重排:把 25 条候选一起发给 GLM,让它从里面挑最能回答问题的。换上专做重排的小模型(bge-reranker-v2-m3,568M 参数,常驻 RTX 4060 显卡)再跑一轮,重排这一步从约 20 秒降到 346 毫秒,快了 57 倍;代价是命中从 10 道变 9 道,排第一的也少了一道,丢掉的恰好就是复合题——小模型逐对打分,掂不出复合题里哪个意图是主意图,而LLM 能把这道题救回来。
基于实验,我们得出选型结论:要速度快的场景(客服、问答助手),用 CrossEncoder,0.35 秒才能满足用户期望;要严谨且不着急的场景,才舍得用 LLM,多等 20 秒换那点准确率。
本次模型和关键配置:
向量:Ollama bge-m3(本地); 关键词:手写 BM25,字符 2-gram,k1=1.5、b=0.75 改写:GLM-5.3-Flash(1 次/题); 重排:LLM listwise(GLM)与本地 CrossEncoder(bge-reranker-v2-m3,RTX 4060)各实测一轮 RRF k=60;候选池上限 50(实测融合后 17~25 条); 最终 Top-3
样本局限:本轮只跑了 10 道口语化题,原题上周测过;题是我自己出题自己标期望文档,口语化的"地道程度"存疑;判分仍是文档级,块级好坏看不见;基线延迟是缓存后的纯比对、其余是 GLM 调用主导,两组数字口径不同,看量级别抠精确值。
4. 我踩过的坑
(以下几条全是本周真实踩到的,按翻车顺序排列。)
5. 当前代码存在的问题与适用范围
已知问题清单:
适用范围:
用户问口语、文档写得书面:政务和企业内部知识库多是这个形态 问题里带错误码、型号、编号、专有名词:BM25 的主场 同一件事用户说法五花八门:多查询扩展的用武之地
会翻车的情况:
私有冷门领域:改写和 HyDE 都靠 LLM 的常识,常识没有就编,编错方向比不改写还糟,必须先配术语词典再谈改写 用户在线等答案的场景:Cross-Encoder 的耗时跟候选池大小成正比,实测 23 条 346 毫秒,池子翻十倍延迟也跟着翻十倍——对话要秒回,候选池就必须压在几十条以内 改写失败回退原问题后还是搜不到:多半是库里真没有,这时该走拒答,不是回去再改写一轮。“没搜到”有两种,一种改写能救,一种只有拒答能救
6. 给读者的提问
留四道我学习时答错或卡壳的原题,答案都在正文里:
两路检索的结果要合并,为什么不能把两边的分数直接相加?RRF 拿什么代替了分数?(提示:想想两路分数的取值范围差在哪) 向量检索能把文档离线编码好存起来,Cross-Encoder 为什么必须等用户来了现算?它俩架构上差在哪? HyDE 拿编出来的假答案去检索,为什么反而比拿原问题去搜更准?什么样的库不能用它? 你的用户提问偏口语还是偏术语?你的知识库里哪类问题最容易漏召回?评论区聊聊。
7. 结尾
上周埋的雷这次拆掉了:先把口语问题翻译成文档中的用语,再使用关键词和向量两路一起查询召回,最后使用重排把最相关的证据挑到最前面。通过这个工作流把检索从“一次向量查询定生死”变成一条每步留痕的流水线。但新问题跟着冒头:Recall@K 高了就等于答案好吗?检索的锅和生成的锅怎么分?评测集、指标、分层归因,下一篇《如何判断一个 RAG 系统到底好不好?》我们继续说。
如果你也想跟着跑一遍,请关注我并私信我,我会把我的代码共享给你