ARTICLE · 1291350
【开源】AI 动画不靠抽卡,让编程助手写代码画
【开源】AI 动画不靠抽卡,让编程助手写代码画
你让视频模型画一段梵高的麦田,风从右往左推。抽到第 14 次,麦浪终于对了,画框右下角却飞进来一只不该有的乌鸦。
不是它画不好,是它根本不听你指挥。
抽卡的三条死路
先算一笔时间账。一条两分钟的艺术解说片,你大概要准备四十个镜头。
用视频模型做,每个镜头平均抽五次才有一条能用,四次废片重置,一下午就过去了。这还只是「画面能看」的标准,没算风格统一。
真正让人放弃的不是成本,是下面三件事:
不可复现。 昨天那条能用的参数,今天无论如何调不出来了。你的工程资产是一堆随手记下的 prompt,和二十个编号混乱的废片文件夹。
不可微调。 你只想把第三秒那行字往左挪四十像素、把节奏压后半秒。没有这个操作,你只能整段重抽,而重抽会把已经对的部分一起打乱。
不可审。 画面里的中文字每次都是糊的、缺笔画。你没法跟它讲「这个字错了」,因为它没有「这一个字」这个概念。
三条加起来,指向一个朴素的结论:当你需要的是一支「讲清楚一件事」的片子时,抽卡这种生成方式的天花板,比你想象的低得多。
你需要精确到帧的节奏、屏上字一个字都不能错、重音必须落在第四十七秒那一句——这些都不是概率能给你的。
换一条路:让它写代码
huashu-art-motion 是花叔(GitHub 账号 alchaincyf)开源的一套 Skill,MIT 协议,v1.2.0,主力是 JavaScript 引擎加 Python 脚本。
它不是剪辑软件,也不是 prompt 合集。它把三样东西整理成 coding agent 能读、能改、能跑的文件:艺术风格怎么画、动画场景怎么搭、解说视频的语法是什么。
它换掉的不是工具,是生成方式:不让模型直接吐像素,而是让它写代码,把画一层层画出来,再让画面动起来。
这个差别一句话就能说清:视频模型输出 mp4,它输出能 diff 的工程。
据仓库页面,项目 10 月 6 日创建,到现在攒了 5800 多 Star,版本已经到 1.2.0。
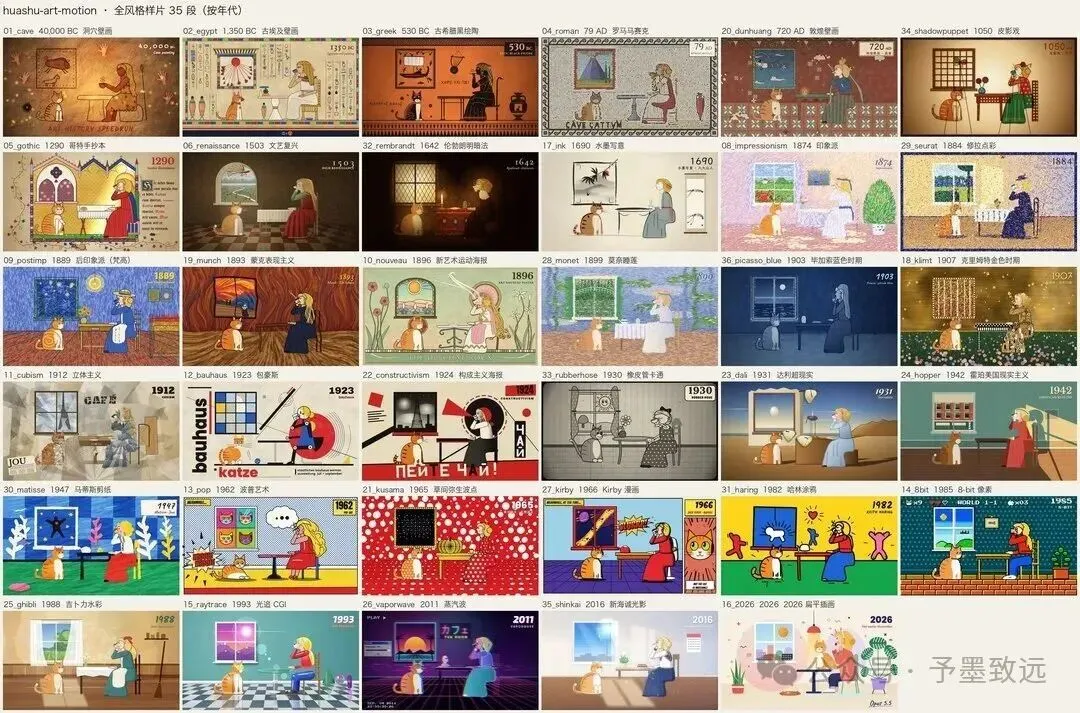
里面是 36 种已实做风格加 16 种研究配方,一共 53 张风格卡,9 种解说语法(其中 8 种能按口播参数直接渲片段)。
一、先拆解,再动手:把参考片变成能写代码的地图
大多数人看到一支好片子的反应是「复刻它」,然后把这个念头翻译成一句 prompt。
这个项目的第一步不是画,是量。
breakdown.py 会把参考视频拆成三样可量化的东西:转场发生在第几帧、节拍网格怎么排、每一段画面里哪里在动(运动热图)。
uv run python scripts/analyze/breakdown.py \ 参考.mp4 --out 拆解/
有了这张地图,"画面里在动" 才从一句感觉变成一组参数:哪个物体的位移曲线在变、哪个图层的透明度在衰减、镜头是缓推还是硬切。
同类对比:prompt 方案里的「复刻这个动画」等于再抽一次卡,抽得像只是运气;这里是先把机制量出来,再用代码重建机制——复制的是方法,不是结果。
这个顺序差异,直接决定了后面所有事情能不能改。
二、先写镜头表,红灯没清不许写代码
这是整个项目里我觉得最值一条规矩。
它要求 agent 动手写代码之前,先填一张镜头表,五行:时间段|画面里的物(名词)|它在做什么(动词)|镜头(停/缓推/横移/砸入)|屏上字(不超过 8 个字)。
然后用一个 lint 脚本卡住它:
uv run <skill>/scripts/storyboard_lint.py \ 我的片子/镜头表.md --script 我的片子/文稿.txt
传了口播稿之后,它还会额外查一件事:屏上出现的数字,和口播里说的是不是同一个数。
别小看这一条。AI 视频最丢人的错误不是画面丑,是画面上写着「增长 47%」,配音说「增长了将近一半」,而数据其实是 39%。这种错在抽卡流程里没人管,因为根本没有「管」的位置;在这条流水线里,lint 会在你开始渲染之前就把它拦下来。
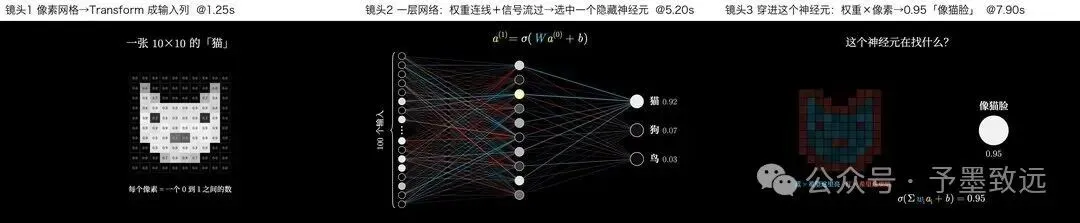
规则还挺细:一镜 2 到 6 秒,开头三秒必须是一个具体小场景(一双手在做一个和题目有关的动作),不是标题卡,文字主导的镜头不超过三成,相邻两镜必须换构图但不能换画风。
这些全是「导演该怎么想」的问题,被写成了可执行检查。
三、画风是参数,不是运气
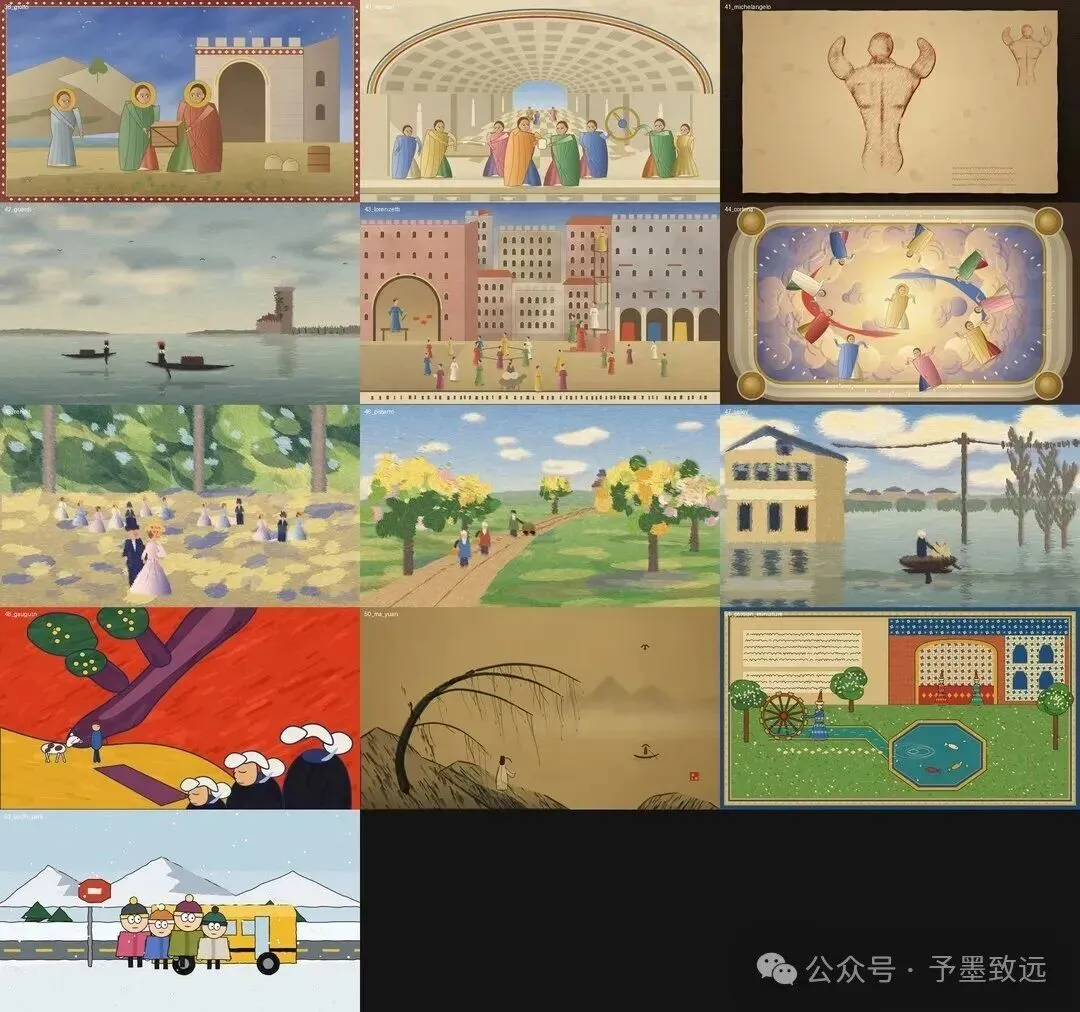
那 53 张风格卡每张都写着四样东西:参数、母题动作、签名转场、当前短板。
最后一项是关键。多数风格库只告诉你「这个风格长这样」,它还会告诉你「这个风格现在哪里做不好」——比如某种笔触一动就露馅、某种材质放大就糊。这是作者自己踩过的坑,写进了卡里。
想先看一帧,一条命令:
uv run --with playwright python scripts/engine/render.py \ --solo 09_postimp --stills 0.3 --out 试渲
--stills 0.3 的意思是只出第 0.3 秒那一帧,不渲整段。这是它反复强调的方法:一帧先行。先确认这一帧的画风对了,再让它动起来。
想整段出片,就换成 spec:
uv run --with playwright python scripts/engine/render.py \ --spec scripts/engine/examples/t3_finance_chart.json \ --out 财经图表.mp4
参数化片段的好处是时长精确到帧,横屏竖屏随便切,还能出透明底——因为它是渲染出来的,不是生成的。
同类对比:在剪辑软件里换画风等于重做整条时间线;在这里,换的是代码里的一个色板、一个 scene id、一个 theme 字段。
四、交付前有门禁,红灯不出片
这条是我认为它和市面上所有 AI 视频工具最本质的分歧。
qa.py 量五个指标:稳定、效率、动感、流畅,以及文字框景(字有没有出界、有没有压到主体)。
film_gate.py 更狠,它只读成片 mp4,量「翻页式 PPT 感」:如果整片几乎没有镜头内的快动作,全是静态图在切换,直接红灯。
uv run scripts/qa.py --spec 镜03.json --out qa/镜03 uv run scripts/deliver.py 成片.mp4 --root . \ --qa qa/镜03 --out output/
红灯是什么意思?deliver.py不会复制成片,它不写交付说明,只打印怎么改。你必须改完重渲、重跑。
还有一道人工关:派一个没参与制作的 agent,只给它成片,让它挑问题。这一招很聪明——因为制作者对片子有感情,看不见自己片子里那三秒的空镜。
对比一下就很清楚:AI 视频工具的终点是「导出」,这里的终点是「过审」。别人把生成当结果,它把生成当中间产物。
五、配乐也不靠素材库
BPM 网格定节奏,动机换乐器做变化,结尾音效序列单独排——全是代码合成,不依赖任何音频素材库。
它那支 98 秒的《Clawd 博物馆奇妙夜》,16 个场景、无口播,配乐就是代码写的。这个细节说明作者把「动画」理解成一个完整的片子,而不是一段画面。
架构:知识不塞进一个巨大 prompt
看目录就懂它的设计哲学:
SKILL.md # 先判断任务,再按表读对应文档 references/ # 方法文档、53 张风格卡、9 张语法卡 scripts/engine/ # 可整个复制走的动画工程 scripts/analyze/ # 拆解 scripts/qa.py # 数字验收 scripts/deliver.py # 门禁 → 复制 → 写交付说明三件事值得说:
一是分档。 SKILL.md 开头先让 agent 自报模型强弱:强模型走「开阔档」,库可以自己组合、渲染器可以自己写;其它模型走「轨道档」,只走一条固定路径,先写镜头表、过 lint、再逐镜做。它承认不同模型能力不一样,而不是假装一套 prompt 能通吃。
二是按需读。 53 张风格卡不会一次塞进上下文,而是靠 INDEX 索引按需取一张。这是 skill 这种形态真正的价值:知识可以很多,但每次只读需要的那几页。
三是经验入库。 仓库里有一份「正面经验」文档,记的是哪些做法被验证有效;每张风格卡里也写着短板。知识不是抄来的结论,是做的时候踩出来的。
快速上手
依赖三个东西:uv、ffmpeg、Playwright 的 Chromium。
npx skills add alchaincyf/huashu-art-motion cd huashu-art-motion uv run --with playwright playwright install chromium uv run --with playwright python scripts/engine/render.py \ --solo 09_postimp --stills 0.3 --out 试渲
第一条命令装 skill,第三条装浏览器内核(第一次跑才需要),第四条渲一帧梵高风格的静帧。
看到那张图对了,再渲一条完整的:
uv run --with playwright python scripts/engine/render.py \ --spec scripts/engine/examples/t3_finance_chart.json \ --out 财经图表.mp4
如果你要一次做完四十个镜头,写个循环比手敲命令稳:
importsubprocessfrompathlibimportPathforspecinsorted(Path(".").glob("镜*.json")): out=spec.with_suffix(".mp4").namesubprocess.run( ["uv", "run", "--with", "playwright", "python", "代码工程/render.py", "--spec", str(spec), "--out", out], check=True, )
最后拼接,全片硬切:
for f in 镜*.mp4; doprintf"file '%s'\n""$f"; done > 列表.txt ffmpeg -y -f concat -safe 0 -i 列表.txt \ -r 30 -c:v libx264 -crf 16 -pix_fmt yuv420p -an 成片.mp4
有三个坑提前说:字体必须先做子集化(仓库里给了 font_subset.py),否则中文渲出来会缺字;绿幕素材要走 key_green.py 抠;单个参数化片段最多撑 8 秒,超了就得拆镜——这是语法本身的上限,不是渲染能力的问题。
它不适合谁
说清边界比堆功能有用。
如果你要的是「一句话出片、出了就发」,不想碰命令行,那这套东西对你是负担,直接开着网页版工具更省事。它要求你愿意写代码、愿意看镜头表、愿意在红灯面前返工。
它真正的用户是那种人:手里有口播稿,知道第几秒该出什么,但受够了抽卡的不确定性。或者做科普、做历史、做财经,画面里的字和数字一个都不能错。
最后
这周我又看到有人在群里问「有没有稳定一点的 AI 视频方案」。
我的答案一直是:稳定不了,因为你要的是确定性,而它给的是概率。除非换一种生成方式——不是让模型猜像素,而是让它写代码把画出来。
这套东西值得看的地方,不是那 36 种风格有多好看,是它从镜头表、lint、一帧先行、qa、门禁到独立审片,把「AI 做的片子」这件事拆成了一条有检查点的流水线。
它不保证你抽到好片,它保证你做的每一版都可以改。
仓库在 GitHub 的 alchaincyf/huashu-art-motion,MIT 协议。注意两点:第九种「讲解员式财经科普」语法需要自备角色素材;花叔的卡通形象和示范片里的 Clawd 形象不随 MIT 授权,只能看不能商用。
如果你也遇到过「抽了一下午,最好的那条再也找不回来」,去看看它怎么把这件事变成可复现的。