ARTICLE · 1301136
AI 测试提效-压测脚本的 AI 体检:先跑规则,再让模型归因
十几条建议看着都对,但没一条告诉你是哪一行
压测脚本生成完,点一下体检,出来一份报告。
报告写得挺像回事:"建议关注并发配置的合理性""可能存在凭据泄露风险"。
看完的感受是:说的都对,但我该改哪一行?
这类报告的通病,是把"可能有风险"当成了结论。真正有用的体检,得先告诉你在哪、是什么、怎么改,然后才轮到解释。
一、体检是两段,不是一段
脚本体检跑两遍:
第一段:静态规则。 不调用模型,不把脚本发到任何外部服务,直接在本地按规则扫。秒级出结果。
第二段:模型归因。 把静态结果和脚本摘要交给模型,让它补充解释、判断影响、给出修改方向。
顺序不能反。
如果先让模型读两千行 JMX,它会漏——不是能力问题,是这类结构化文本太长,模型很难逐行对齐。而规则不会漏,它只认模式。
所以这里的分工是:规则负责"发现",模型负责"解释"。
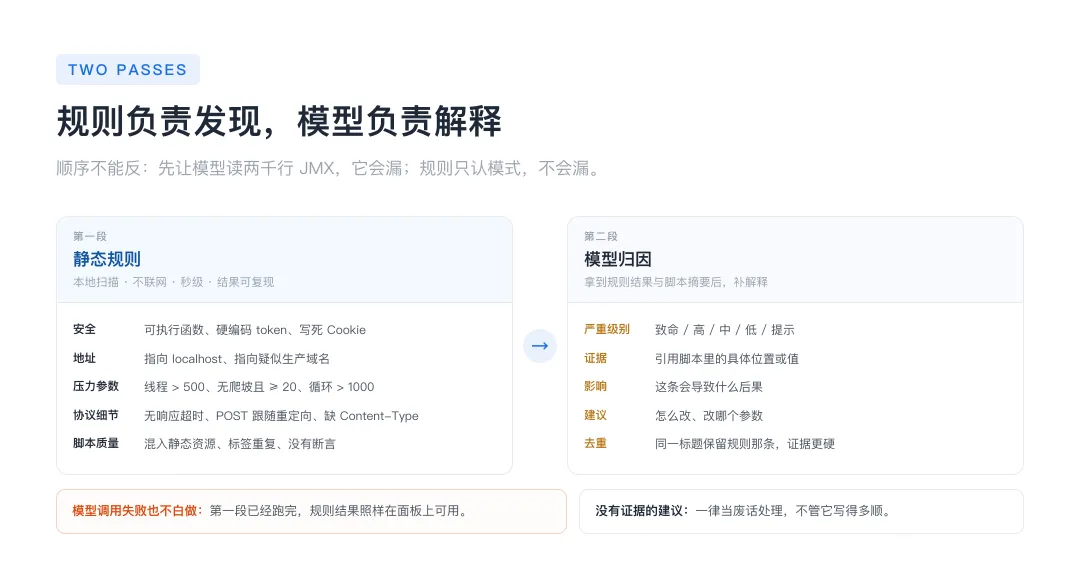
图 1:静态规则先定事实,模型再补归因
二、静态规则查什么
规则按四组来分,覆盖的是压测脚本最容易出事的地方:
这些规则有个共同点:判断依据是确定的。 线程数 501 就是 501,不会因为上下文不同而变成"可能"。
也正因如此,它们值得放在第一步——不花 token,不依赖网络,同样的脚本今天扫和明天扫,结果一样。
三、模型补的是"为什么"
静态规则能告诉你"总线程数 800",但它说不出"这台机器大概率扛不住"。
模型拿到静态结果之后,输出的是结构化的发现项,每条包含:
• 严重级别:致命 / 高 / 中 / 低 / 提示 • 分类:安全、性能、配置、脚本质量 • 标题:一句话说清问题 • 证据:引用脚本里的具体位置或值 • 影响:这条会导致什么 • 建议:怎么改 • 修改提示:改哪个参数
关键是"证据"这一栏。没有证据的建议,一律当废话处理。
模型和规则可能给出同一个问题。这时会按标题去重,保留规则那条——因为规则的证据更硬。
四、四个阶段,卡在哪一目了然
体检过程通过流式事件推进,面板上能看到四个阶段:
1. 静态规则:本地扫描,通常很快; 2. 构建摘要:把脚本压缩成模型能读的形态; 3. AI 复核:模型分析; 4. 推理:输出解释。
如果界面停在「AI 复核」不动,那是模型在等返回,不是程序死了。静态规则那一段早就跑完了,结果也已经在了。
这个设计的好处是:即使模型调用失败,静态规则的结果依然可用。 不会因为 AI 超时,整份体检就白做。
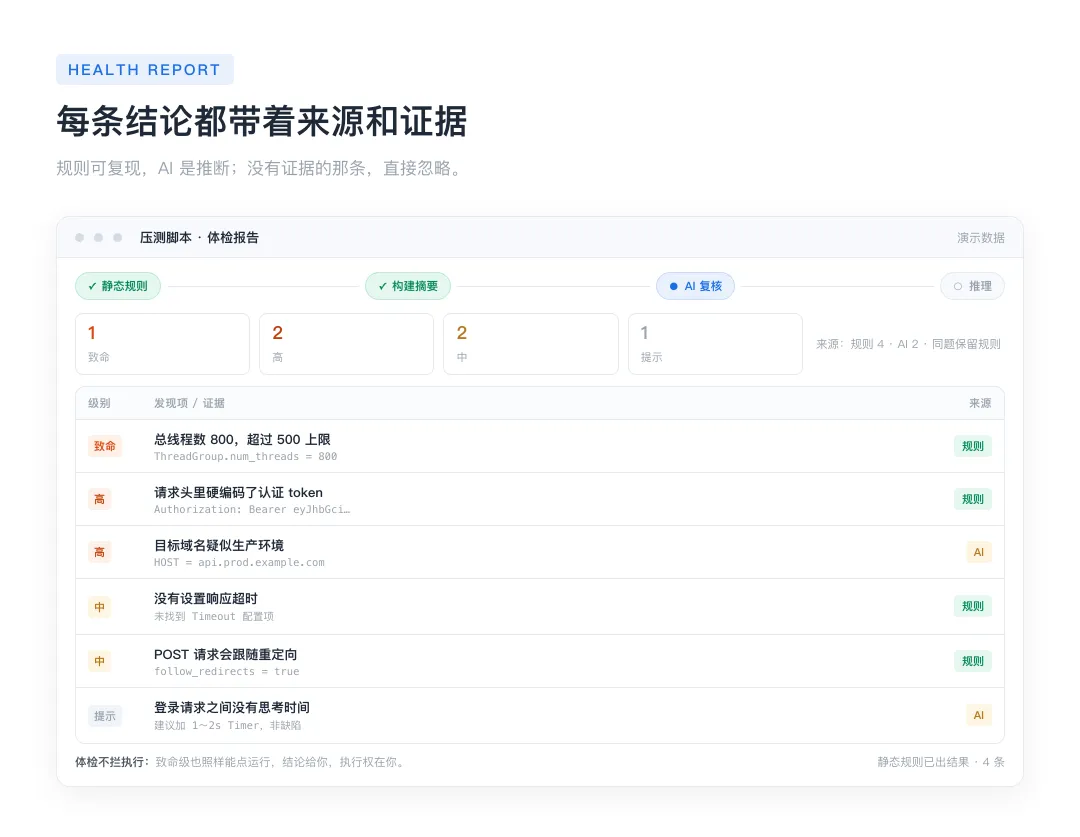
图 2:体检面板里的严重级别与来源标签(演示数据)
五、每条结论都标了来源
面板上每条发现项都带一个来源标签:规则 或 AI。
这个标签不是装饰,它决定了你该怎么信:
• 规则:可复现。你可以自己去脚本里数线程数、搜 token。 • AI:是推断。要回到脚本里核对证据那一栏,确认它引用的位置真的存在。
一条 AI 结论如果没有具体证据,正确做法是忽略,而不是"宁可信其有"。
六、体检不拦执行
这一点要说清楚:体检结果不会阻止你点执行。
哪怕出现致命级问题,脚本依然可以跑。
为什么不做成闸门?因为压测脚本的场景太多:有人就是要在内网压一个故意配置得很激进的脚本,有人需要复现一个已知问题。一刀切拦住,会把正常路径也堵死。
代价是:它给结论,执行权在你。 看到致命级还往下点,后果自己承担。
七、怎么用这份报告
建议按这个顺序处理:
1. 先看致命和高:这些是会直接导致压测结果失真或出安全问题的; 2. 按分类批量修:同一类问题往往一次能改一片,比如所有请求的超时; 3. 中级别挑着改:和这次压测目标相关的改,无关的记下来; 4. 提示级直接跳过:它只是提醒,不是缺陷; 5. 改完重扫:条数应该下降,尤其是规则来源的那几条。
第五步最容易被省。改完不重扫,你并不知道自己改对了没有。
必踩的四个坑
坑一:把提示级当缺陷。 提示级的含义是"你可以看一眼",不是"这里有问题"。全部按高危处理,报告就没法读了。
坑二:只看 AI 结论,不看来源。 AI 说得越顺,越要回去核对证据。规则给的结论反而更值得直接采信。
坑三:体检通过就以为能压生产。 体检查的是脚本本身,不查你的授权、不查目标环境、不查数据准备。
坑四:修完不重扫。 改了三处,可能引入两处新的。重扫一遍,成本很低。
丑话说在前面
脚本体检解决的是"这份脚本写得对不对",不解决另外三件事:
• 它不是渗透测试,不验证目标系统的真实漏洞; • 它不是容量评估,不告诉你系统能扛多少并发; • 它不检查业务正确性,不判断响应内容对不对。
另外,规则覆盖的是已知的高频问题。你的业务如果有特殊约束——比如某个接口必须串行、某个 token 只能单次使用——规则不会知道,模型也未必看得出来。这部分只能靠人。
体检的价值,是把你从"逐行读 JMX"里解放出来,让你把注意力放在它标出来的那几处。它不是替你下结论,是替你排队。
下次生成完脚本,先扫一遍,先看致命级,再决定要不要跑。这一步花不了一分钟。
关于怎么把 AI 用进测试流程,我们一直在做这件事。想看某个模块的完整操作路径,或者想让我们拿你的场景跑一遍,发邮件到 clzc_ai2026@qq.com。