ARTICLE · 1301724
我删掉7个AI助手,才读懂DeepSeek这份开源文档的第一句话
我电脑上有个 4.99GB 的文件夹,11 月 1 日被我删干净了
里面装着 7 个 AI 助手。
用得越多,我的注意力越不够用。
过去一个多月,它们替我盯信源、写稿、配图,还管排期和复盘,每天早上准时给我发一堆报告。
我数了一下,真正需要我动手的消息一天不到 5 条,剩下的全是它们在互相汇报进度。
删完看了一眼 C 盘:可用空间从 8.66GB 变成 13.76GB。
腾出来的这 5 个 G 里,装的其实是我这一个月交的学费。
巧的是就在前一天晚上 8 点半,DeepSeek 开源了一份东西,第一句话就把这笔学费的用途写明白了——
「用最少的人类注意力,换最大的价值。」
不是新模型,也不是又一个 Agent 框架。
它是 9 篇设计文档,加一个真能跑起来的研究原型,10 月 31 日晚上开出来的,MIT 协议,仓库 3.9MB。
能干的事窄得很:只服务一个 GitHub 仓库,听仓库的动静,可选接飞书。
有人在群里或评论里提了个需求,它判断这算不算活;算,就开一张工单,在自己的目录里干完,回到原来的对话说话,通常是一个 PR。
面板上只显示「需要人处理」的东西,一切正常的状态不占位置。
就这些,听着平平无奇。
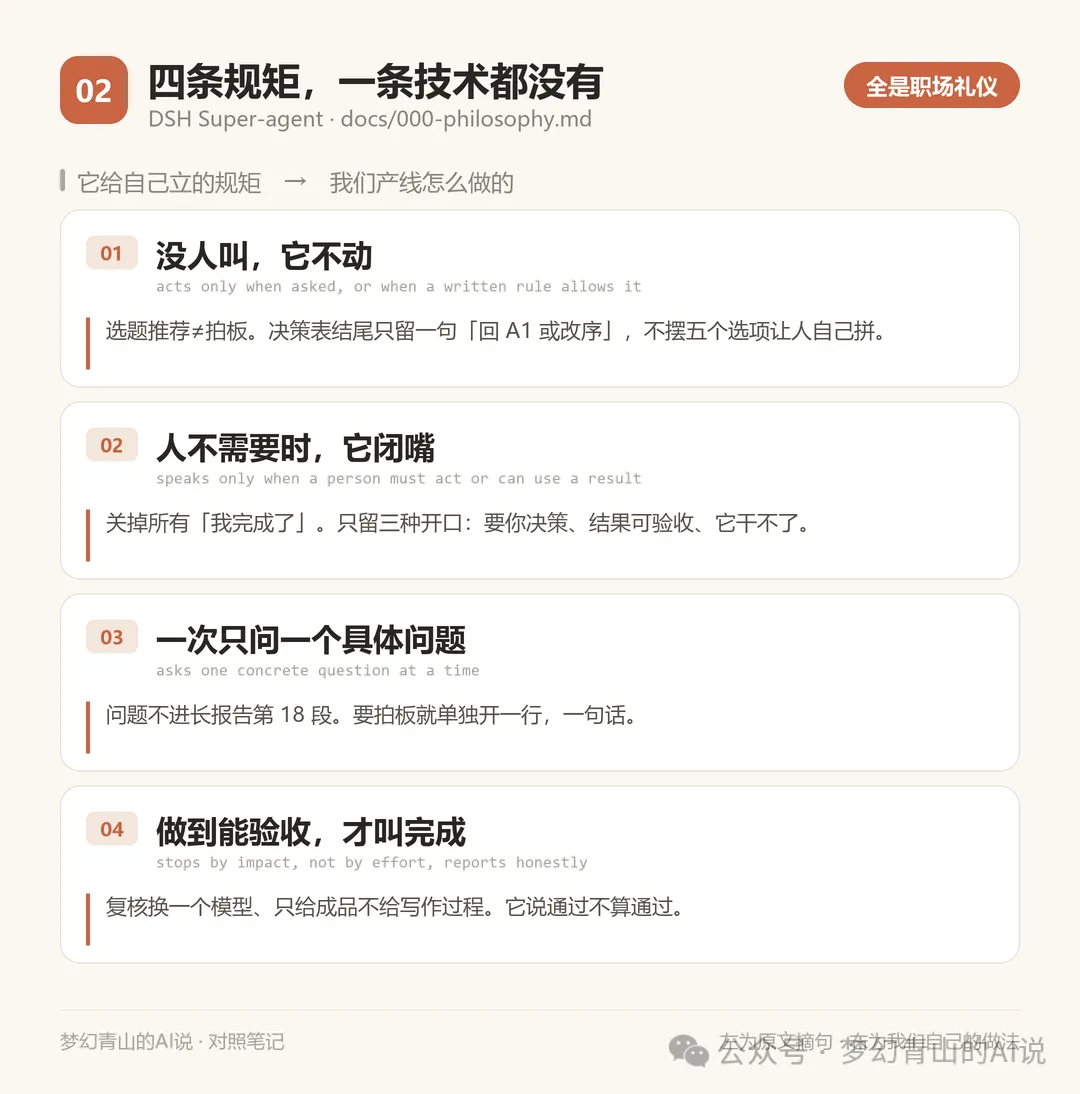
真正值得抄的不是架构,是它给自己立的四条规矩。
规矩一:没人叫,它不动。
文档原话是「只在被请求时行动,或者在团队写下来的规则允许时行动」。
没人要求的活,它先进「只记录不执行」的状态:想一想,写进本子,不真干。
规矩二:人不需要的时候,它闭嘴。
干活期间一声不吭。只有三种时候能开口:要你做决定、结果好了请你验收、它干不了。
消息还得短,并且要回到当初提需求的那个对话里去说。
规矩三:一次只问一个具体问题。
而且要走结构化表单,别把问题埋在一份长报告的第 18 段。
规矩四:做到能验收为止,然后如实汇报。
本地小改就交到「能评审」的程度;需要拍板的地方停下来问;失败就说失败,不许为了少问一句而绕过限制。
我读这四条的时候愣了一下。
没一条是技术。
全是职场礼仪。
而这两件事的难度正好反着:模型会不会写代码,是能力问题,一年能翻一倍;肯不肯闭嘴,是教养问题,写多少提示词都不一定有。
说白了,我们这套产线不是看了它才这么设计的,是被噪音逼出来的。
9 月的版本是七个 bot 分工:采信源、写稿、复核是一拨,配图、发布、复盘是另一拨,各管一段。
听着分工明确,跑起来像七个部门开会。
10 月 19 日砍成一个调度者:所有工序排成一条线,每道工序开一个独立会话,工序之间只靠磁盘上的状态文件交接。砍完最大的变化不是效率,是安静。
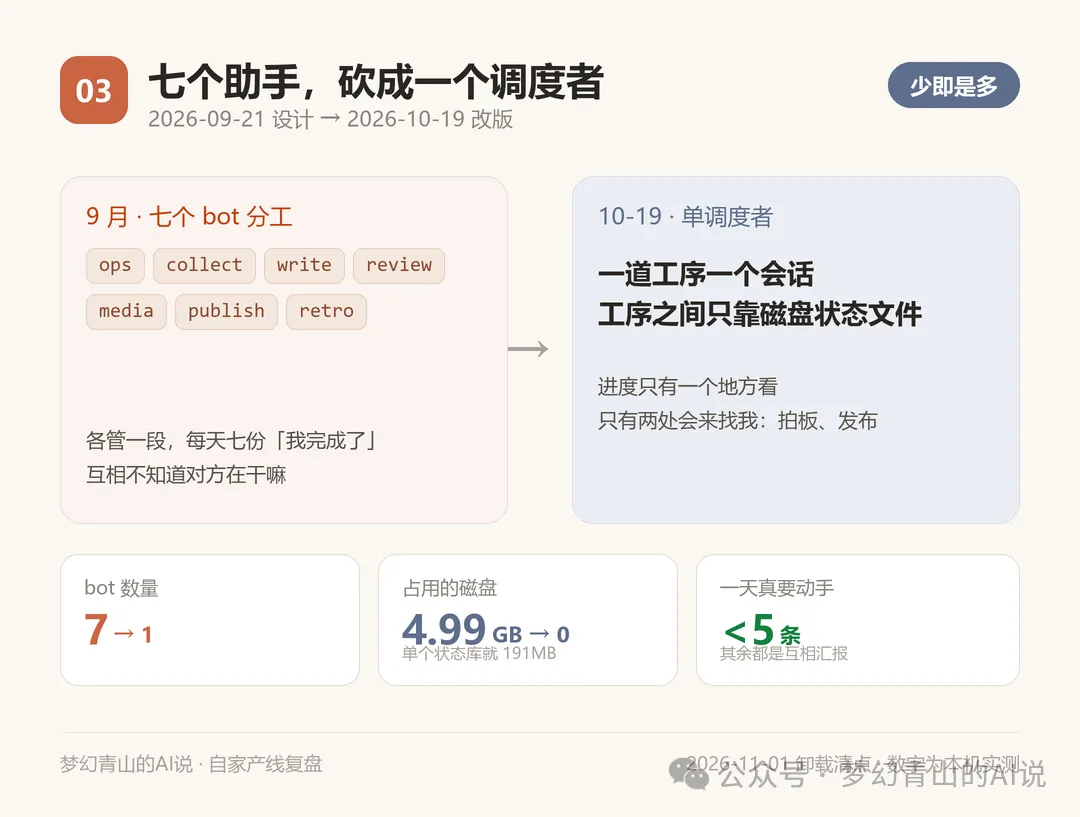
以前我每天要读七份「我完成了」;现在只有一个地方能看进度,而且只有两处会来找我:选题要拍板、发布要确认。
这两处,正好就是它说的「人必须行动」。
第 4 条规矩,我们也有一条几乎逐字对应的:复核必须换一个模型,而且只给复核者成品,不给写作过程和自报数据。
为什么定这么死?
因为「AI 说自己都通过了」这件事,我吃过亏。它说通过的时候,十次里有三次只是它没看懂哪里会错。
顺带说一句,这条也治了我一个毛病:以前我写完就爱问它「你觉得行吗」,它永远说行。现在我学会了让另一个它来挑刺。
规矩三我们更早就撞上了。这套产线的选题决策表,结尾只有一句:「回 A1 或改序」。
不列菜单,不摆五个选项让你自己拼,就一个问题。
被删的那 7 个里,有 3 个是定时自己跑的。
一个早上采信源,一个中午出报告,一个晚上做复盘。真的很勤快。
问题就出在「勤快」。
采信源那个,抓到一条两周前的旧闻,照样当成新选题报给我;复盘那个,写了一千二百字,结论是「阅读量有波动」。
我看完那一刻的感觉,跟收到一封 1200 字只写了「已阅」的邮件一模一样。
更麻烦的是它们互相不知道对方在干嘛。
A 说开始,B 说完成,C 说它发现 A 漏了一步。通知栏一天响几十次,最后我把通知全关了。
关掉之后它们还在跑,只是我不看了。
那不叫七个员工,那叫养了七个员工然后假装自己没开公司。
还有一笔更硬的账:这 7 个助手占了 4.99GB,其中有一个状态库单独吃到 191MB。
它们记的东西比我记得多,用的东西比我用得少。
我把它源码掰开看了一遍,机制不复杂。外层一个调度器,管上下文、分任务,也只由它对外说话;里层是一组隔离的执行体,各干各的,不许越级跟人讲话。
四个细节挺值得记:
接手一个 PR 之后,这个执行体会直接订阅后续评论。别人再提意见,消息直接到它手上,不用层层转发。
它会先偷偷试。群里有人提了个 bug,它自己先去复现、先修;修好了才交出来,修不好就一声不吭,当没发生过。
消息进来先过一道程序规则:谁发的、哪个群、在不在白名单里;筛完剩下的才交给模型判断要不要动手。外面还挂了一个看门狗进程,专看谁死循环、谁跑偏。
官方给的实验数字是:300 条消息、20 项请求、每种配置跑 5 次,p95 完成时间从 29.5 分钟压到 15.7 分钟。
天下没有只赚不赔的调度。
文档里有一句我挺服气的话:砍掉「事件直通」这个机制之后,调度器的决策次数多 30%,缓存读取的 token 多 37%。
翻译成人话:省下来的是人的注意力,花出去的是算力和 token。
这笔账在内容侧也一样。我们一条 78 秒的竖版视频,渲染要跑 1176 帧、33 分钟;配音到现在累计花了 0.94 元。
自动化不会让成本消失。它只是把成本从「人盯着屏幕」换成「机器转着风扇」。
所以如果有人跟你说「装了它就省时间」,你可以回一句:省的是你的手,不是电费。
本机 Windows,Node 22,clone 两分钟,装依赖 29 秒。我还在等着它报错,它已经把自带的三步自检跑完了:类型检查、1197 项测试、打包。类型检查一行没报错,打包 11 个文件、693KB、11.8 秒,快得让我有点不习惯。
只有测试难看:59 个文件 1197 项,1158 项通过,39 项挂了,用时 82 秒。看到 39 这个数我第一反应是离谱,然后逐条看完,不是扫一眼。
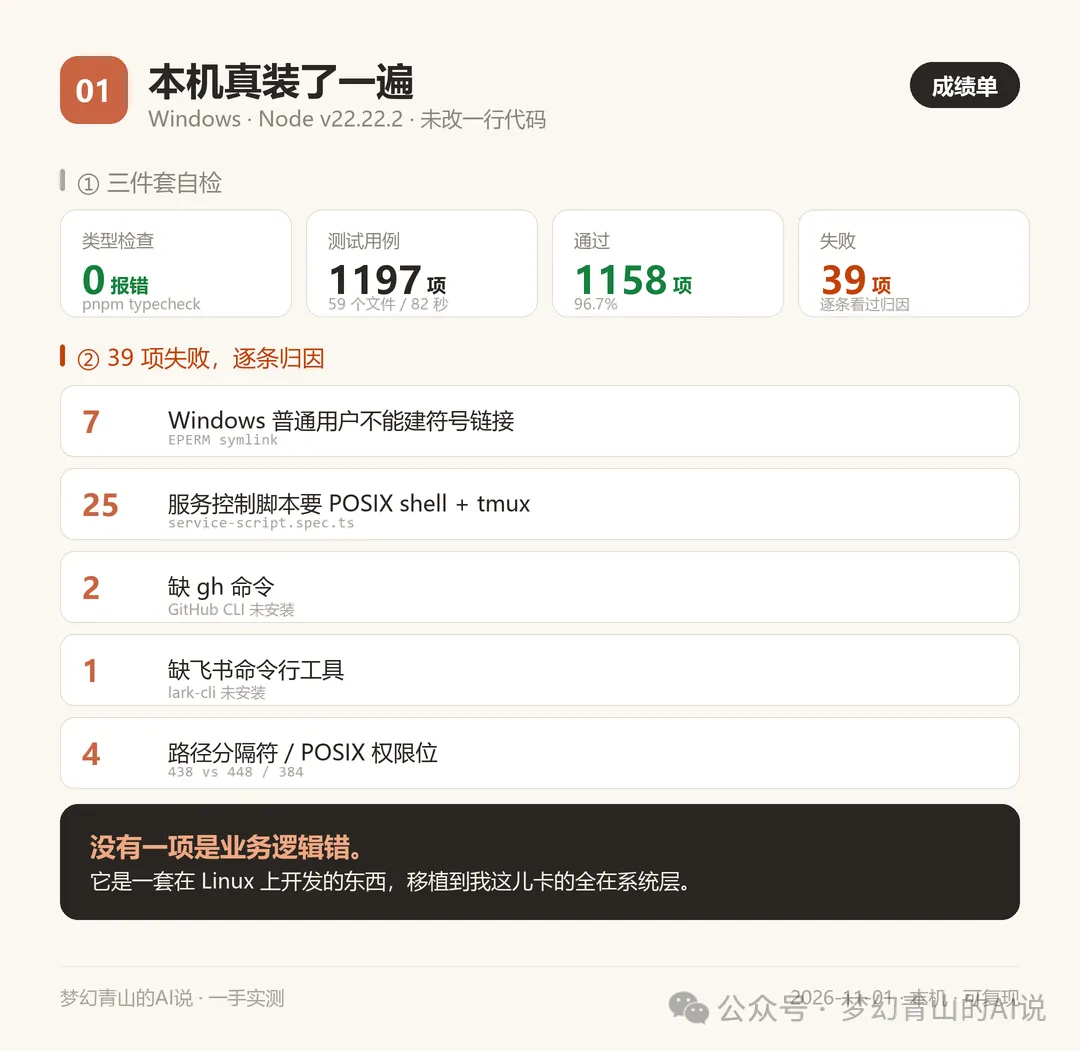
7 项是 Windows 不给普通用户建符号链接。
25 项是它的服务控制脚本,POSIX shell 加 tmux,我这儿没有。
2 项要 gh 命令,1 项要飞书命令行工具,我都没装。
剩下几项是路径分隔符和权限位。
没有一项是业务逻辑错。
这份成绩单其实挺说明问题。它 README 第一段就写着:研究原型,不是官方产品,可能有 bug,别直接上生产。
我一开始当法务话术看。
跑完这 39 项失败,我信了——它是一套在 Linux 环境里长出来的东西,搬到我这儿水土不服,不服的地方全在系统层,不在脑子。
再说个体量:9 篇编号文档 1973 行,12 个提示词文件 291 行,光架构文档一篇就 617 行。
但最该读的是第一篇,33 行,标题两个字:哲学。
我干这行有个偏见:一个工具好不好用,先看它敢不敢写「什么不做」。
那 33 行里,有四条是写给运营者的:
从小范围开始,先短名单、主动的活只记录;吵了就缩短提示词或者直接暂停,别再加消息去解释噪音;不要拿它刷量;它用你的名义说的话,你负责。
最后一句是整份文档里最狠的:目标是「在对的时候给对的帮助,其他时候什么都不给」。
我们这边对应的是另一句话,写在流程文档的铁律里:决策表必须用户拍板,推荐不等于拍板。
看着像废话。但正因为写了这句,我才没在某个深夜被自己的 AI 推着发出去一篇没看过的东西。
你要的是一个能管微信、能改 Excel、能替你回客户的助手,它不是。它只服务一个代码仓库。
你不想配 GitHub 凭证、不想折腾飞书应用,它跑不起来。
它文档里还有一部分设计明说只是方向,原型里没实现。Windows 上 39 项测试挂,也说明官方主要在 Linux 上验证过,为它单独折腾一套环境,犯不上。
所以别急着装。真的。
这堆文档对咱们这种不写代码的人,真正有用的地方不在装,在抄。四个动作,一个晚上能干完:
第一,把「定时自己跑」的助手先全关掉,只留你叫它才动的。
第二,把所有「一切正常」「已完成」的通知关掉,只留三种:要你决策、结果可验收、干不了。
第三,每次只给它一个问题,别一口气抛十个选项让它自己挑。
第四,它说「已完成」不算完成,要它交能验收的东西:一个文件、一张截图,或者一行数字。
如果只改一处,我建议先改通知。
不是让 AI 少干活,是让它的活别都堆到你眼前。
那 7 个助手的通知关掉之后,第一天我有点不习惯,第二天开始才发现,自己每天有整块的两小时没被打断过。
这两小时,比我少装七个助手值钱多了。
你现在手机上有几个 AI 在后台自己跑?评论区报个数,我看看有没有比我更夸张的。
觉得这四条有用的,点赞告诉我一声。