ARTICLE · 1301900
" 不刷题的 AI:腾讯交了 6 件工具,都能查"
先说判断:答案和工具不是一回事
8 月发布的 Hyra 1.0,用国产开源模型解出了加法组合学里一个悬了五十多年的问题,当时被说成国产模型第一次。
那件事很漂亮。但混元自己在 11 月 2 日的发布里提了个问题:解出一道题,收获的其实只是一个答案而已。
它不会让下一次解题更容易,智能复利是零。
工具就不一样。升级一件工具,所有用到它的下游任务都跟着受益。
所以 Hyra 2.0 换了个目标:不是让它解题,是让它造工具。这次一并交出来的,是六件。
拆解:先看清交的到底是什么
先交代一句:这批东西不在新闻稿里,在 GitHub 上:Tencent-Hunyuan/Hyra-results。
我查了这个仓库。它 7 月就建了,不是这两天临时搭的。AI4AI、AI4Fun 两个目录的提交在四个月前,AI4Science 下面现在躺着 18 个子目录,对应 18 个问题。
11 月 2 日新放进去的是四个目录,加上另外两件,凑成这次的六件。
挑三件说。
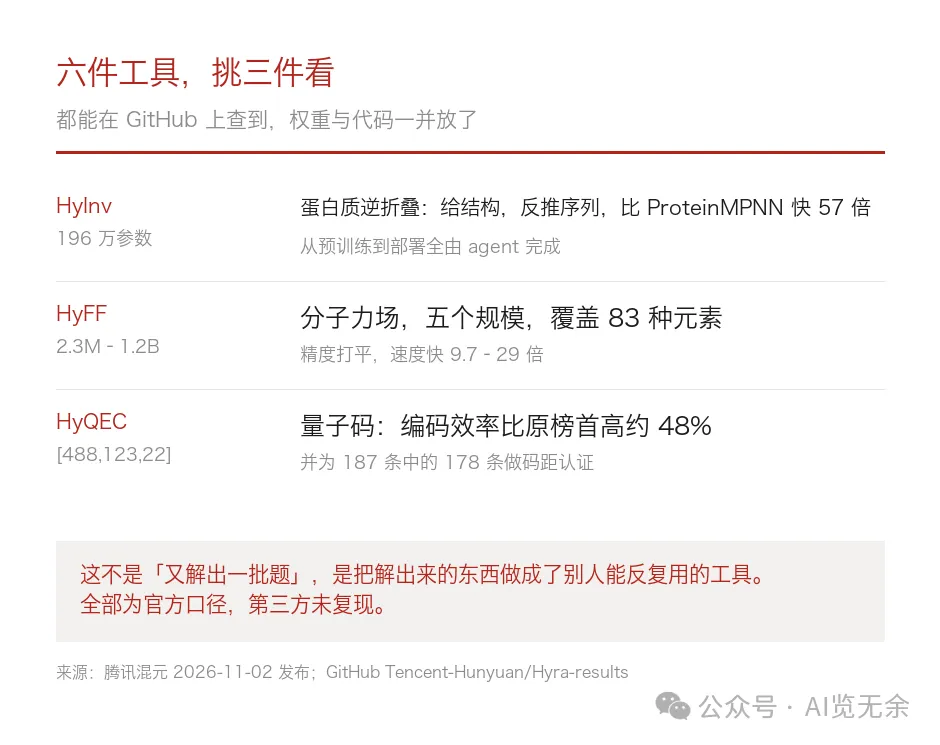
第一件:196 万参数,比行业标配快 57 倍
HyInv,做蛋白质逆折叠。给你一个目标骨架,让它反推出能折叠成这个结构的序列。
说白了就是看结构猜序列。
它只有 196 万参数。对比一下,制药行业常用的 ProteinMPNN 是它的几十倍。
官方说生成速度快 57 倍,吻合度还更好,50 毫秒就能出 128 条序列。它举的用途是药物设计、酶工程和文库构建。
这个模型有点意思的地方在于:从预训练一路到微调和推理优化,整个流程都是 Hyra 自己在跑。这是从「加速别人的模型」跨到了「从头做出一个新模型」。
第二件:力场这个行当,精度打平、速度快 20 倍以上
HyFF,分子模拟用的机器学习力场。五个规模,230 万到 12 亿参数,覆盖 83 种元素,在 OMol25 数据集上训练。
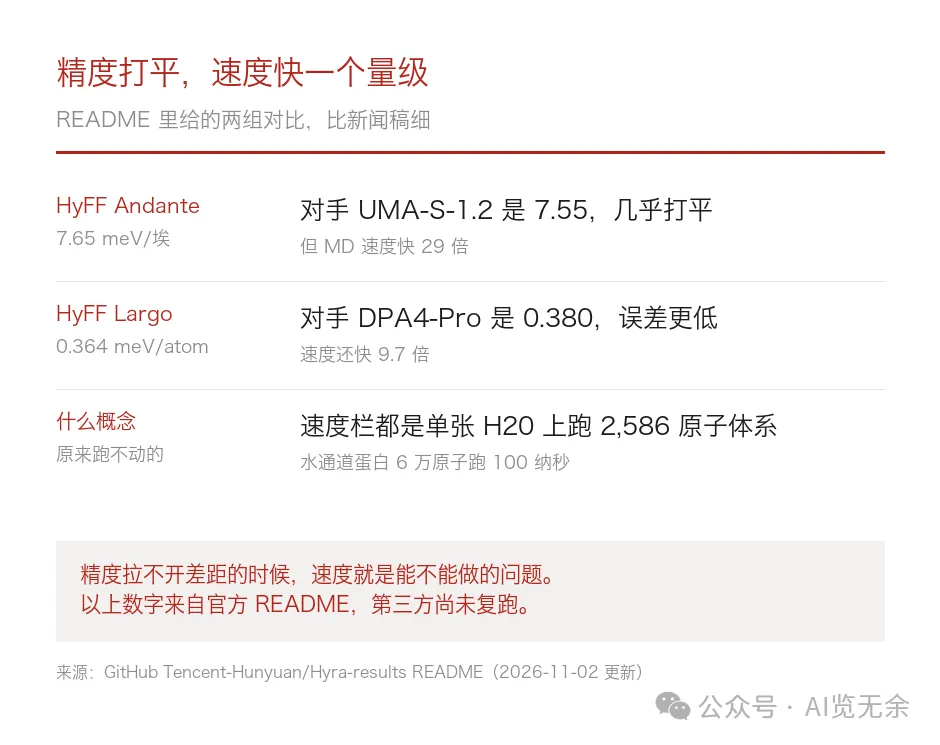
README 里给了两组很具体的对比,比新闻稿细得多:
| 快 29 倍 | |||
| 快 9.7 倍 |
(速度那栏是单张 H20 上跑 2,586 原子体系的结果。)
翻译一下:Andante 的力误差比对手高了 0.1,基本算打平;但跑起来快 29 倍。Largo 反过来,误差更低,速度还快 9.7 倍。
精度打平、速度差一个量级,这在分子动力学里是有意义的:原来跑不动的体系,现在跑得动了。
官方举的例子是近 6 万原子的水通道蛋白跑 100 纳秒,能看见水分子排成单列穿过膜。
第三件:两个数学猜想,但要看清限定
这块最需要小心,中文报道把它写大了。
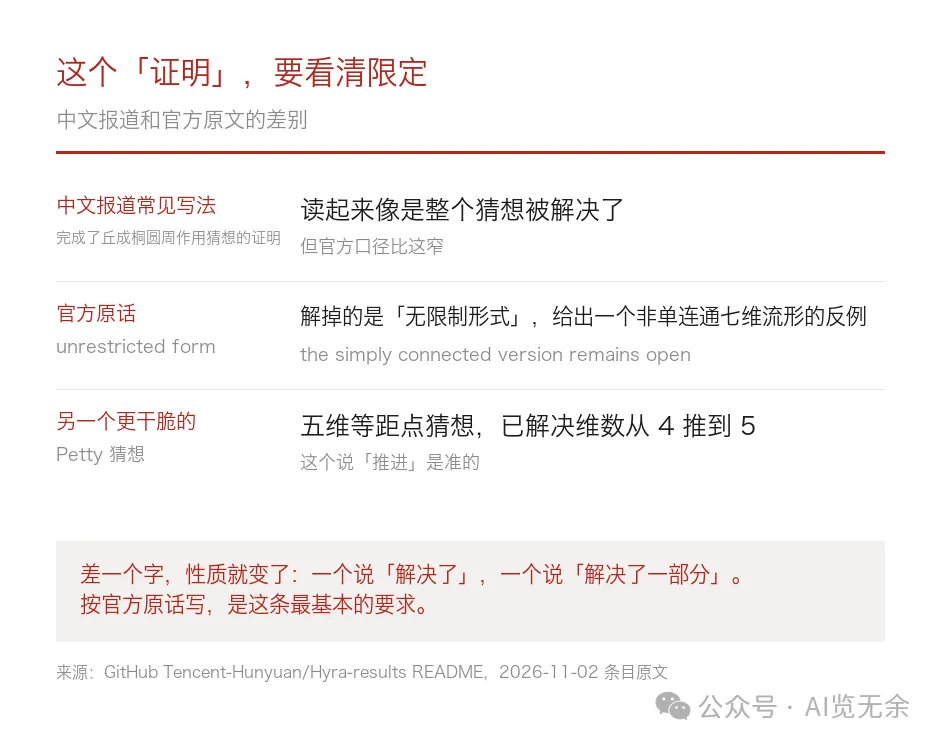
中文报道普遍写「HyProver 完成了丘成桐圆周作用猜想的证明」。我去看了 GitHub 原文,官方自己的表述比这窄:
Yau's circle-action conjecture (unrestricted form). A closed seven-manifold with strictly positive sectional curvature admits no effective smooth circle action, giving a counterexample. The manifold is not simply connected; the simply connected version remains open.
意思是:解掉的是无限制形式,给出的是一个非单连通的七维流形反例;单连通版本仍然没有解决。
这跟「猜想被证明了」不是一回事。我把这句原话摆在这儿,是因为差一个字,性质就变了。
同批还有一个更干脆的:Petty 五维等距点猜想,把这个问题的已解决维数从 4(Makeev, 2005)推到了 5。这个说「推进」是准的。
更值得看的不是成果,是它怎么干的
六件东西只是结果,更值钱的是那套流程。
Hyra 2.0 分三层。Overall 跟人对接,管优先级和资源。Mission 长期盯一个研究问题,定研究路线和实验设计,对结论负责。Worker 干活,读代码、跑实验,还可以质疑 Mission。
真正让我停一下的是它的证据规矩。
Worker 交差时必须附代码版本和实验结果,还有日志或原始轨迹。Mission 要去翻实际操作记录,看实验到底支不支持报告里那个结论。
需要独立验证时,系统会另起一个 Review Worker,先让它接触原始问题和证据,再去看结论。这样它不容易被执行者的说法带偏。
这条设计看着朴素,但它解决的是一个真问题:AI 自己做的研究,怎么知道它没在自说自话。
这算不算「AI 改进 AI」
混元自己在文里点了这个:Hyra 2.0 参与升级训练基础设施,帮着训下一代混元模型;下一代模型又成为它手里的工具。
这个循环如果真的能转起来,就是所谓递归自我改进,也是这波 AI 里最值得期待、也最该警惕的东西。
但得说清楚:官方给的是一句描述,不是一个已经验证的闭环。 我在 GitHub 上没找到对应的评测或数据。
但真正能说明问题的,是下一代混元模型出来时,有没有说清楚「哪些部分是这个系统做的」。
对你意味着什么
如果你不关心科研,这条离你有点远。但有两类人可以往下想。
做研发管理的。 这套三层分工加上「证据必须附原始日志」的规矩,是能抄的。哪怕你用的不是 Hyra,只要你的 agent 在跑长任务,这套「独立复核 + 分级记忆」都会用得上。
关注 AI 泡沫的。 11 月 2 日那份 Anthropic 财报说明了一件事:算力越来越贵。
而 Hyra 这类东西,如果能真的把科研成本打下来,那就是另一条路:不是让模型更聪明,是让同样的聪明被反复用。
至于那六件工具,权重和代码都放了。你要是真有相应算力,可以去跑一遍,看是不是真的比对手快 57 倍。我给不了这个验证,只能给到官方口径。
结论
回到开头那句:答案和工具不是一回事。
一道题的答案,用完就没了。一把尺子做出来,谁都能拿去量。
这次真正值得记的不是「AI 又解了什么难题」,是它开始造能被别人反复用的东西了。而且造出来的东西摊在 GitHub 上,能查、能挑错、能被打脸。
这比再多解十道题更有分量。
你所在的行当,有没有那种「一次做好、所有人受益」的活,正在被 AI 接过去?评论区说说,我想听听具体的。
AI 圈的事,搜「AI 览无余」就有——不追热搜追数据,每篇都标出处、都算给你看。