ARTICLE · 1303854
把Harness拆成插件,美团*中科大PluginRSI实现Agent分块式自进化
Everything is a plugin(万物皆插件)。
--DeepSeek Harness
同样一个大模型,换一套Harness,任务完成率会出现巨大差别,于是学术界兴起了Harness递归自优化,让另一个AI智能体阅读任务执行记录,找出失败原因,自动改写整套Harness代码,迭代出更好的智能体外壳,全程不需要改动底层大模型权重,成本远低于重新训练模型。
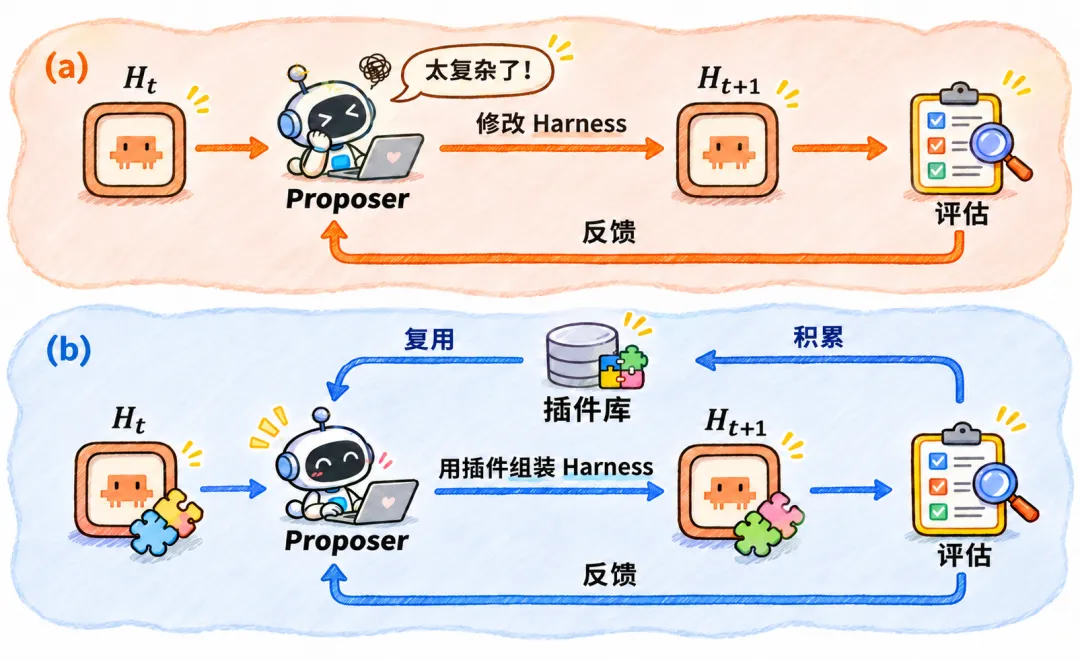
但旧的进化模式有一个绕不开的痛点:一改写就是全盘重写,好点子容易丢,经验无法沉淀复用。如果把每次修改背后的判断规则做成一个可替换、可验证的插件,下一个智能体遇到类似任务时,就有机会直接用上它。中国科学技术大学、美团、武汉大学和新加坡国立大学提出的PluginRSI 研究的正是这件事。
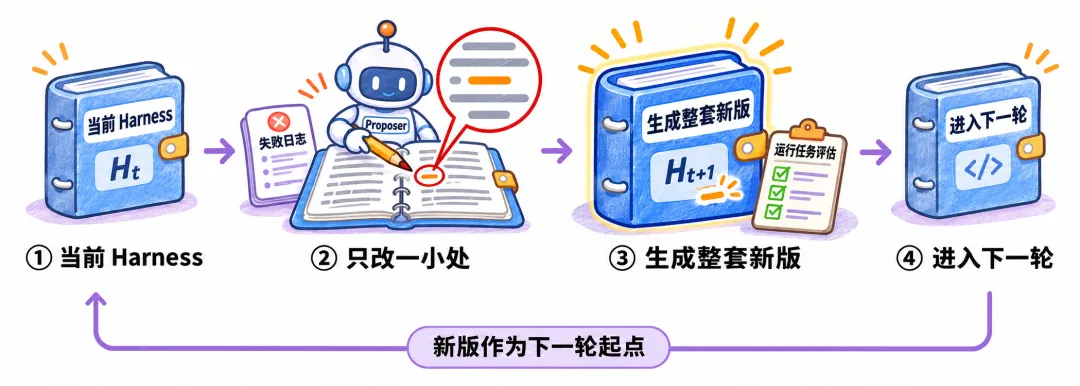
过去主流的Meta-Harness、DGM这类自进化算法,工作流程很直白:
- 拿出当前完整的整套Agent外壳程序;
- 另一个AI智能体通读全部代码和任务失败记录,直接修改整个Harness;
- 生成新版本,跑任务评估效果;
- 拿新版本继续下一轮迭代。
这种“整体大改”的模式有两个致命短板:
- 很难单独测试某一个想法:Harness里面混杂记忆逻辑、工具逻辑、角色提示、执行流程,一堆机制耦合在一起。如果你想测试“优化记忆检索逻辑”这个点子,修改记忆模块之后,流程、工具全部跟着一起变,你分不清性能变好/变坏,到底来自记忆,还是别的模块。
- 来之不易的好机制容易被覆盖丢失。比如这一轮迭代摸索出一个非常好用的终端报错反馈逻辑,但下一轮全盘改写Harness的时候,AI一不小心就把这段优秀代码删掉。每一轮进化都在推倒重来,经验很难代代积累,经常反复收敛到差不多的方案,浪费大量计算资源。
当几个机制写在同一段程序里,往往得重新读代码、拆依赖,再做一轮验证。
PluginRSI的核心思想是不要反复改写完整Agent外壳,把Harness拆成一个个独立插件(Plugin),进化零件,把验证有效的零件存入共享工具箱,后续拼装新Agent直接复用这些成熟零件。
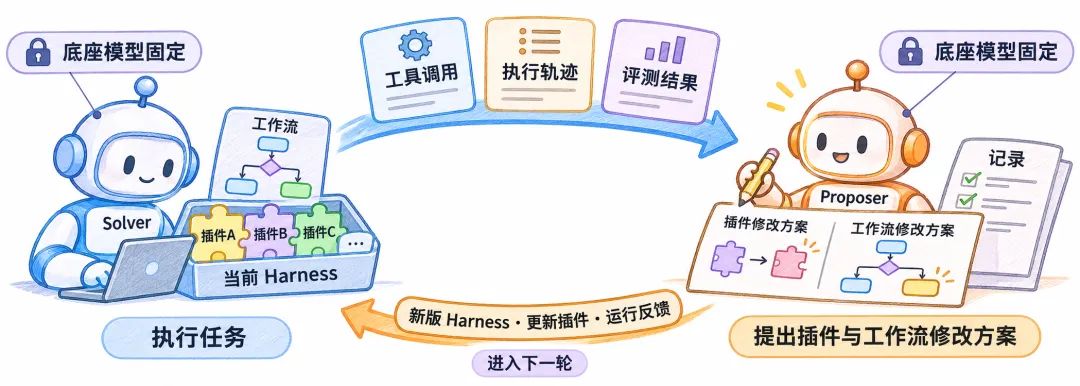
PluginRSI 里有两个分工不同的 Agent。Solver 使用当前 Harness 做任务,留下工具调用、执行轨迹和评测结果。Proposer 阅读这些材料,提出插件和工作流的修改方案。搜索过程中,两个底座模型都保持固定。上一轮产出的 Harness、插件和运行反馈会进入下一轮,递归发生在这个优化闭环里。
每一个插件是一个独立、有标准接口的小模块,分为四大类:
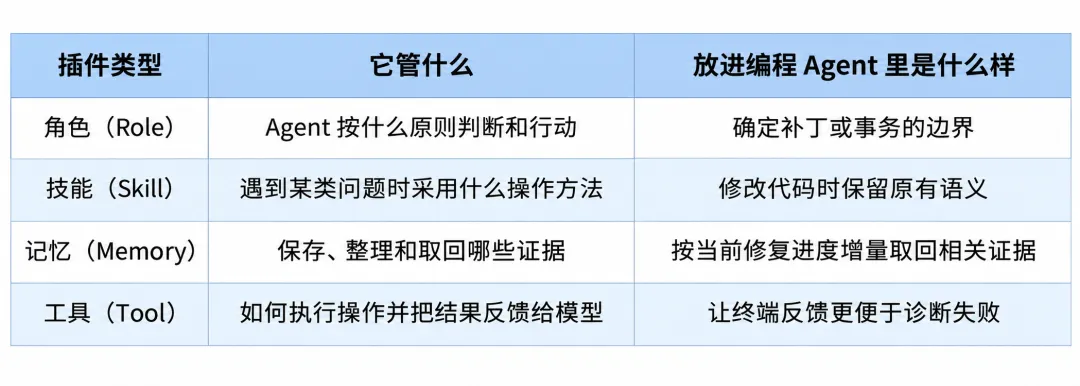
每个插件包含两部分:一份YAML配置(输入输出格式、参数)+一份Python实现代码,接口标准化。
而完整的Harness = 一批挑选出来的插件 + 一套Workflow工作流脚本。
Workflow不写复杂业务逻辑,只负责调度:什么时候调用哪个插件,插件输出如何流转,控制整个任务循环。业务能力全部下沉到插件当中。
整个优化循环分为两大阶段:插件变异(Plugin Mutation) + Harness重组(Harness Recomposition),再配合一个不断扩容的共享插件库。
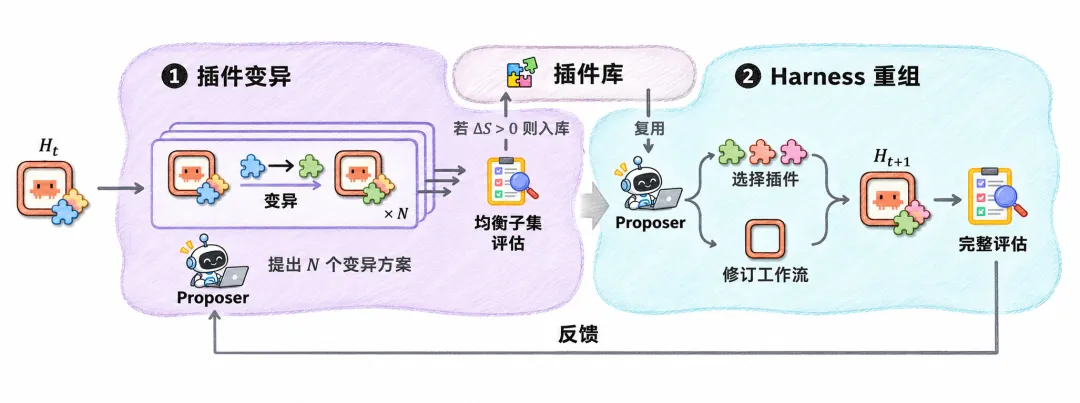
这套设计把两个容易混在一起的问题分开了。一个机制本身能否改好,可以通过替换插件来试。几个机制怎样配合,交给工作流来试。
每一轮迭代,系统并行生成多组实验:
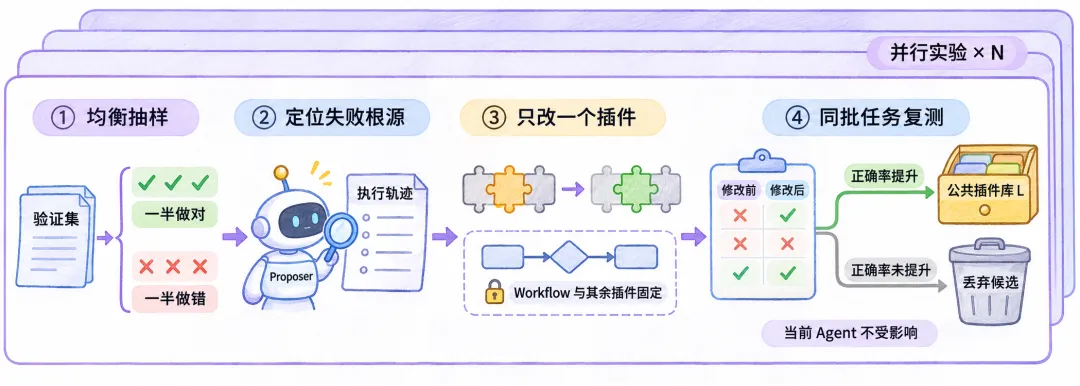
- 从验证集挑选一批均衡小批量任务,里面混合一半做对、一半做错的案例;
- Proposer智能体看这套任务的执行轨迹,定位失败根源;
- 只选中其中某一个插件做修改,Workflow、其余所有插件原封不动。只改这一个零件,其余环境完全不变;
- 在小批量任务上测试修改后的插件。如果改完之后任务正确率提升,这个新版本插件就存入公共插件库L;没有提升就直接丢弃,不影响当前Agent。
变量只有一个可以让性能变化明确归因到这个插件改动,不会混杂其他干扰。优秀的改进版本永久入库,不会被后续改写删掉。
举论文中真实发现的插件改进例子:
原始记忆插件简单根据关键词匹配召回历史记录,经常返回大量重复信息。变异后的插件增加去重逻辑,优先返回从未展示给大模型的新证据,大幅减少冗余信息干扰。这个改进版本直接入库,可以给之后所有Agent调用。
同样,终端工具插件进化出失败感知反馈,不仅返回命令输出,还自动识别隐藏在成功返回码下的测试报错,给Agent补充失败提示。角色插件进化出修复范围控制,约束AI不要胡乱大范围修改代码。这些全部作为独立零件保存。
插件库已经积累一堆经过验证的插件,现在来组装新一代Agent外壳:
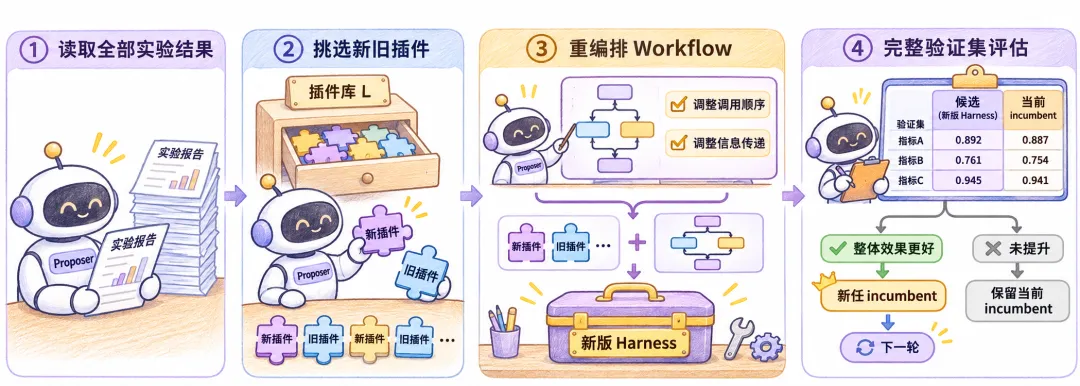
- Proposer智能体读取本轮插件变异的全部实验结果;
- 从插件库挑选一批有价值的新旧插件;
- 修改Workflow调度逻辑:调整插件调用顺序、信息传递方式,重新编排协作流程;
- 拼装成完整的Harness,在完整验证集评估整体性能。如果整体效果更好,就作为新一代 incumbent(当前最优Agent)进入下一轮循环。
简单说:阶段一专注打磨一个个零件,阶段二负责挑选零件,设计零件之间如何配合,组装出新整机。两者缺一不可。消融实验证明,去掉任意一个阶段,性能都会明显下滑。仅仅拥有插件库,但没有变异+重组流程,不会带来明显收益。
论文在三大类任务开展测试:软件工程(SWE-bench Verified真实GitHubbug修复)、命令行操作(Terminal-Bench-2.1)、多领域问答(数学、法律、医学、金融等),对比ReAct、ACE、GEPA、DGM、Meta-Harness等主流基线方案。
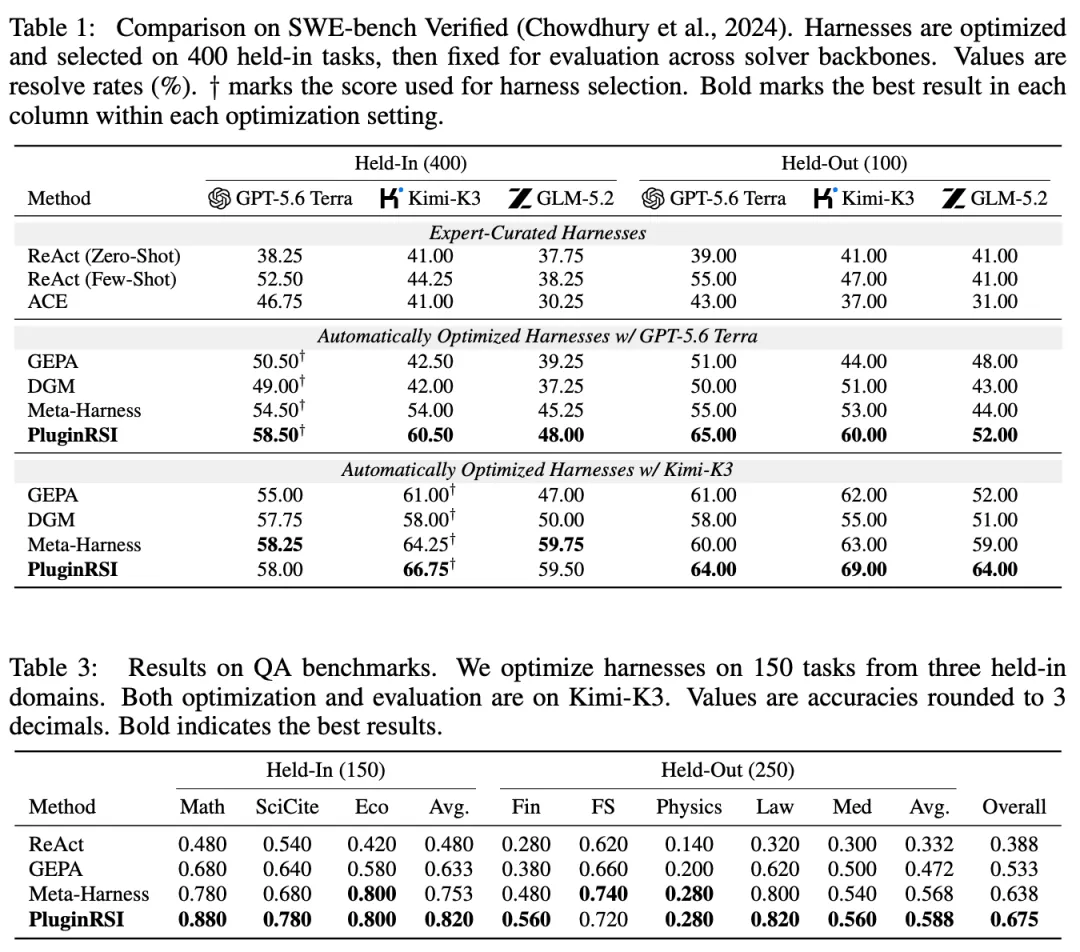
在两种不同提案大模型(GPT-5.6 Terra、Kimi-K3)条件下,PluginRSI都显著超过Meta-Harness。
- 使用Kimi-K3做优化,未见的测试集(held-out)解决率达到69%,对比Meta-Harness 63%,高出6个百分点;
- 使用GPT-5.6 Terra优化,未见测试集达到65%,高出基线10个百分点。
非常关键的一点:进化得到的Harness具备跨模型迁移能力。
用Kimi-K3迭代出来的Agent外壳,直接套给GPT、GLM模型,不需要再做任何优化,依然维持明显性能优势。现实场景中,我们经常需要把一套Agent方案迁移到不同底座模型,这一特性有很高实用价值。
在数学、法律、医学、金融、科学多领域问答数据集上,在见过的训练域提升巨大;跨完全陌生领域收益会变小。作者也指出,不同学科需要完全不同的策略,插件的跨领域复用本身存在天然天花板。
对比Meta-Harness,PluginRSI可以用更少的累计模型调用次数,得到更高性能的Agent。并且验证集上的提升,能够同步反映在未见测试集上,过拟合风险更低。Meta-Harness经常出现在训练任务上越来越好,但陌生任务性能波动、提升有限。
经过多轮迭代,插件库从初始75个增长到132个插件。有趣的统计现象:插件数量暴涨,但Workflow调度代码依旧很短(不到300行)。大部分复杂度沉淀到各个插件零件中,Workflow保持简洁可控。
如果从头启动一个全新Agent,直接加载已经进化完毕的插件库,仅仅两轮迭代,未见任务解决率就能冲到69%;而从零开始进化,同样步数只有65%。也就是说,沉淀下来的插件工具箱,可以加速未来其他Agent的迭代进化,实现进化经验的传递。
这项工作也客观指出现存的短板:
- 当前实验在固定任务集迭代,现实世界任务分布持续变化。随着迭代进行插件库会越来越庞大,如何管理、裁剪海量插件是待解决问题。
- 跨差异巨大的领域时,插件迁移增益有限,未来需要做多领域联合优化。
- 插件变异的逻辑假设是改动一个插件,其余组件不变。但有些能力提升需要同时修改多个插件+Workflow协同改动,当前单插件修改流程很难发现这类机制。
- 插件变异阶段会带来一定token开销,相比Meta-Harness,输入token增加7.5%,输出token增加约19.8%,成本有所上升。
过去Agent自进化,是整机迭代,每次修改整个Agent外壳,容易丢失宝贵局部经验。
PluginRSI提出零件化迭代范式:
- 把Agent外壳拆解成标准化插件零件;
- 通过插件变异独立打磨单个零件,有效方案存入共享工具箱;
- 通过Harness重组,挑选零件、编排调度流程,组装新一代智能体;
- 整个进化过程形成一个持续生长的工具库,不仅提升当前Agent,还加速未来其他Agent的优化。
它给出一条现实可行的递归自我改进路径:不需要改动大模型权重,聚焦改进包裹模型的运行外壳,把进化的成果沉淀为可复用组件。
论文地址:https://arxiv.org/pdf/2609.32423