ARTICLE · 1310022
我在 PDF 里划掉的废话,WorkBuddy 全都给我用上了
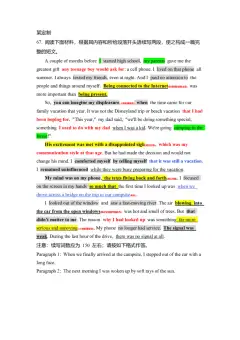
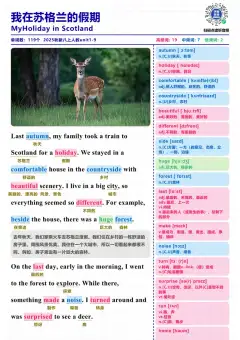
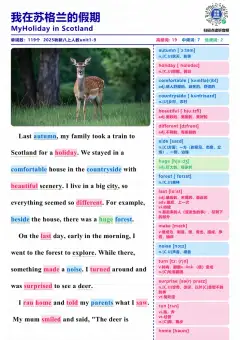
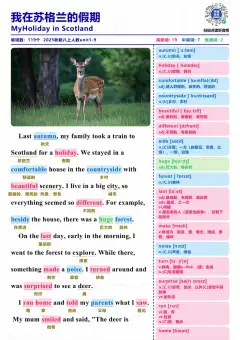
最近我在做四六级翻译真题的教研。我完成其中一篇的初稿后,让 AI 帮我修改,让它用删除线划掉了一些多余的内容,用加粗的括号补上了新思路,标明哪些内容作废、哪些采用。
改完之后,我把带标注的稿子导成 PDF,发给了 WorkBuddy,想让它帮我排成一张解析卡。我的想法很简单:划掉的部分它应该会自动跳过,只用我新写的内容。
结果它生成的东西让我哭笑不得。被划掉的旧句子和我新写的要点混在了一起,两种完全相反的说法出现在同一张卡上,前言不搭后语,只能推倒重做。
一开始我以为是 AI 太笨,连这么明显的删除线都认不出来。后来我去查了资料,又请教了懂技术的朋友,才明白问题出在哪里。
AI 读 PDF 的方式,和我们不一样
我们看 PDF,看到的是一页一页排好版的内容。但 AI 拿到 PDF 之后,做的是从文件里把文字一段一段提取出来。
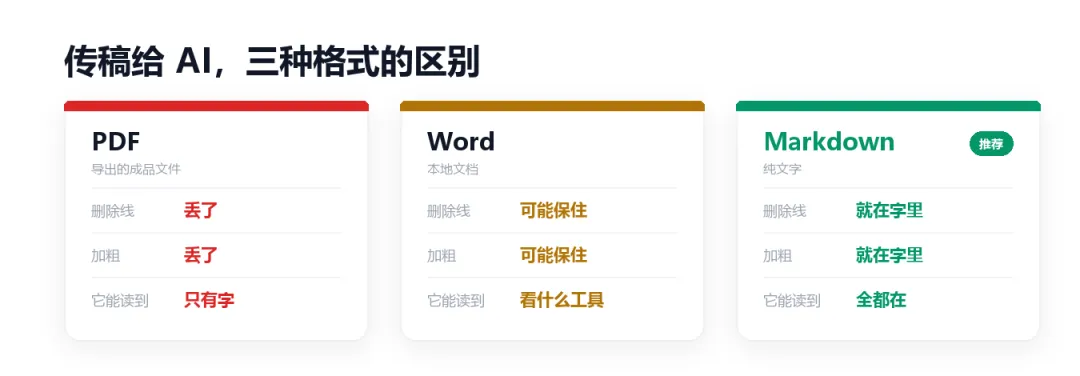
关键在于,PDF 里的这些标注并不属于文字本身。在 PDF 的文件格式里,文字是文字,删除线只是单独画上去的一条线,加粗、字号这些样式也是一样,提取出来的只是字,样式留不下来。AI 提取内容的时候,只认字,不会去看这条线。
所以,我划掉的那段话,和我在括号里新写的话,在 AI 眼里是一样的,都是正常的文字。它把两段都拿去用了,结果自然就乱了。
想通这一点之后,我反倒释然了。不是 AI 不听话,是我们对它的期待,超出了它实际的工作方式。它从来没有“看见”过那条线,是我们以为它看见了。
后来我改了做法
先说结论:AI 和 AI 之间传稿子,最省事也最稳的方式,是直接发 Markdown 纯文本。
Markdown 听起来专业,其实就是带几个符号的普通文字:两个波浪线夹住一段话,就是删除线;两个星号夹住一段话,就是加粗。关键在于,这些符号是文字本身的一部分,AI 一读就懂,不存在丢失的问题。我现在的流程很简单:在上一个 AI 里把稿子改好,直接复制文字发给 WorkBuddy,哪些划掉了、哪些保留,都清清楚楚。
如果一定要传文件,优先传 Word,别传 PDF。区别还是在这些标注上:Word 里的删除线、加粗,是文字自带的格式属性,转换的时候有机会被翻译成 AI 认识的符号;而 PDF 里,删除线只是画上去的一条线,加粗是字体样式,和文字本身是分开的,提取文字的时候都会丢。另外 PDF 还分两种,一种是文字版,一种是扫描出来的图片版,图片版要先做文字识别才能读,可靠性又要打一层折扣。
最后一个小技巧:如果稿子里确实带着批注,不用做任何额外标注,在最前面加一句话就够了,比如“带删除线的内容是废弃的,只用加粗的部分”。一句话的事,能省不少返工。
一点感想
用 AI 用了这么久,我越来越觉得,它像一个做事很快、但完全不懂变通的助理。你把东西随手一丢,它不会替你分辨重点,还是需要自己多加甄别才行。
我会继续分享英语老师使用 AI 的真实体验。 如果你也关注 AI 在教学中的应用,欢迎点赞、关注、收藏,也点个“在看”,让更多正在用 AI 备课的老师看到。 |