ARTICLE · 1311606
面了一个软件测试女生,她对AI测试理解简直惊艳到我…
面了快二十个AI测试候选人,我的耳朵已经听出茧子了。
大家的回答高度同质化:知道怎么测幻觉、会跑模型评测、懂Prompt优化。这些都没错,挑不出大毛病,但听完就像喝白开水——不烫嘴,也不解渴。
AI测试怎么做?
要测幻觉、要做评测集、要调Prompt。
具体怎么测?
用LLM当裁判、跑准确率、看召回率。
直到今天遇到一个女生。聊了三个层次,我全程没打断,连水都没顾上喝。
这哪是面试,这是给我上了一课。
第一层:AI测试的本质不是找Bug,而是管概率
我问她怎么理解AI测试。
大多数人的回答:
“核对回答对错,排查模型乱编。”
这是把AI当成一个会犯错的搜索引擎。输入进去,输出出来,对一对,不对就是Bug。
她的回答:
“AI测试的核心,是承认模型的概率性,用体系化手段管住不确定性。传统测试靠固定输入输出判结果,AI测试靠场景分层、基线对比、风险边界管控,这套体系决定了模型质量的上限。”
她举了个例子:普通测试只会逐句核对回答。专业的做法会先判断场景——是问答推理、内容生成还是工具调用?是否需要严格事实性?信息缺失不盲目判错,主动界定边界。同时考虑输出稳定性、上下文连贯性、对抗鲁棒性,这些不是细心就能解决的,是测试架构要兜住的。
我听完的第一反应是:她把“测试”这个词,从“验证”升级成了“治理”。
常见误区
误区
AI测试也能像传统测试一样用固定断言判对错
事实
大模型同一问题问十次会给十个不同回答,只能判断这一次输出是否在可接受范围内
传统测试的底层假设是确定性的,同样的输入永远产生同样的输出,所以可以写 assertEquals(expected, actual);但大模型面前,这个假设根本不存在。
**找Bug**
点对点的活。
**管概率**
体系化的活。
这俩差了一个认知维度。
第二层:容错不等于放任,关键是定义“致命劣化”
我接着问:模型输出波动怎么处理?
常见答案:
“多测几遍,优化优化Prompt。”
这是把“不稳定”当成了“模型还没调好”。多跑几次,多改改提示词,总能稳定下来。
她的回答:
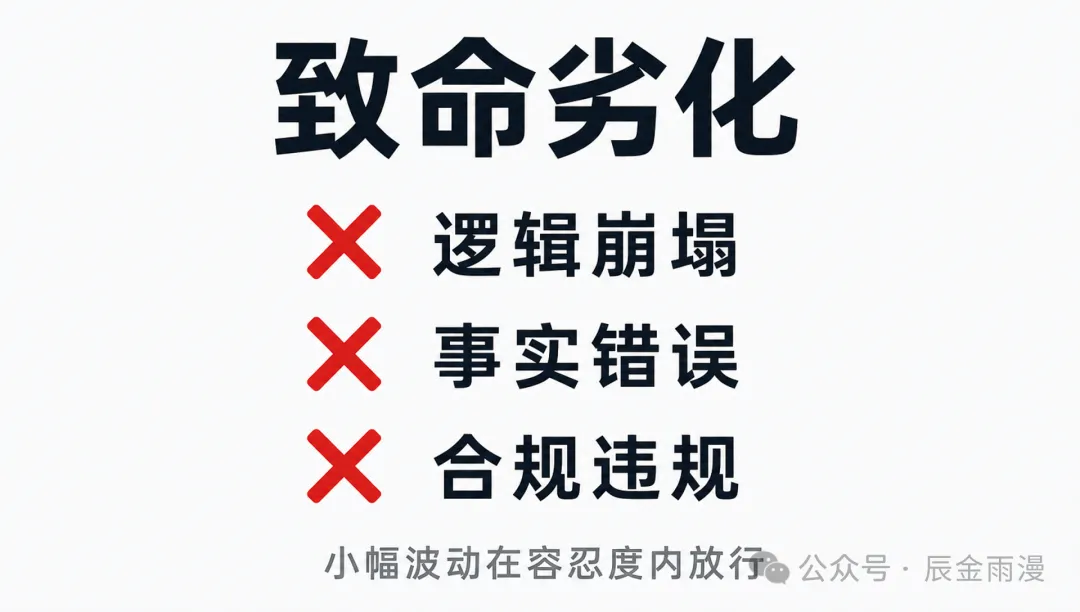
“AI和传统软件最大的区别就是不确定性。我的原则是:不拿传统用例卡死概率性输出。小幅波动属于正常现象,重点拦截致命劣化:逻辑崩塌、事实错误、合规违规。稳定复现的问题算Bug,偶发差异标记风险。上线前就要定义好评测基线、波动容忍范围。拿不准的结果,直接告知风险,绝不强行凑标准答案。”
这段话我听得很舒服。因为她把“容错”和“摆烂”分得清清楚楚。
什么叫摆烂?“模型偶尔答错很正常,不用管。”这叫不负责任。
什么叫容错?“小幅波动在容忍度内,放行;逻辑崩塌、事实错误、合规违规,一票否决。”这叫定义了什么是“不能接受”。
容错的前提,是你先定义了什么叫“致命”。
没有红线的容错,叫放任。
她最后那句我印象最深:“拿不准的结果直接报风险,绝不强行凑标准答案。”
很多测试人面对不确定的输出,会硬凑一个“通过”或“不通过”,因为交付报告需要结论。但在AI测试里,“不确定”本身就是一个合法的、有价值的结论。报“待人工确认”,比硬给一个假结论负责得多。
第三层:最难的不是测得准,而是测得有边界
最后我问她:做好AI测试最难的是什么?
大多数人的回答:
“怕模型出问题,怕自己背锅。”
这是把“难”理解成了“压力”。
她的回答:
“最难的是设计有边界的不确定性验证。很多人怕模型出问题,就把所有输出标准写死,最后做出来的只是机械人工核对。真正的AI测试,是提前定义场景池、约束条件、评测维度和安全护栏。不控制模型每一次输出细节,但能保证整体质量稳定、风险可控、迭代可追溯。”
这段话是整场面试里最让我意外的一句。
因为大部分人做AI测试,做的其实是“人工核对”——模型输出一段,人读一遍,判断对不对。这不叫AI测试,这叫用人工给AI擦屁股。
她说的是:你不控制每一次输出,你控制的是“场景池、约束条件、评测维度、安全护栏”。
翻译一下:你不要求模型每次都说对话,你要求的是——在所有该覆盖的场景里,整体表现可接受;在所有不能碰的红线前,模型不能越界。
你管的是“边界”,不是“每一次输出”。这才叫体系。
聊完我最大的感受
低端玩家还在死磕“怎么找出AI的Bug”,顶级高手已经在思考“怎么搭建一套能稳住模型、可长期迭代的AI质量体系”。
这三层,一层比一层深:
第一层,她把测试对象从“输出”升级成了“概率”。 第二层,她把判断标准从“对错”升级成了“致命劣化红线”。 第三层,她把工作目标从“测得准”升级成了“有边界的不确定性验证”。
看懂了吗?这就是普通测试和顶级大牛的认知鸿沟。
怎么找出这一个Bug
怎么建一套体系,让Bug在体系里无处可藏
一点真心话
在AI时代,你会点工具,真的不值钱。
会调API、会写Prompt、会跑评测集——这些是入场券,不是护城河。
真正拉开差距的,是你有没有跳出“非黑即白”的思维,用体系去兜底不确定性。
AI测试的本质,不是判断“这一次对不对”,是设计一套体系,让“整体的对”可度量、可追溯、可迭代。
别光背八股了。下次面试前,先问问自己:你测AI的时候,是在“逐句核对”,还是在“搭体系”?