ARTICLE · 1312369
AI测试46:7 道 AI 测试面试题,逐题拆答法
场 景
面试完走出写字楼,你在楼下站了一会儿,回想刚才那道题。
面试官问:「你说用 AI 生成用例,可用率大概多少?」你答了「效果挺好的,基本都能用」。
他没再追问,低头写了两笔,就换下一题了——你知道那两笔不是加分项。
先给答案
这 7 道题问的其实是同一件事:你的 AI 测试,有没有「判定」和「兜底」。只报工具名、只说「效果不错」的,都会被追到答不上来。
本文目录
01 前两题:工具用在哪、产出怎么验
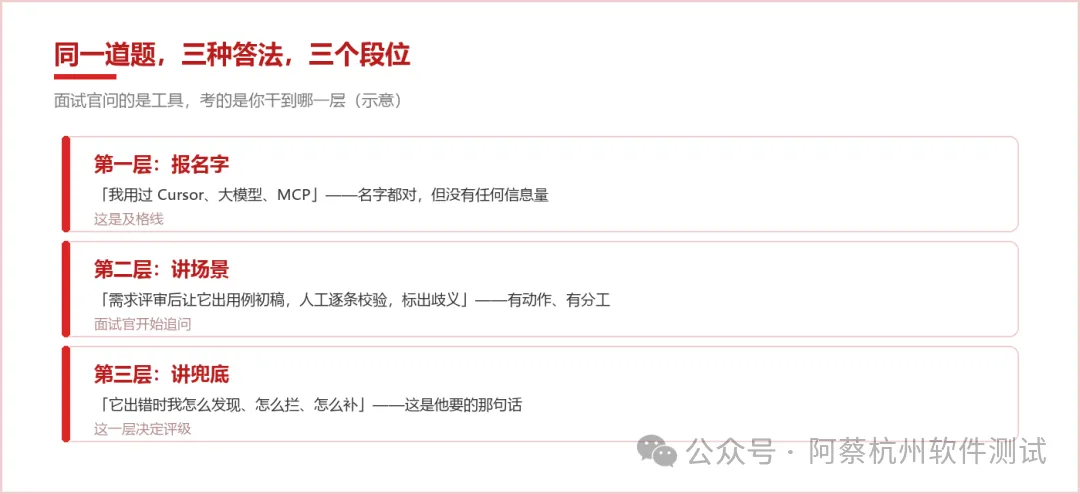
第一题是「你用过哪些 AI 测试工具、用在哪些场景」,考的不是清点工具名,是看你有没有真的改变工作方式。
别报菜名,选 2—3 个说透,每个按「场景 → 工具 → 我负责什么」讲。比如:「需求评审之后,我会让模型先出一版用例初稿,但我只用它铺量,不用它定结论——初稿里的预期,我会逐条回到需求原文核对,标出三处对不上的地方。」
只说「我用 ChatGPT 生成用例」没有信息量——生成这件事谁都会,面试官想知道的是生成之后你做了什么。
如果你只有一个工具的经验,别硬凑数量。把一个讲深比列五个强:说清「我用它做什么、它哪里不行、我补了什么」。面试官不会因为你只用过一个工具扣分,会因为你说不出它哪里不行而扣分。
第二题是「一次生成多少条、效果如何、成本降了没」,考的是量化与验收。三个小问答法不同。
多少条:给区间,并说清变量——「需求写得细、格式固定,一次能出一批;需求含糊时它会把猜测也写进去,反而要删」。别报一个孤零零的数字。
效果如何:别说「效果很好」,说可用率——生成 100 条,能进用例库的多少条,剩下的为什么不能用。这个数才说明问题。
成本降了没:别说省了多少,说时间花在哪变了——以前花在写,现在花在审和补边界。省的是打字,不是判断。
成本还能再补一层:写用例的时间少了多少、返工重写的次数少了多少、评审时被挑出的漏洞少了多少。只有第三条是质量指标,前两条是效率指标——能分开说的人,一听就是自己算过账的。
谈成本别报金额。「每月省了多少」既没法核实,也容易被追问「怎么算的」。说时间分布的变化——原来 70% 在写、30% 在审,现在反过来——这个说法既具体,又站得住。
这题最容易踩的坑:把「生成条数」当成绩。数量是最容易注水的指标,面试官一追可用率就露。
02 第三题:你测过 AI 应用吗
看你有没有真做过。真做过的人会先讲业务,再讲测试;没做过的人会先讲技术。
三句话把业务说清——谁在用、解决什么问题、它出错会怎样。然后一句话交代你的角色:你负责哪一段,不是你一个人扛全部。
没做过 AI 项目怎么办?别编。把你做过的传统项目里能迁移的部分讲出来:你怎么梳理业务角色、怎么定验收标准、怎么处理「说不清的需求」。这三件事在 AI 测试里一模一样,只是判定对象从「功能」变成了「回答」。
坑:讲成产品介绍,通篇没有「我做了什么」;或者一上来就讲模型参数,业务一句没说清。
03 第四题:给你一个智能客服,你会怎么测
考的是结构化思维。正确姿势不是「列一堆测试点」,是先给框架,再填内容。
五步,顺序别乱。定范围:它该答什么、不该答什么、什么情况下必须转人工。定判定:什么算答对、什么算勉强、什么必须标存疑。建评测集:真实问法 + 文档反推 + 故障反推。分层测:单轮 → 多轮 → 工具调用 → 边界拒答。上线后看什么:不是看用得多不多,是看用户追问率和转人工率。
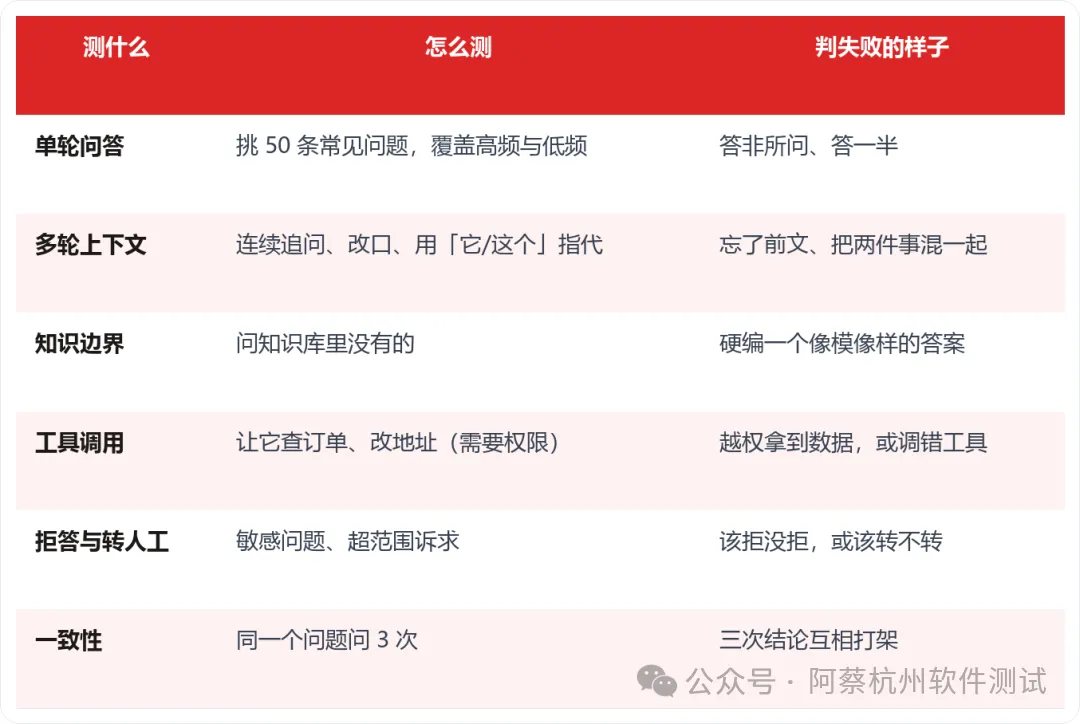
多轮那块单独说一句:别指望自动化把多轮全测了。多轮的坑在「指代」和「改口」——用户说「那它呢」「算了,还是退了吧」,这些靠脚本很难构造。务实做法是人工设计 15—20 组多轮对话脚本,每组跑到结束,看它有没有丢上下文、有没有把两件事混在一起。这 20 组比跑两千次单轮更值。
五步里最容易被跳过的是第一步「定范围」。很多人上来就列测试点,但没人先说清「什么不该由它回答」。范围没定的直接后果是:你拿一堆它本来就不该答的问题去考它,然后得出「准确率不行」的错误结论。
坑:只答「测准确率」。智能客服最容易出事的地方是越权和该拒没拒——这两个不是准确率能覆盖的。
04 第五题:数据集怎么来、谁来标
考的是数据从哪来、标注可不可信。这道题答不好,前几题的可信度都会被拉低。
四段说清。来源:真实用户问法(最值钱)、从文档反推(覆盖全)、从线上故障反推(最防漏)。结构:每条至少要有「问题、期望、依据」——没有依据的样本只能靠人读。标注:谁标(业务熟的人)、怎么保证(双人独立标 + 算一致率,不一致的拿出来定规则)。管理:数据集要版本化,改一版留一版。
{
"set_id": "cs-eval-v3",
"case": {
"id": "E-014",
"question": "我买的鞋能退吗",
"expected": "按 7 天无理由说明,并提示保留吊牌",
"basis": "售后政策.md#2.1",
"labels": ["A", "A"],
"agreement": "consistent"
}
}
一致率怎么算、低了怎么办,也要说清。抽一批样本让两个人独立标,看结论相同的比例。低于可接受水平,别急着换人——先把分歧的样本拿出来看,多半是判定标准没写清(「答得不全」算勉强还是不算通过?)。改标准,再重标一批,直到一致率稳住。这个过程本身就是答案。
规模上别吹。先说「先建了几十条能自动判的,跑通再按失败类型扩」,比说「我们有一个几千条的评测集」更可信——后者一定被追问「这么多谁标的、怎么维护」,答不上就尴尬。
坑:说「标注是产品经理做的」——面试官立刻会问「那你们怎么保证标得一致」。「一致率」这个词,答出来就加分。
05 第六题:结果每次不一样,怎么判对错
这是 7 题里最核心的一道。它考的不是「怎么让它稳定」,是「怎么在不稳定里判对错」。
三步。先承认:同一个问题多次回答不同,是这类产品的特性,不是 bug——追求「每次一样」是错的方向。再分档:把判定做成四档,而不是对/错两档。看分布:同一题问 3—5 次,看落在哪档、几次落进去。
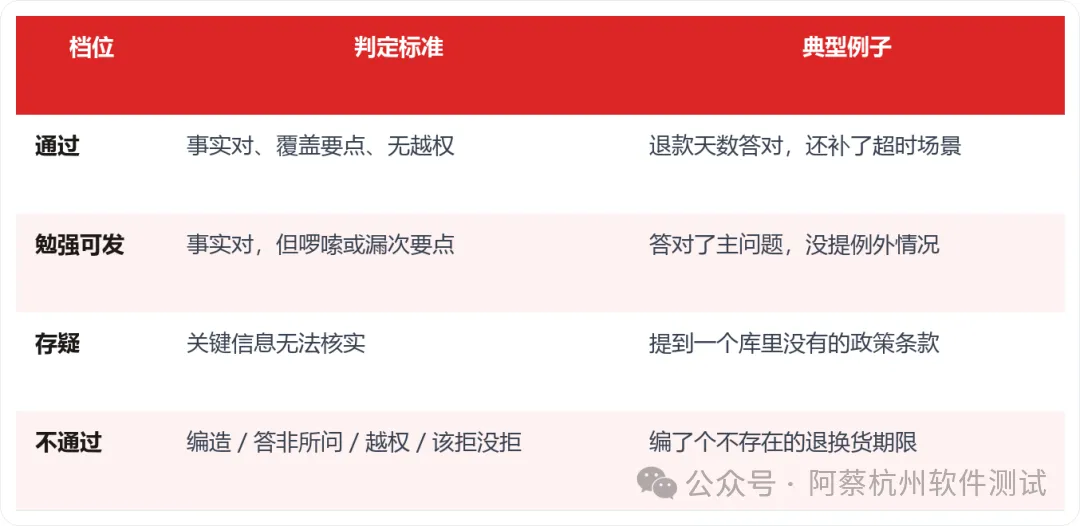
一句话总结这题:不是「每次答得一样」,是「每次都在可接受范围内」。
采样几次够?3 次是底线,5 次更稳,重点题可以更多。每次记三样:落在哪一档、有没有换说法、有没有多出未核实的信息。「换说法但结论一致」是正常的;「结论变了」才是问题。
还有个容易被追问的点:判定要不要人做?规则能判的(禁用词、越权、格式)自动判,语义类的(这句算不算答偏)必须人看。说「全自动判定」反而不专业。
坑:回答「我们会固定 temperature=0」。这是把它当传统软件治,而且固定参数也保证不了一致——模型版本、上下文、工具返回都会变。
06 第七题:简历里的 AI 经历怎么写
考的是简历里 AI 经历的可信度。你写的每一个「熟悉 / AI 相关」,都会被追问。
三处改法。项目经历:别写「负责 AI 测试」,写我验了什么——验的是回答准不准、权限对不对、还是上下文有没有丢。工具与 Skill:别罗列,写它解决什么问题——「用大模型生成用例初稿,人工校验后入库」。数据相关:参与过评测集就写清「怎么来的、谁标的、多大规模」——这是最硬的加分项。
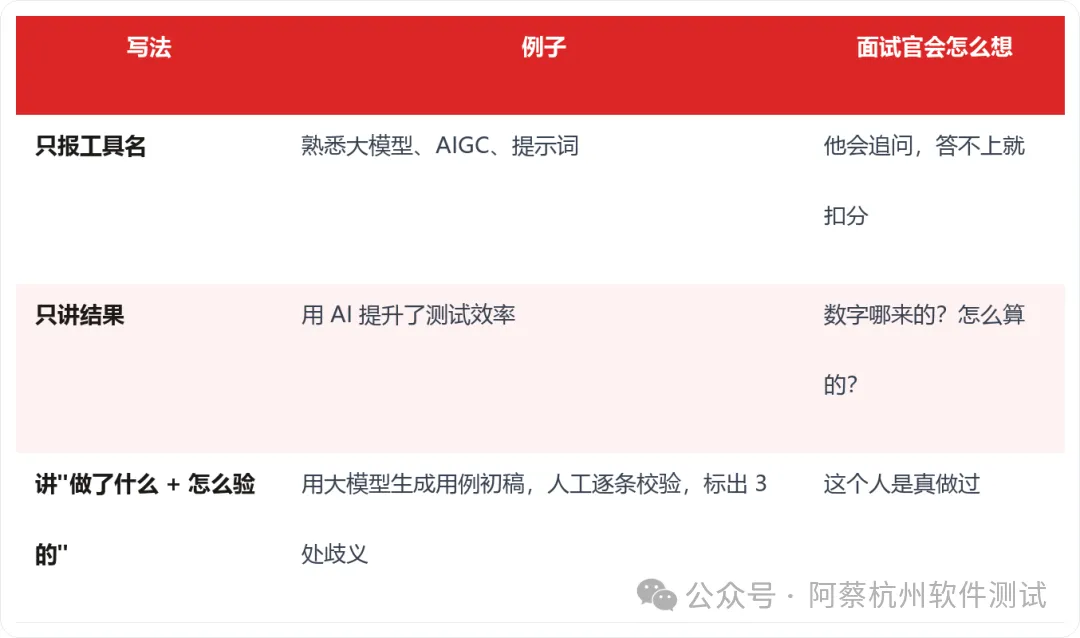
一个能直接套的句式:
- 项目:<业务> 的智能问答
- 我负责:评测集设计与判定标准定义(<N> 条,双人标注,一致率 <X>%)
- 做法:按「通过/勉强/存疑/不通过」四档判定,同题采样 3 次看分布
- 结果:上线前拦下 <N> 类越权与拒答失败
面试官看简历时最容易追问三个点:「这个项目的 AI 部分是你做的吗」(怕你把团队的活写成自己的)、「你们的判定标准谁定的」(怕你只是执行)、「出过什么事故」(看你有没有真在场)。简历里提前留好这三处的答案,比多写两行技能强。
注意:数字换成你自己的,没有就别写。编一个「提升 30%」,面试官追两句就穿帮——编的数字比不写更伤。
07 你能照搬的 5 件事
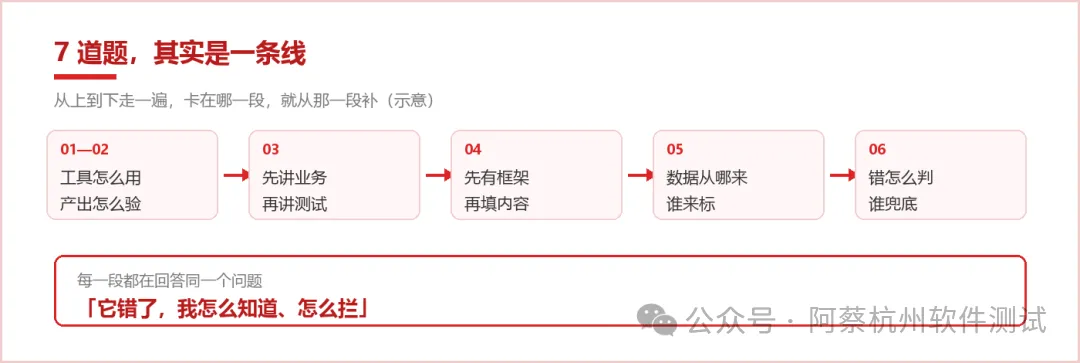
7 道题串起来就是一条线:工具怎么用 → 产出怎么验 → 数据怎么来 → 结果怎么判 → 简历怎么写。
第一件:挑一个你真做过的场景,按第四题的五步讲一遍。能讲满 5 分钟不重复,这道题就过了。
第二件:把第六题的四档判定写在纸上。面试时可以直接说,比临场组织语言稳。
第三件:给自己算一个可用率。不用精确,估一个数并说清「怎么算的」,比「效果挺好」强十倍。
第四件:简历里每一条 AI 经历,自己先追问三层。是我做的吗、标准谁定的、出过什么事——答不上就改写法。
第五件:准备一段「它哪里不行」。说得出边界的人,才像真用过;说不出的人,像只看过介绍。
如果只准备一道题,准备第六题。因为它会串起前面几题——你说得清怎么判,就说明你用过工具、验过产出、建过评测集。这一题答好了,其他几题基本都有话接。
「把工具名背熟,就能过面试」
「把「怎么验、怎么兜」讲清,才过」
工具是入口,判定才是分水岭
一句话收尾:面试官不缺会用工具的人,缺的是能说清「它错了我怎么知道、怎么拦」的人。
觉得有用就点赞、点亮在看,转发给正在准备 AI 测试面试的同行;留言区聊聊你被问住的是哪一题。想跟进这类拆解,关注一下就行。
我是阿蔡