ARTICLE · 1313492
AI 圈最卷的一对:都是 8 块 5,选 DeepSeek 还是 GPT-5.6 Luna?
AI 圈最卷的一对:都是 8 块 5,选 DeepSeek 还是 GPT-5.6 Luna?
输出价一分不差的两款模型,输入价、缓存价和账单结构完全不同,能力还差着 12 分。我把三笔账算给你看,最后给出我的选择,以及什么情况下我会反悔。
第三方 API 聚合平台 OpenRouter 公布了 10 月统计:调用量榜首是 DeepSeek V4.1 Flash。
前 22 天,它跑了 102.2 万亿 token。
这个数字把所有闭源旗舰甩在了身后。
它最直接的对手,是 OpenAI 的 GPT-5.6 Luna。把两家的官方价目表并排放,能看到一个少见的巧合。
输出价一分不差,都是 1.20 美元每百万 token,按汇率折合 8 块 5。
同样 8 块 5,买到的不是一个东西。这篇把价格、账单、能力三层拆开算,最后给出我的选择。
01 先说我的选择
只让我推荐一个默认选项,我选 GPT-5.6 Luna。
理由一句话:同样的输出价,它更聪明,输入还便宜三分之一,而且不分时段、不用调参数,拿来就用。
但有两种活儿,我会换成 DeepSeek V4.1 Flash。
一是能挪到晚上和周末跑的批量任务,二是缓存命中率高的 Agent 工作流。这两种场景下,账单能便宜三到五成。
还有一种需求只有 DeepSeek 能满足:模型权重按 MIT 协议开放,552B 总参数随便下载自部署。Luna 是闭源的,这条路没得谈。
先别急着反驳,账在下面,一层层算。
02 价格:同价是巧合,差别藏在另外两行
单位统一用人民币,每百万 token,按 1 美元兑 7.1 元换算。两家官方定价页,2026-11-05 查询。
这张表里藏了三个信息。
输出价确实打平,这是巧合也是现状。但输入价 Luna 便宜三分之一:1.4 对 2.1。
缓存命中差 7 倍:0.04 对 0.14。按各自未命中价折算,DeepSeek 的缓存输入便宜了 98%,Luna 便宜 90%。
差 8 个百分点,在 Agent 场景会被放大很多倍。
峰谷定价是 DeepSeek 独有的变量:工作日 9 点到 12 点、下午 2 点到 6 点(北京时间)按高峰价,其余时间含周末全部半价。
Luna 全球统一价,没有时段。
按「3 份输入配 1 份输出」的常见比例算混合单价:白天 DeepSeek 约 5 毛 3,Luna 约 4 毛 5,Luna 便宜 15%。
晚上 DeepSeek 约 2 毛 6,反超,便宜 42%。
03 算三笔账:各有各的主场
单价不等于账单。我按官方价算了三种典型任务,单位是元,保留两位小数。
场景 A,日常问答:输入 10 万,输出 5 万,白天跑。
场景 B,代码 Agent 反复读同一个仓库:输入 200 万,其中 180 万命中缓存,输出 20 万。
场景 C,批量处理:输入 100 万,输出 100 万,挪到周末空闲时段跑。
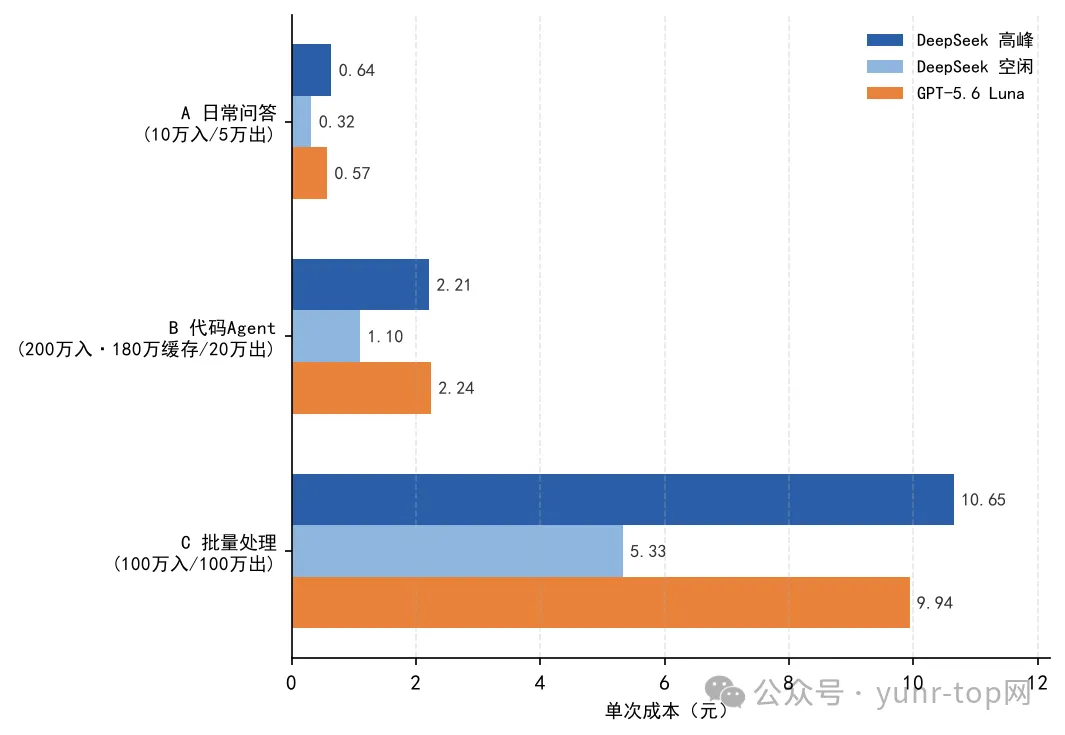
规律很清楚:轻输入重输出的任务,Luna 靠便宜的输入小胜,场景 A 里它便宜 11%。
缓存命中率越高、越能挪到空闲时段,DeepSeek 赢得越多。场景 B 高峰期两家打平,挪到空闲直接省一半。
你的活儿越像 B 和 C,越该认真看 DeepSeek;越像 A,越不用纠结,哪个顺手用哪个。
04 能力:价差没了,差距在别处
价格打平之后,能力就是剩下的全部变量。
Artificial Analysis 的智能指数(Max 思考档)里,Luna 约 51 到 52 分。
DeepSeek V4.1 Flash 约 39 到 40 分。这是第三方评测机构 Artificial Analysis 的口径。
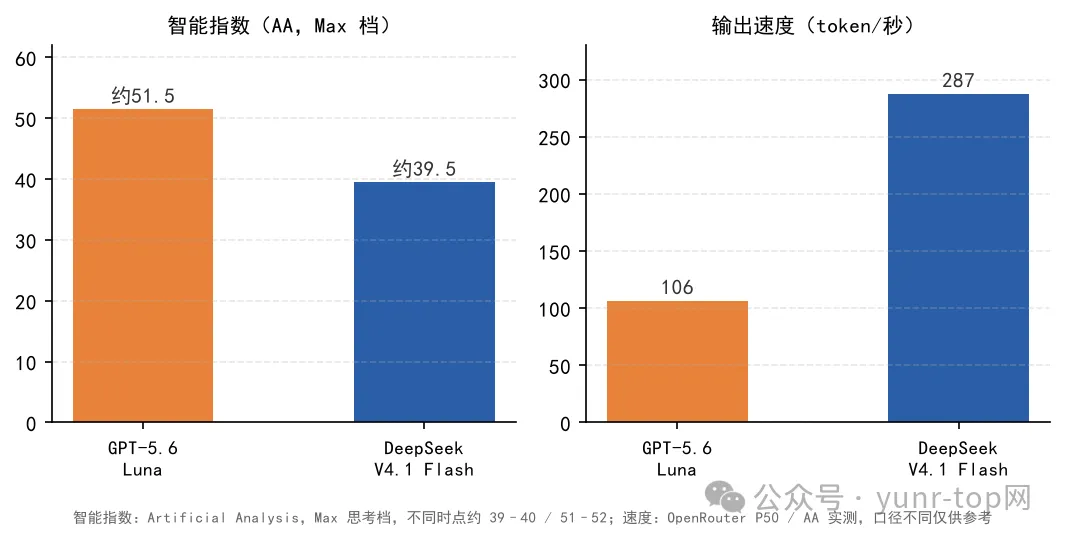
不同时点的榜单数字略有出入,但 12 分上下的差距是稳定的。这是同价之下最刺眼的一个数字。
编码方向要分开说。DeepSeek 官方自报的成绩不差:Terminal-Bench 2.1 拿 90.6 分,DeepSWE v1.1 解决率 74.2%。
但要注明,这是官方自测、Max 档、自家脚手架,换一套框架分数会缩水。
缩水后的成绩第三方也测了。Artificial Analysis 跑 Terminal-Bench 4.0,V4.1 Flash 只有 26.8%。
SuperCLUE 用 Claude Code 做统一框架的中文终端编程测评里,它拿 50.51 分,成本 1.86 元一题,时间效率是全场亮点。
Luna 没有官方自报的编码基准,第三方给它的编码 Agent 指数是 74.6,也是 Artificial Analysis 口径。
两边分数口径不同,不能直接横比,但方向一致:高难度任务 Luna 更稳,中文终端活儿 DeepSeek 能打。
速度是反过来的。OpenRouter 聚合多家供应商的实测里,V4.1 Flash 输出中位数 287 token 每秒,首字延迟 0.26 秒。
Luna 在 Artificial Analysis 的测试里输出约 106 token 每秒,思考档开到 Max 时,等第一个字要等几十秒。
两边统计口径不同,仅供参考,但 DeepSeek 快得多这个方向没有争议。
05 各自的坑
先看 DeepSeek V4.1 Flash。
高峰时段恰好是上班时间。9 到 12 点、14 到 18 点,打工人的任务高峰撞上它的高峰定价。想省钱,得把任务排进晚上和周末。
输出偏啰嗦。Artificial Analysis 的智能指数任务里,它每题花 0.27 美元,比上一代还高一点。
降下来的单价,一部分被更长的输出吃掉了。
长上下文检索不稳。字节跳动 Seed 团队的论文测出,分块缓存压缩会引入相位敏感性,长文档检索准确率在不同位置能差出 40 个百分点。
整本书当知识库丢进去之前,先小规模验证。
再看 GPT-5.6 Luna。
长上下文要加钱。请求超过 27.2 万 token 后,输入按 2 倍、输出按 1.5 倍计费。
加价后的输入价比 DeepSeek 还贵,长文档场景优势会翻转。
思考档是隐形成本。推理过程按输出 token 计费,档位开得越高,账单和首字延迟一起涨。
版本换代快。一年之内发了 GPT-5.4、5.5、5.6 三代,生产系统里写死模型名的,要留好迁移预案。
权重不开放。没法自部署,没法迁到别的云,数据合规有特殊要求的场景直接出局。
06 我的完整答案
分三层,对号入座。
默认选 Luna:日常问答、混合负载、不想管时段和档位、要接图像输入,闭眼用它,8 块 5 买 51 分的智能指数,值。
这两类活换 DeepSeek:一是缓存命中率高的 Agent 工作流,比如代码 Agent 反复读同一个仓库。
二是能排进晚上和周末的批量任务,半价不是折扣话术,是官方明牌。
只有 DeepSeek 能干的活:要自部署、要改权重、数据不能出内网。MIT 协议加 552B 权重全开放,这是 Luna 永远给不了的选项。
什么情况下我会反悔:如果 Luna 哪天把价格提回去,我立刻改推 DeepSeek。它 7 月底刚从输出 6 美元降到 1.2 美元,降得下去就涨得回来。
反过来,如果你的用量输出占大头、又全挤在白天跑,上面推荐 DeepSeek 的两条对你不成立,直接选 Luna 别犹豫。