ARTICLE · 1317191
视频配音做有声书,免费AI语音工具本地全搞定
这两年,"用 AI 说话"这件事彻底火了。
做短视频想配个旁白,自己声音不好听、又不想露脸;写了篇小说或文稿,想做成有声书解放眼睛;录课、做播客、给外语视频配上中文音轨;甚至想让一段文字,用某个特定的声音念出来。这些需求背后,都是同一件事——文字转语音、声音克隆、配音。
问题是,做得最好的那类在线服务,比如国外的 ElevenLabs ,效果惊艳,可门槛也明摆着:要订阅、按字符收费、得联网,而且你上传的文字和声音样本都要送到别人的服务器上。国内类似工具也大多按时长收费,用得多了是一笔持续开销,隐私上也总有点不放心。
今天聊的这个开源项目,等于把这套能力整个搬进了你自己的电脑:免费、能联网也能断网、声音和文稿都不出本机。它叫 VoiceStudio ,被很多人称作"本地版的 ElevenLabs"。
它 2026 年 4 月才在 GitHub 上线,半年多时间冲到 10 万多颗星、 1.1 万多个 fork,还登上了趋势榜,直到今天仍在每天更新,是今年语音类开源项目里现象级的存在。
先看几个核心数据
| 项目名 | |
| 怎么理解 | |
| Star 数 | |
| 核心能力 | |
| 支持语言 | |
| 怎么装 | |
| 花钱吗 | |
| 隐私 | |
| 硬件 |
一句话总结:它把过去要付费、要联网的专业配音能力,做成了一个本地、免费、人人能装的桌面软件。
它到底能帮你做哪几件事?
它不是一个只会"念字"的小工具,而是把语音相关的活整合成了几个工作区,像一个小型录音棚:
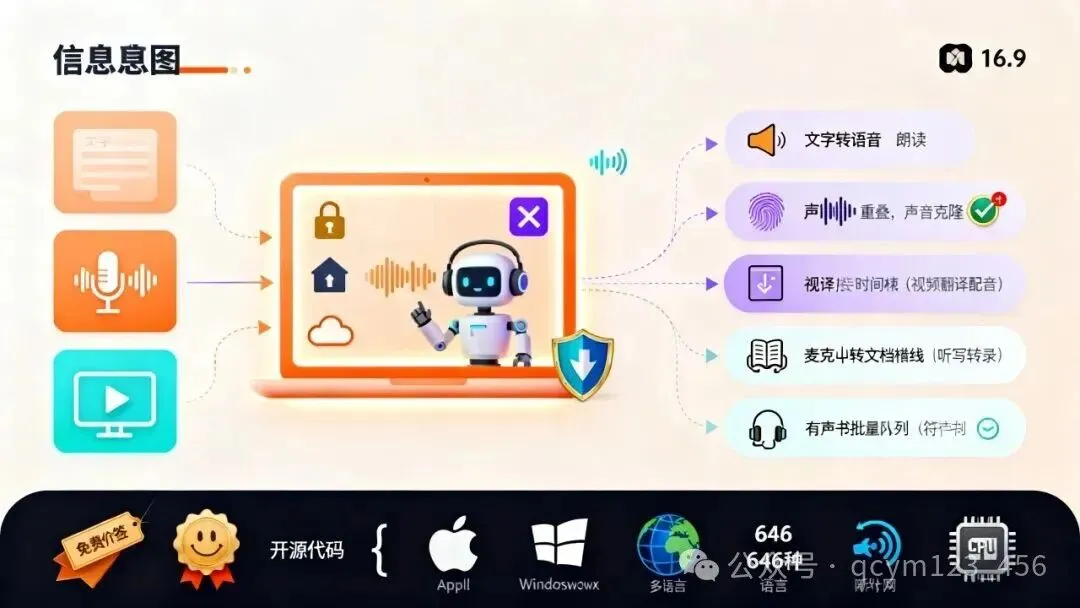
第一,文字转语音(最基础也最常用)。
把一段文字输进去,选一个声音,它就能生成自然的人声朗读。做视频旁白、给课件配音、把文章念出来听,都靠这个。它默认搭载 OmniVoice 引擎,还能在模型管理器里从数十种语音引擎里挑,只下载你需要的模型,不强制塞一堆用不上的东西。
第二,声音克隆。
提供一段清晰的参考录音,它就能学习这个声音的特点,之后你输入任何文字,都能用这个声音念出来。做角色配音、给自己的视频配固定音色,非常方便。这里必须强调一条红线:项目本身就明确规定,只能在获得声音本人许可的前提下克隆其声音。 拿来克隆自己的声音、或有授权的声音完全没问题,但偷偷克隆别人、名人的声音去骗人,既违规也可能违法。
第三,视频翻译配音。
这是很惊艳的一个功能:导入一段外语视频,它能把里面的话转成文字、翻译成你的语言,再用 AI 语音配回去,而且会自动让新配音和原片的时间轴对齐——不用你一帧帧手动对口型。看外网教程、搬运翻译视频时省了大力气。
第四,听写与转录。
它带一个悬浮听写窗口,你对着麦克风说话,它在本地实时转成文字,和语音合成正好是反向的能力;也能把现成的音频、视频文件转成文字稿。
第五,有声书与批量处理。
可以把长篇小说、故事、文稿批量转成有声朗读,还支持排队任务,一次性处理一大批,适合做有声书、给孩子做睡前故事音频、或者通勤时"听"资料。
普通人怎么装?难不难?
它专门做了普通用户也能上手的桌面版,不是程序员专属的命令行:
.exe、 Mac 是 .dmg(苹果芯片和 Intel 都有)、 Linux 有 .deb/.AppImage 等,安装包大约两三百兆;几句必须说清楚的大实话
一点个人感受
语音合成过去一直是"云端大厂的生意"——你得用人家的服务器、按字符付费、把数据交出去。 VoiceStudio 代表的方向让我很认同:把强大的 AI 能力压缩进一个普通人能双击安装的软件里,让它在你自己的电脑上安静地工作,不联网、不计数、不偷听。
它把声音克隆、配音、转录、有声书这些原本分散在多个付费产品里的功能,整合进一个免费开源的工作台,还认真做了简体中文和全平台支持。对做自媒体、搞创作、需要大量处理语音的人来说,这是今年最值得收藏的工具之一。
技术最好的样子,或许就是这样:强大,却不昂贵;好用,且尊重你的隐私。
温馨提示: 1. 本软件为开源项目( AGPL-3.0 ),桌面本地版免费,请仅通过 GitHub 官方 Releases 或官网( voicestudio.sh )下载,不要从陌生网盘、山寨站点获取,谨防被篡改; 2. 首次使用需下载语音模型,之后可离线运行;模型与数据保存在本机,但仍应从官方渠道安装以保证安全; 3. 声音克隆须获得声音本人授权,严禁未经许可克隆他人声音、伪造言论或用于任何违法违规用途,相关责任由使用者承担; 4. 个人使用免费;若计划将其集成进产品对外提供(商用),请先阅读 AGPL-3.0 协议条款;生成效果因模型和参考音频质量而异,重要内容请人工核对。
项目地址(复制到浏览器打开):https://github.com/debpalash/VoiceStudio