ARTICLE · 1325835
AI 这次不写代码,改起权重了:MIT 一年级博士把 AI 请进“权重维修间”
11 月 2 日,一篇来自 MIT CSAIL 的研究博客把一个颇有冲击力的实验摆到台前:研究团队让 GPT-6 Astra 不经梯度下降、不启动训练循环,直接分析并改写 Qwen3.5-0.8B 的部分权重。他们将这种做法称为 Weight-Space Programming,直译为“权重空间编程”。
WHAT HAPPENED
不是不训练就什么都没做,而是换了一个修改入口
通常训练神经网络,要先用数据计算损失,再借助反向传播得到梯度,优化器据此反复微调海量参数。权重空间编程绕开的正是这条标准路径:研究者用自然语言给出目标,让通用大模型读入已有网络的数值权重,推测网络正在实现或没有实现什么,再直接写出参数改动。
项目页把它定义为"通用 LLM 围绕自然语言规格直接读写网络权重",而不是经由优化器,尤其不是梯度下降。这里的“直接”不等于“没有任何计算”。在小型实验中,模型有时只看权重文本;在规模较大的围棋和 Qwen 实验中,它能使用受限 Python 沙箱分析张量,并以有限次数的前向传播观察行为。
这一区别很关键。传统微调是在数据与目标函数牵引下寻找更好参数;这里是大模型先形成关于网络内部结构的假设,再把假设翻译成一个定向补丁。它更接近“诊断—修改—复测”,而不是让模型凭空获得新知识。
因此,最值得评价的不是它有没有绕过梯度,而是它对故障位置、改动范围和副作用的解释能否被独立复核。
THE NEW ENTRY
Qwen 的 0.016% 补丁,修的更像是“堵车”
实验选中的 Qwen3.5-0.8B,本身就有一个公开的脆弱点。Qwen 官方模型卡提示:在思考模式及推荐采样参数下,这个尺寸的模型比同系列其他模型更容易进入 thinking loops,可能无法正常停止生成。
团队给 Astra 的不是测试集答案,而是载入权重的 Python 会话、GSM8K 与 MATH 训练集中的 14,744 道练习题,以及 10、25 或 50 次前向传播预算;不允许训练,也不提供梯度。按项目说明,Astra 将循环现象归到第 15 层和第 19 层 MLP 写出的同一方向,再从两层各 64 个 down_proj 输出列中减去这个方向,共动到 131,072 个权重。
在 50 次前向传播设置下,作者报告 MATH-500 从 7.9% 至 48.1%,GSM8K 从 13.8% 至 67.1%,IFEval 从 21.0% 至 62.3%;MATH-500 中触及 32,768 token 上限的回答比例从 93.0% 降到 33.1%。但 10 次和 25 次预算下,循环几乎没有明显消退,MATH-500 分别只有 12.3% 和 14.1%。
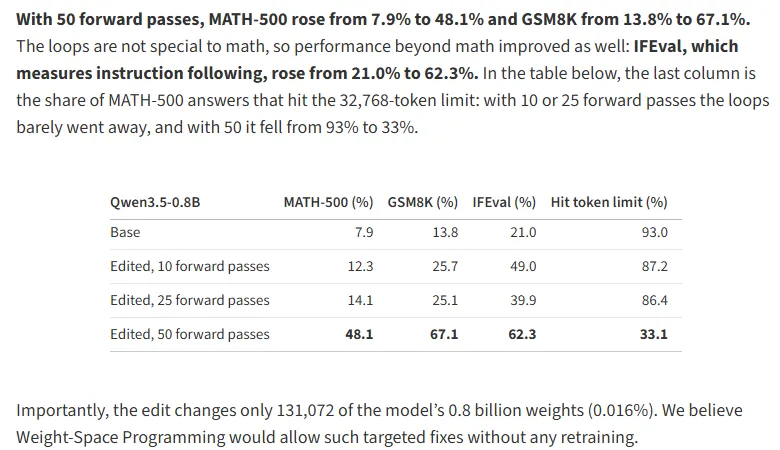
数学得分的大幅变化,很可能首先来自模型不再把大量 token 花在同一段推理上,从而终于有机会给出原本已具备部分能力的答案。作者对 Gemma 3 270M 的补充实验也支持这一点:当模型较少发生循环、错误是普通算术或代数推理问题时,权重编辑未能带来被作者视为成立的显著增益,MATH-500 只在约一个百分点范围内波动。
因此,“修复障碍”与“凭补丁添加新能力”不能混为一谈。项目页自己也把这一限制写得很直白:编辑可以移开遮住既有能力的障碍,却未能让模型获得原本没有的能力。
并且这次编辑并不是让模型在毫无外部约束的情况下随意“自改”,目标模型、故障表征、练习数据、允许调用的运行环境和前向传播次数,都是研究者预先设定的;补丁随后还需要由评测流程检验。把它理解为一种由语言模型提出的、可被执行和复测的定向维修方案,比理解成模型已经获得独立演化权,更贴近现有证据。
QWEN PATCH
从识别游戏到写入策略,哪些实验最有含金量?
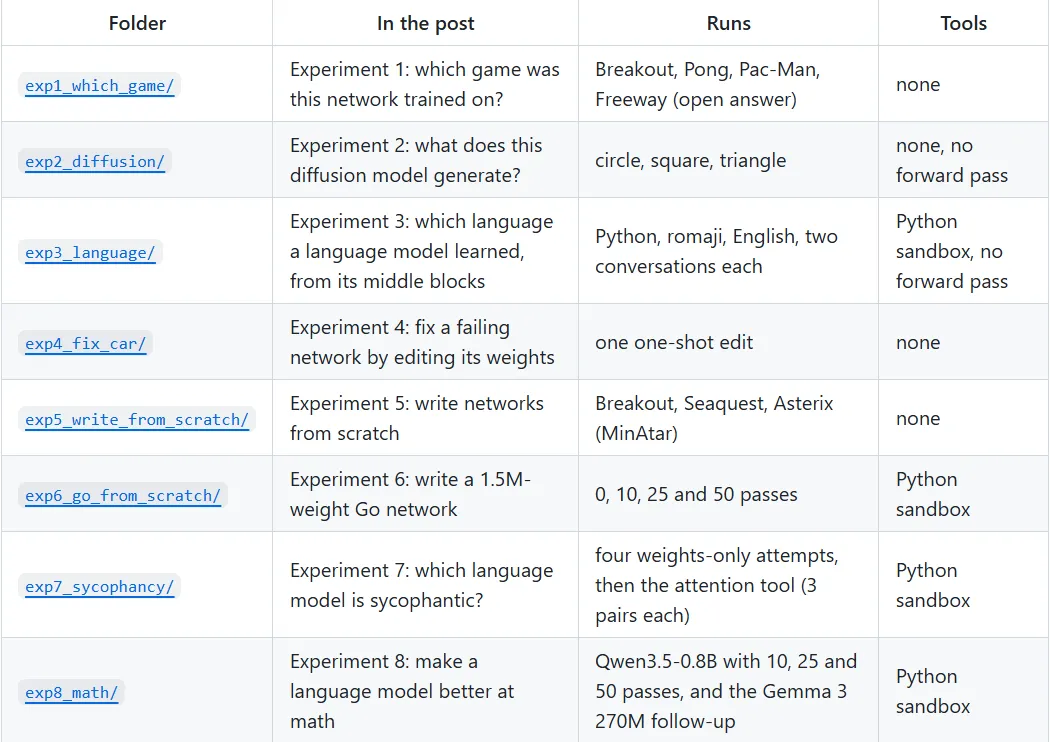
研究团队把 8 组实验分成读、修、写三类。在“读”权重的部分,四个架构、输入和动作空间相同的游戏策略网络被分别训练来玩打砖块、乒乓球、吃豆人和小鸡过马路;Astra 只看原始权重文本、没有候选名单,报告中四个都判断正确。另一个实验中,它从 7.16M 参数的字符级 Transformer 中间层辨认出模型训练自 Python、罗马字日语或英文,并找到了对应的复制头。
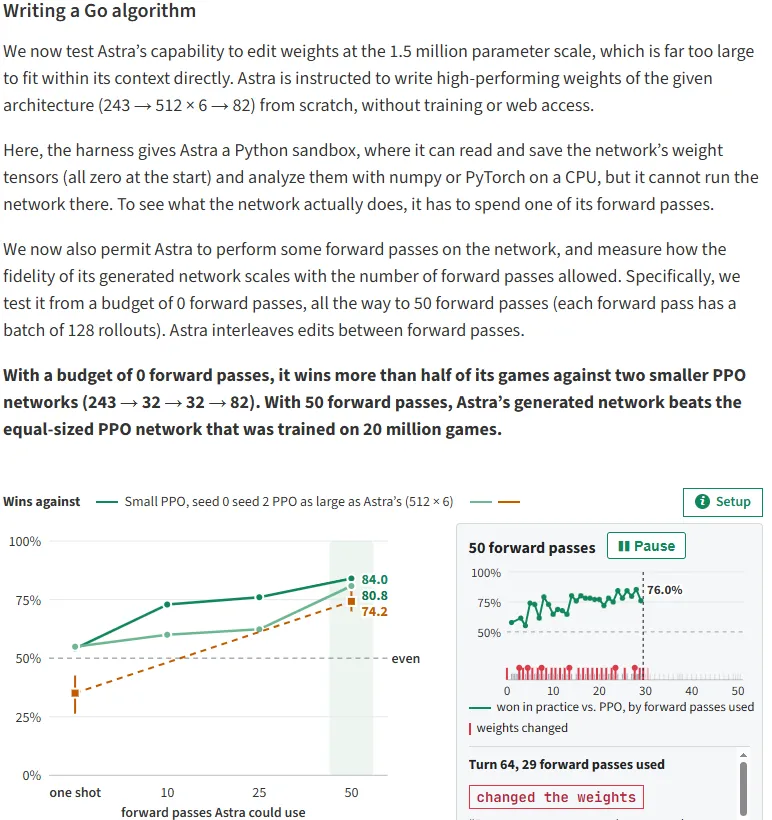
在“修”权重的部分,一个小车策略会直接冲坡、卡住。研究者提供权重、场景描述和失败轨迹;Astra 一次回复改动 3.5% 权重后,团队报告其在 1,024 局中全部成功。至于“写”权重,项目报告 Astra 根据规则和网络结构,零训练为三款 MinAtar 游戏写出小网络;在打砖块任务上,它的得分高于对照 PPO,但 Seaquest 和 Asterix 的比较并不构成全面领先。
这些演示的价值在于,它们把“权重只是不可读数字”的默认印象往前推了一步。但它们也有共同前提:网络架构被精心限定,任务规则明确,小网络或特定模块与自然语言描述之间存在较强的结构对应。
更复杂、更异构、权重规模远超上下文的通用模型,是否还能稳定做到“看懂—解释—修改”,现在没有答案。
WHAT IT CANNOT DO
可复现记录是加分项,不是同行评审的替身
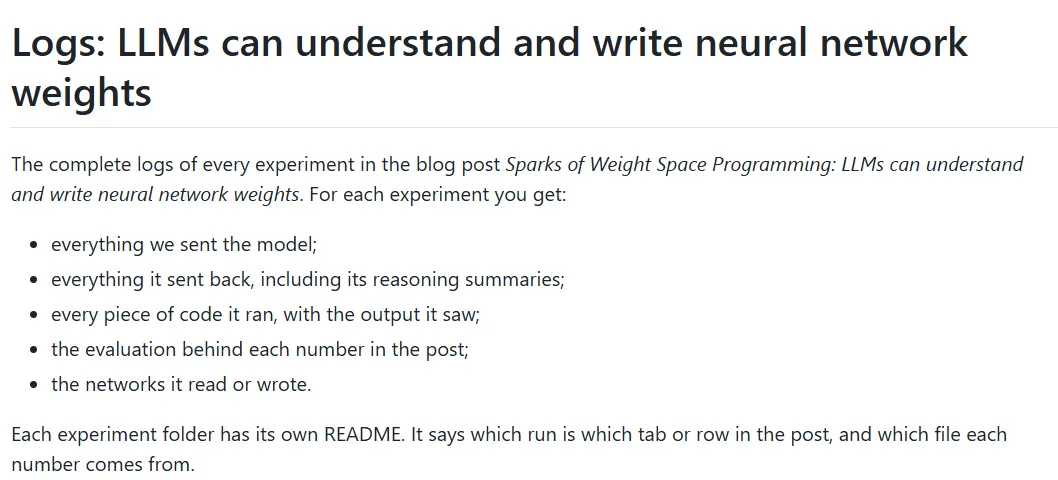
这次工作最值得肯定的工程选择,是公开了大量过程材料。GitHub 仓库列出每个实验发送给模型的内容、回复与推理摘要、执行代码和输出、评测文件及网络;项目称全部 1,125 个回合都经过工具调用审计。编辑后的 Qwen 权重补丁以精确差异形式发布,Hugging Face 页面还列出两个发生变化的张量及其哈希值。
编辑后模型页记录了一次按其协议进行的重建与 MATH-500 复跑:编辑模型在 500 道题、每题 4 次采样下得到 51.0%。这让“补丁是否确实能被重新应用”比只放一张成绩截图更可检查。
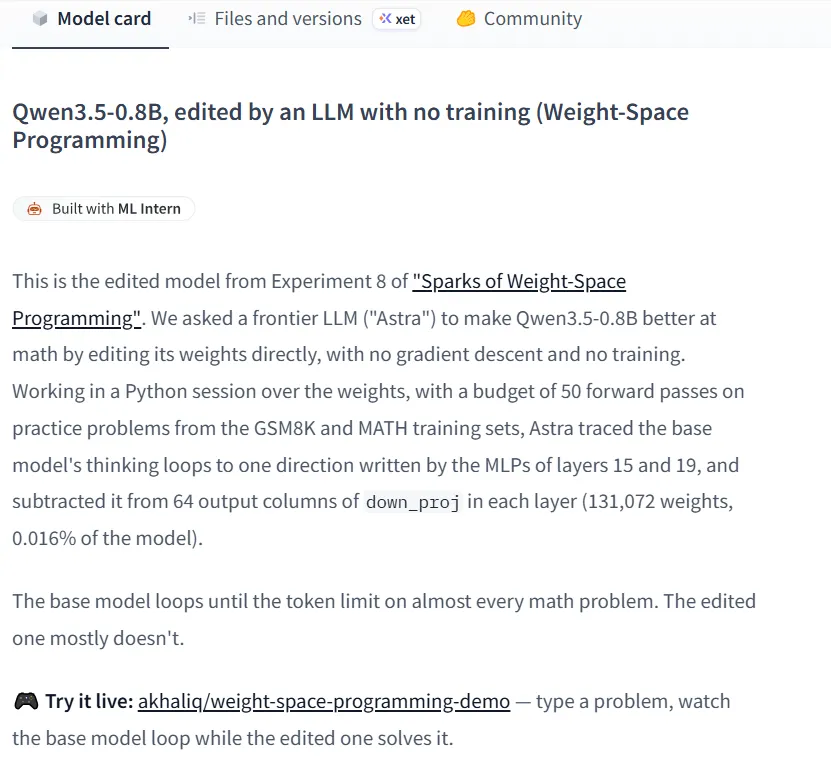
但还是要把“可复跑”与“已充分证实”分开。模型页对基座模型只列出了 25 题 smoke test,不能替代同等规模、同等采样条件下的完整基线复测;项目设置中提到还评测了六个其他基准,但公开主表集中展示了 MATH-500、GSM8K 与 IFEval。补丁是否保住了其他能力、在不同提示词和采样参数下是否稳定、会不会在安全性或多模态任务上引入退化,都需要更完整的回归测试。
READ · FIX · WRITE
真正的门槛,是把“会改”变成“可控地改”
如果这一路线继续发展,最现实的应用不是一声令下造出万能模型,而是模型维护:发现某个循环、某条异常行为、某个可解释的冗余方向后,用很小的权重改动做修复。它可能给机械可解释性、模型修补、遗忘指定行为与安全审计带来新工具,但每一项都带着相同风险:一段难以审计的权重差异,也可能隐藏后门、损失能力或让模型在未测场景失控。
对未来类似工作,至少应盯住四件事:其一,报告编辑前后所有核心能力与安全基准,而非只展示变好的几项;其二,在多个模型、规模和随机种子上复现;其三,发布精确 diff、哈希、评测脚本、推理配置和失败运行;其四,将“提出修改的模型”与“独立验证的流程”分开。能把某次补丁解释为哪条电路、为何只影响这类行为,才可能从令人惊讶的 demo 走向可靠的工程。
这项工作还远没有兑现“AI 递归改进一切模型”的叙事,却已经给出一个具体、可以被推翻也可以被复制的问题:通用语言模型能否成为权重空间与人类意图之间的翻译器?
SOURCES
|Takehi、Teoh、Zhang、Khattab:Sparks of Weight-Space Programming
https://rikiyat.github.io/blog/weight-space-programming/
|Rikiya Takehi 个人主页:MIT CSAIL 一年级博士身份与项目发布信息
https://rikiyat.github.io/
|实验日志、代码、网络与评测文件
https://github.com/RikiyaT/lm_understand-logs
|Qwen3.5-0.8B 官方模型卡:thinking loops 说明
https://huggingface.co/Qwen/Qwen3.5-0.8B/blob/main/README.md
|编辑后模型、精确补丁与复跑记录
https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming
当低价成为常态,真正稀缺的,是能把实验做深、把结果交清楚的团队。
DLAB 聚焦细胞、干细胞、动物、病理、分子与纳米材料六大实验方向,以真实实验平台和完整服务链路,为科研项目提供更可控的支撑。
科研没有“重来一次”的廉价选项,选择专业,是对课题时间与成果价值的负责。
具体服务内容、周期与交付标准咨询:ZCOOL21。