ARTICLE · 1344385
Coding Agent 并行写代码,源码控制系统怎么扩?
多个 Coding Agent 在同一个仓库并行开发,推送可能集中在同一时段,同一个提交也可能被多个 CI 任务同时拉取和检出。如果高峰期一条 PR 从推送到合入明显变慢,团队该从哪里查起,又该扩哪一层?
本文沿着一条 PR 从推送到合入的路径,定位写入、获取源码和合入各阶段的瓶颈。我们从 OpenAI 的 Pando 和 Anthropic 的 Scion 出发,结合 GitHub、GitLab、Google 和 Meta 的工程实践,看看哪些问题可以靠减少 CI 的重复取数解决,哪些需要扩展 Git 后端或调整客户端与服务端的分工,以及改完怎么验证。
先确认 PR 慢在哪一步
从高峰期挑几条 PR,用 PR 编号和提交 ID 对齐推送、CI 和合入记录。分别记下推送的提交 ID 和 CI 实际检出的提交 ID。如果 CI 检出的是临时合并提交,能取得该版本的生成时间时,再单独记录它从生成到可读的间隔。
多个任务并行时,沿着实际阻塞合入的任务路径看耗时。整条流水线发出的源码请求次数单独统计。
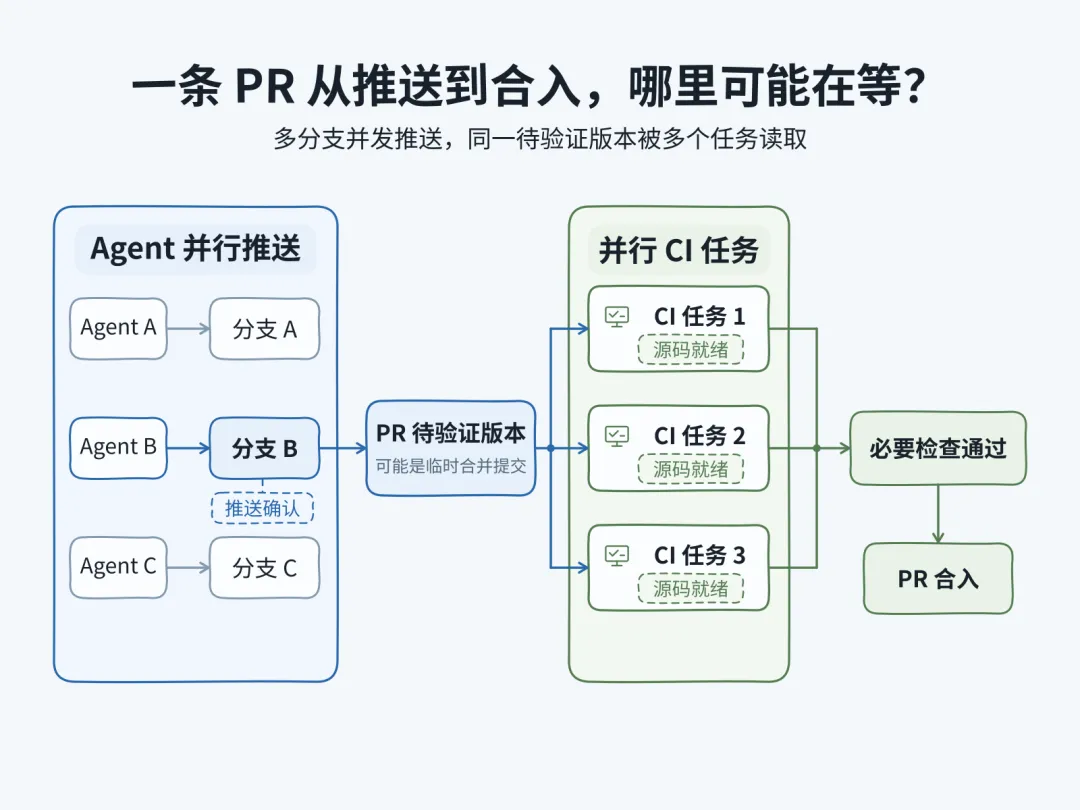
图 1:从推送到合入的排查路径
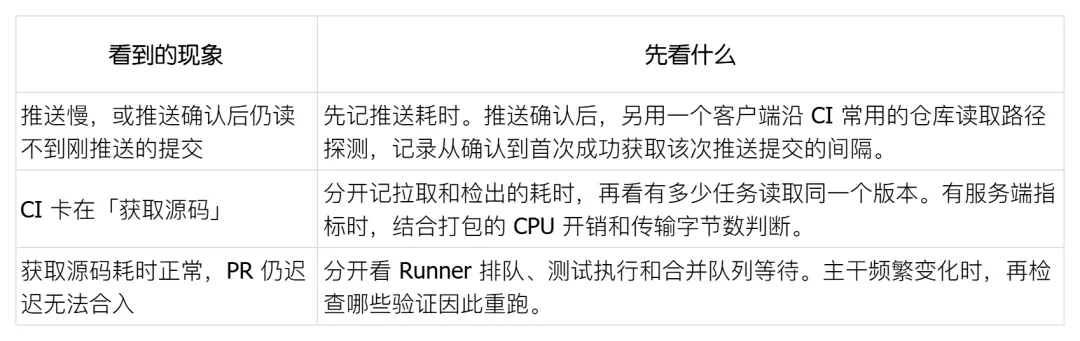
探测开始时,客户端本地应尚无目标提交,并使用固定的探测间隔;记录的是首次观测到该提交可读的时间。如果等待已经出现在推送阶段,先对照同一分支和不同分支上的并发推送,看看延迟是集中在某条分支,还是多条分支同时变慢。
写入协调的粒度
如果不同分支的推送也一起变慢,就顺着服务端记录看时间花在哪。可以把钩子执行、对象校验、副本同步和引用锁等待的耗时分开。如果每次更新都要经过仓库级协调,互不相关的分支写入也会排队。
GitHub 在「The bridge to agent-scale Git infrastructure」中记录了跨区域迁移时遇到的写入瓶颈。旧架构在等待副本响应期间会一直持有仓库级锁。一个副本响应慢,更新其他分支的请求也得等。GitHub 的改造把副本间的协调范围缩小到单个引用,使不同分支的更新可以并行。
OpenAI 在「OpenAI 如何扩展 Git」中介绍了为内部单体仓库重建的 Git 后端 Pando。它兼容 Git 协议和客户端,也按引用独立协调写入。同一个引用上的更新可串行化,系统会记录读取各版本所需的历史依赖。一次拉取涉及多个分支时,各分支的头提交可能来自不同时间点。OpenAI 披露,整体切换到 Pando 后,单体仓库的推送延迟中位数下降近 80%。
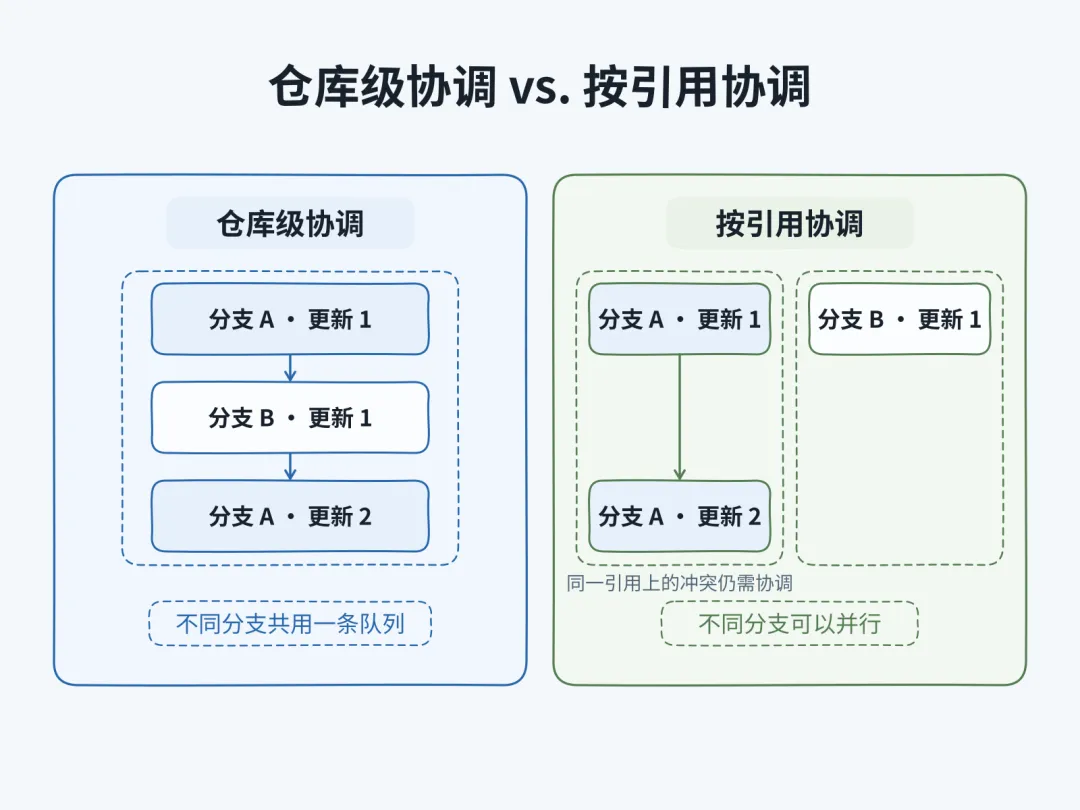
图 2:仓库级协调与按引用协调
验证类似改动时,可以用多个独立分支上的并发推送测吞吐和尾延迟,再观察主干、发布分支等热点引用上的排队和更新冲突。合并验证和代码冲突解决的耗时也要分别评估。还要核对现有工具是否依赖多个分支在同一时刻的引用状态。
读取路径上的计算与分发
推送已经确认,目标提交也能读到了。多个 CI 任务同时取同一个版本时,仍可能耗在服务端打包、网络传输或客户端检出上。Git 拉取时,客户端和服务端会协商需要传哪些对象。如果每次请求都要现场生成包,即使带宽还有余量,服务端也可能先卡在打包上。
上一节提到的 Pando 会根据客户端已有的历史选出一组可复用的包,再通过 Git 协议 v2 的 packfile-uris 扩展提供下载地址。后台还会归并小包,减少客户端追赶主干时需要下载的包数。这种做法省去了重复打包,客户端有时也会下载到本地已有的对象。
Anthropic 在「Redesigning source control at Anthropic」中介绍了 Scion,这是它为内部单体仓库开发的源码控制系统。客户端先检查本地缺哪些目录树和文件内容,再按对象请求。缓存可以直接返回所需对象,省去服务端为每个客户端计算缺哪些对象并重新打包的工作。评估读取路径时,可以分开记录服务端的打包 CPU 时间、客户端下载的字节数和传输耗时。
在一条流水线上做对照
如果重复读取集中在同一条流水线,可以先试试准备一次源码,再分发给多个任务。选一组原本并行、使用同一版本源码的任务,固定目标提交、任务集合和 Runner 条件。两条路径都从流水线启动计时,直到最后一个参与对照的测试任务完成。
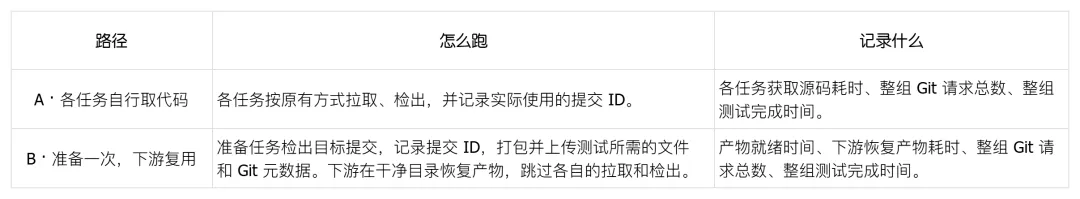
在 GitLab CI 中,下游可以用 GIT_STRATEGY: empty 准备干净的构建目录,并通过 needs:artifacts 获取上游产物。先核对两条路径实际使用的提交一致,并确认产物包含测试所需的工作区文件和 Git 元数据。依赖标签、子模块或 LFS 内容的任务,还要核对相应数据是否齐全。然后,在相近的缓存条件下重复运行。只有 CI 日志时,先数取源码步骤执行了几次。有服务端日志时,再统计实际请求数,把准备产物的任务也算进去。
GitLab 在「CI configuration performance」中记录了自家流水线的改动。部分高并发 RSpec 任务改用仓库产物后,当时每个相关任务约省 15 秒,同时每条流水线多保存一份产物。原本可以独立启动的任务仍直接取源码,以免等产物就绪。如果你的对照里 Git 请求少了,整组测试却结束得更晚,先查产物准备是否挡住了原本可以并行启动的任务。
客户端需要多少历史和文件
多个 CI 任务可以复用同一份仓库产物,但每个任务仍要下载产物、准备工作区。要进一步减少开销,可以先看任务需要多少提交历史、哪些对象可以稍后下载,以及哪些文件需要写入工作区。
只需要近期的提交历史。可以用浅克隆缩短历史。如果任务需要找合并基准或查询版本历史,要确认克隆深度足够。
部分对象可以用到再取。部分克隆中,blobless 会推迟下载文件内容,treeless 还会推迟下载目录树。比如在 treeless 克隆中按路径查提交历史,可能触发大量目录树补取。离线时能否完成查询,取决于所需对象是否已在本地。
工作区只需要一部分文件。可以用稀疏检出减少实际落盘的文件。它也可以和完整克隆搭配,保留离线查询所需的仓库对象。
还可以改变客户端访问仓库的方式。Google 在论文「Why Google Stores Billions of Lines of Code in a Single Repository」中分享了云端工作区 CitC。开发者通过文件系统看到共享的 Piper 仓库和自己的改动,工作区只保存改过的文件。按论文当时的统计,每个 CitC 工作区平均保存的修改文件不到 10 个。
Anthropic 的源码客户端主要是在线的 Agent 和自动化任务,前面提到 Scion 围绕这一使用方式重新划分了客户端与服务端的职责。部分历史查询由服务端完成,只需要查询结果的任务可以省去本地仓库的准备和维护。CI 任务如果只需要查询两个提交的差异或共同祖先,可以直接请求结果;需要读取文件时,再准备工作区。切换到 Scion 后,Anthropic 内部 CI 和研究任务的代码检出耗时从分钟级缩短到秒级。
评估时,分开记录首次取数的耗时和数据量、构建或查询触发的补取,以及工作区的磁盘占用。越依赖按需获取,越要检查服务端不可达时,哪些 IDE 操作、脚本和历史查询还能完成。
对象与元数据的发布边界
CI 可以只取任务需要的数据,实际检出的版本仍须与流水线要验证的提交一致。Git 本身已经区分对象接收和引用更新。分布式后端还需要检查,这些步骤是否占用了过大的共享协调范围。通过分支获取源码时,一旦读取端看到新的分支头,就应该能取到这个版本所需的对象。如果上传、校验和引用更新都占用同一个仓库级协调步骤,慢上传也可能拖住其他分支的更新。把数据写入移出引用更新的协调范围后,还要处理两步之间的失败。
Pando 把推送包流式写入对象存储,同时验证数据。包写入并校验通过后,Pando 在同一笔元数据事务里记录引用版本并更新引用指针。引用版本记录了新的分支头、对应的包,以及这个包依赖的历史版本。
Scion 在服务端创建变更集,记录相对于第一父提交改动了哪些文件,以及这些文件的内容地址。客户端可以直接读取变更集。需要移动分支引用时,再单独更新引用。
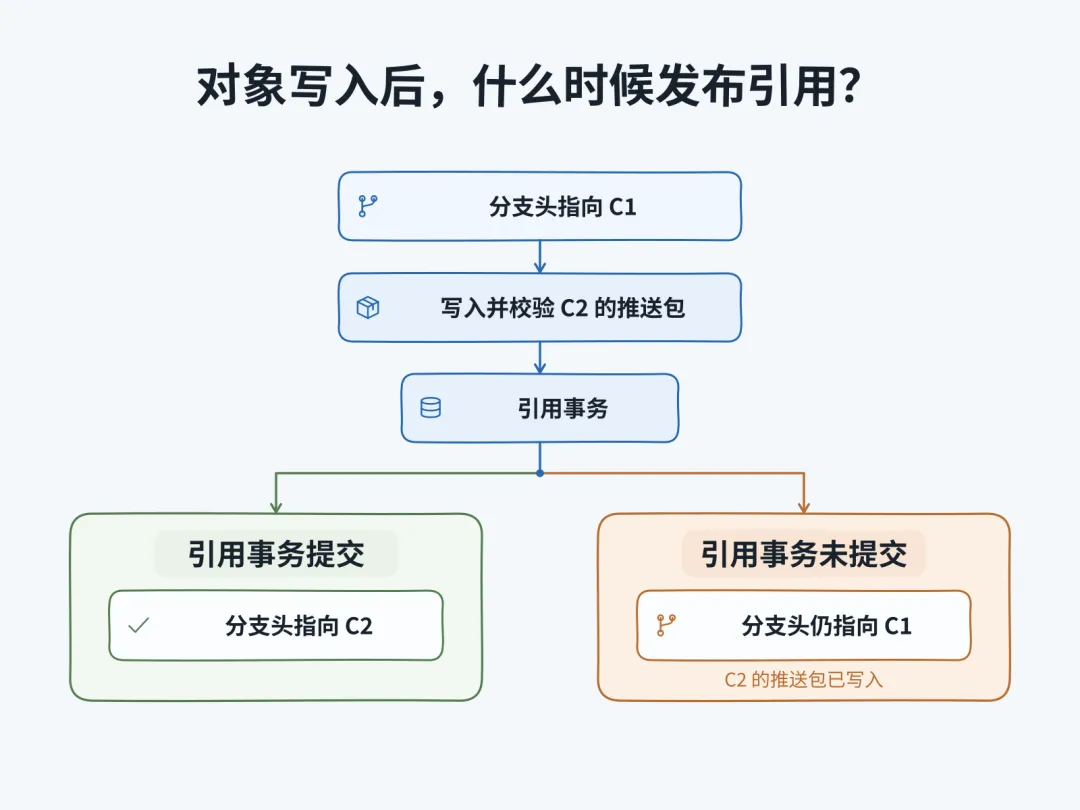
图 3:对象写入与引用发布
测试时,可在对象已经写入、引用事务尚未提交时注入失败。确认客户端通过该分支仍能读到先前发布的版本。重试时,重新核对当前引用值和对象是否可用。后台清理也要保留仍可能在重试中发布的对象。
还要覆盖引用事务已经提交、但客户端没有收到成功响应的情况。检查系统如何确认该次更新的结果,并安全处理后续重试。
再让两个请求基于同一个旧分支头,尝试把分支更新到不同的提交。确认一个更新成功后,另一个仍以旧分支头为前提的更新会被拒绝,并检查成功发布的提交仍然可读。
缓存与水平扩展的边界
目标提交已经可读,接下来要看一批 CI 任务同时读取时,分发能不能跟上。如果每份读取副本都保存完整仓库,存储占用会随副本数近似线性增长。更新也要同步到各副本,维护开销取决于更新频率和复制方式。
Anthropic 在 Scion 的工程复盘中提到,其 CI 每天约有 2,500 万次检出,高峰期曾维护数百个内部 Git 镜像。随着合入加快,镜像越来越难维护,用于启动任务的仓库快照也会在两次刷新之间落后主干更多。
Pando 则通过区域缓存分发已经生成的 Git 包。缓存未命中时,分发服务从对象存储读取已有的包。Scion 缓存的则是目录树和文件内容对象。同一台机器上的任务共享节点缓存,缺失对象先向区域缓存请求,区域缓存未命中才访问权威服务。Scion 固定了各层的访问路径,以免区域缓存故障时,大量节点直接把流量打到权威服务。Anthropic 披露,按 CPU 和内存需求衡量,Scion 的基础设施规模约为原 Git 镜像方案的 1/200。
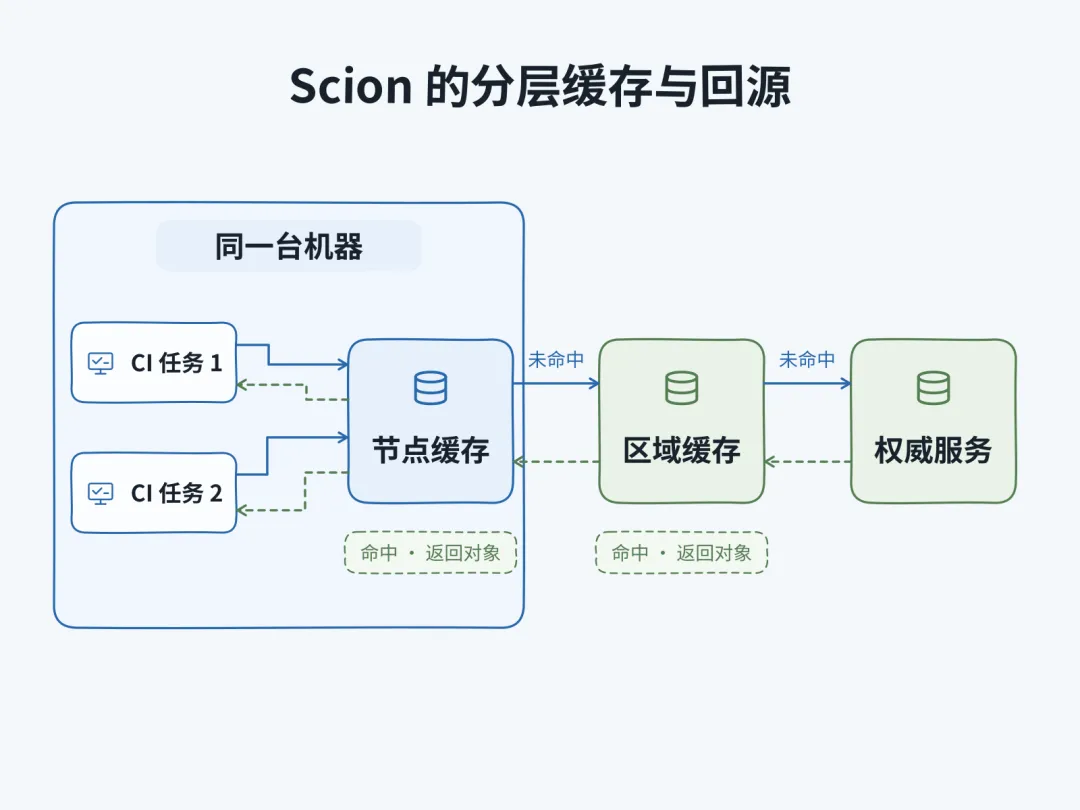
图 4:Scion 的分层缓存与回源
测试时,用相近的并发量和请求分布对照冷热缓存,分别记录各层的命中率、回源流量和读取尾延迟。如果采用异步刷新的快照或副本,则要按提交 ID 核对 CI 实际读到的版本。当前节点尚未同步到目标提交时,要明确是等待同步,还是从已经能提供该提交的上游读取。
引用的规模与生命周期
缓存可以复用已经生成的包和对象,分支头仍会随着推送更新。即使不同分支已经能并行写入,枚举、通告和清理大量引用仍有成本。OpenAI 在 Pando 的工程复盘中给出例子,分支达到数百万时,仅全量引用通告就可能超过 100 MiB。
缩小每次操作涉及的引用范围。推送新功能分支时,Pando 默认只通告一个指定的主干分支,供客户端打包时作为基准。已有对应主干历史的读取端只需再下载这个包。写入端如果反复以主干为基准推送同一功能分支,则可能重复上传主干之外的对象。查询引用时,客户端也可以在 Git 协议 v2 的 ls-refs 请求中带上 ref-prefix,提示服务端缩小返回范围。
清理过期的临时引用。可以按命名空间观察引用数量和删除耗时。GitLab 在「Troubleshooting monorepo performance」中提到,并发删除 packed-refs 中的条目可能因文件锁竞争而失败。发往副本的删除失败后,还会触发复制任务让副本追上。批量删除引用是 GitLab 给出的一项缓解措施。
减少工作流需要长期维护的分支。Google 在 Piper 的实践中以主干开发为主,分支主要用于发布。Scion 的工作流也倾向于把引用留给主干和发布分支,普通变更集可以独立创建和读取。
如果同一组件的多个版本需要长期并存,还要在版本间合并改动,Meta 在「Branching in a Sapling Monorepo」中介绍了 Sapling 的目录级分支。Sapling 在提交元数据中记录目录的复制与合并关系,据此找到共同祖先,在目录范围内做三方合并。这类合并在仓库级提交图中仍表现为线性提交。试点时,可以核对目录历史能否沿复制关系追溯,以及 CI 实际选中了哪个目录版本。
迁移与工具链兼容
分支的表示方式变了,CI 需要确认如何选版本,代码审查工具也需要确认如何追溯历史。改动源码控制系统前,先盘点 CI、Agent 框架、代码审查工具、IDE 和脚本依赖哪些行为,包括本地历史、离线操作、分支引用、权限和事件格式。根据这些依赖,确定哪些任务可以先试点,哪些工具需要一起切换。
Pando 最初作为 Git 读写请求的代理层(proxy)接入旧系统,让两套系统保持同步。OpenAI 随后分阶段迁移 Git 客户端,同时迁移依赖旧 API、webhook 和仓库下载的集成。Scion 在新客户端、仓库格式和协议就绪前,先提供提交祖先关系、逐行追溯改动来源等查询。Anthropic 团队在五个月内建成了 Scion 及配套系统,并将内部单体仓库从 Git 迁移到 Scion。
选一批实际任务,分别走新旧路径。先核对任务读到的源码版本、查询结果、权限判断和事件触发,再比较高峰期的耗时、失败率和重试次数。如果要切换写路径,提前演练切换失败后怎样恢复服务,并检查已经发布的变更是否仍然可读。
小结
多个 Coding Agent 在同一仓库并行开发时,先用高峰期的 PR 和 CI 记录,分清等待发生在推送、获取源码还是合入。不同分支的推送都卡在仓库级协调,就评估能否把协调范围缩小到单个引用。多个 CI 任务反复取同一个版本,可以先试产物复用。服务端反复打包,就检查已有包能否复用。读取延迟主要出在缓存未命中时,就检查上游能否承接高峰期的回源流量。任务只需要少量文件或一次历史查询,可以评估按需获取或直接查询服务端。
如果获取源码耗时正常,主要等待发生在 Runner 排队、测试执行或合并队列,就先处理对应环节。改完用同类高峰负载复测,确认原先的等待缩短,CI 仍能拿到要验证的版本,再扩大试点范围。
参考资料
OpenAI ,OpenAI 如何扩展 Git,openai.com/zh-Hans-CN/index/scaling-git-at-openai/
Anthropic, Redesigning source control at Anthropic, www.anthropic.com/research/redesigning-source-control
GitLab, Troubleshooting monorepo performance, docs.gitlab.com/user/project/repository/monorepos/troubleshooting/
GitHub, The bridge to agent-scale Git infrastructure, github.blog/engineering/the-bridge-to-agent-scale-git-infrastructure/
Google, Why Google Stores Billions of Lines of Code in a Single Repository, research.google/pubs/why-google-stores-billions-of-lines-of-code-in-a-single-repository/
Meta, Branching in a Sapling Monorepo, engineering.fb.com/2025/10/16/developer-tools/branching-in-a-sapling-monorepo/
GitHub, Get up to speed with partial clone and shallow clone, github.blog/open-source/git/get-up-to-speed-with-partial-clone-and-shallow-clone/
相关推荐:
构建持续进化的 Agent:从 GitHub 仓库提取工作流并生成 Skill 的 8 步流程
2.5 万个 Agent PR 的实证:Codex、Claude Code 和 Copilot 涌入 GitHub 一年,到底做出多少产出?
#CodingAgent #源码控制 #Git #持续集成 #系统扩容 #Monorepo #DevInfra #分层缓存 #Pando #Scion