ARTICLE · 1345652
AI总结PDF全是车轱辘话?3步建出可追问的资料库
不知道你有没有跟我一样的经历:为了搞明白一个新技术或者行业概念,顺手保存了十几篇公众号深度长文、七八个技术团队的博客,顺手还下载了三篇几十页的英文白皮书。当时心满意足,觉得自己马上就要掌握这门手艺了。
结果到了周末,看着桌面那一堆密密麻麻的 PDF 和收藏夹链接,头皮一阵发麻。随手把它们打包扔给 AI,输入一句经典的:“帮我全面总结一下这些资料的核心内容。”
结果呢?AI 吐出来一段看似洋洋洒洒、实则全是“首先、其次、总之”的万能车轱辘话。当你真想知道某个参数怎么配、哪种架构在什么场景下有坑时,再去追问,它就开始面不改色地把互联网公共语料胡乱嫁接进来,甚至凭空捏造公式。更要命的是,你根本不知道它的结论到底是从哪篇文档的哪一行抠出来的,最后还是得自己一页一页翻原文去求证。
把所有资料塞进 AI 不叫建知识库,那叫给 AI 喂垃圾信息。要让 AI 成为一个靠谱的私人研究助理,核心逻辑只有一条:不把它当成全知全能的搜索引擎,而是把它当成一个被剥夺了外部记忆、只准盯着这几份纸看的可追问资料管理员。
今天我们就用一个完整的例子,把从乱糟糟的 PDF 和网页,一步步变成可以精准追问、出处明确、能随时抽查的小型资料库。
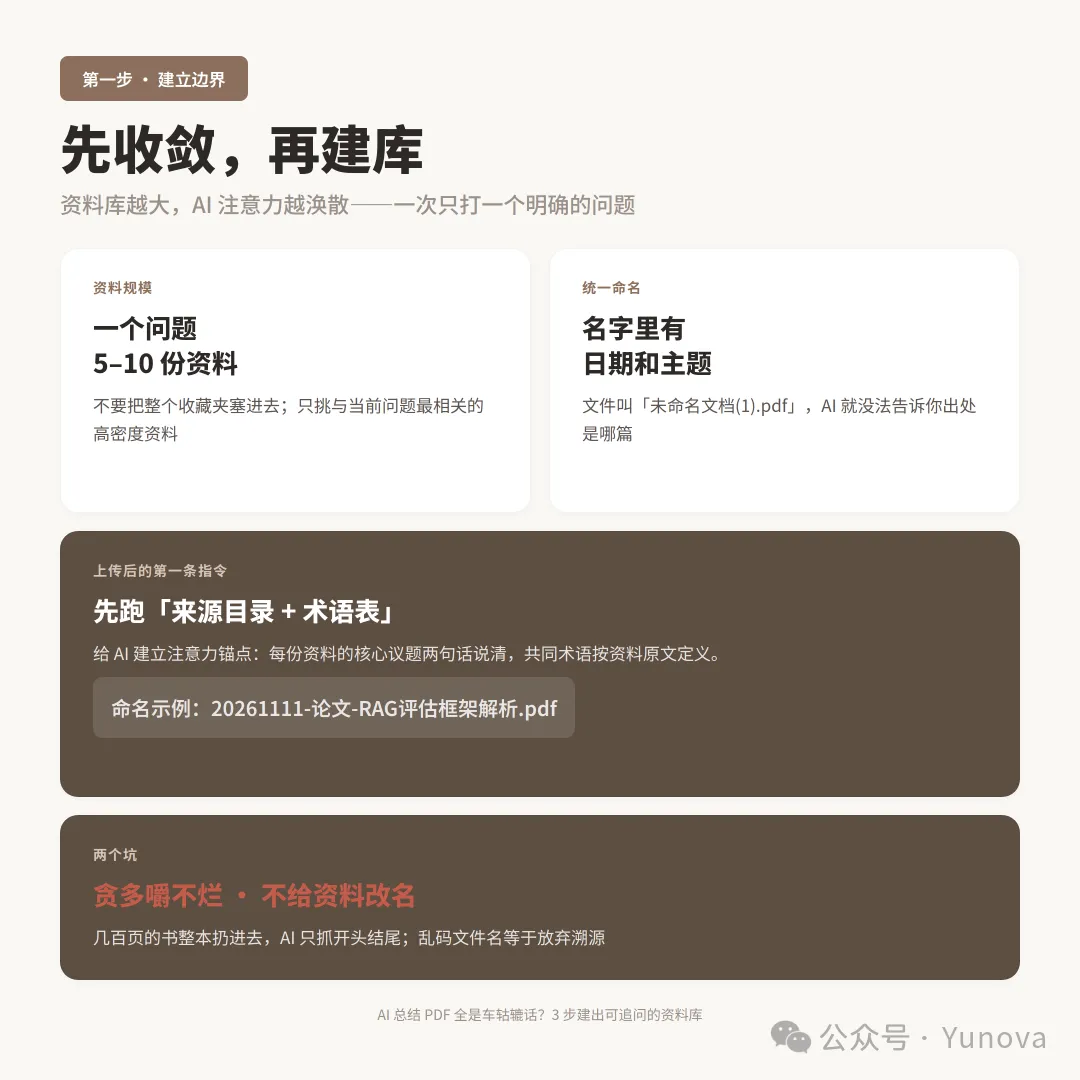
第一步:建立边界(资料收敛与目录建立)
很多人用 AI 读资料的第一步就错了——总想着“大而全”。资料库越大,AI 的注意力越涣散,检索时相关性掉得越快,胡说八道的概率,在我的使用经验里明显上升——这是经验判断,不是实验结论。
真正高效的做法是:一次只打一个明确的问题,只围绕这个问题收敛 5–10 份高密度资料。
真实走例:研究“RAG 的评估指标”
假设你手头正在优化一个知识库问答项目,想弄清楚业界是怎么科学评估检索与生成质量的。这时候不要把整个 RAG 的教程都找来,只挑 4 份核心资料:
20240315-论文-Ragas评估框架解析.pdf(学术界权威指标)2.20240520-技术博客-TruLens核心三元组实践.html(工程落地指标)3.20240810-行业白皮书-企业级知识库评测标准.pdf(企业落地规范)4.20240901-官方文档-GoogleNotebookLM评估指南.pdf(公开标杆案例)先说明一句:这 4 个文件名是演示用的示例文件,主题分别取自 Ragas 论文、TruLens 技术博客、企业评测白皮书和 Google NotebookLM 帮助文档这类公开来源;你在自己电脑上换成任何一组同类资料,流程一模一样。后面第三步还会讲到这一轮里 AI 犯过的一次引用错误,被我用原文抽查纠了回来。
资料上传后,千万不要一上来就问“怎么做评测”。你的第一条指令,必须让 AI 明确自己的“视野范围”,把所有资料当面盘点一次。
可复制的索引 Prompt
# 角色:严谨的学术资料管理员 # 任务:为你面前的这组资料建立清晰边界 # 输入:已上传的 4 份资料 # 要求: 1. 输出一份【来源目录】:标明每份资料的文件名、核心议题和主要结论(每篇不超过 2 句话)。 2. 输出一份【核心术语表】:提取资料中共同出现的 5 个核心专业术语,并严格基于资料给出定义。 3. 如果某份资料内容损坏或无法阅读,立即指出。AI 给出的反馈示例
【来源目录】
• 20240315-论文-Ragas评估框架解析.pdf:提出无真实标签情况下的评估机制,重点衡量忠实度与相关性。•20240520-技术博客-TruLens核心三元组实践.html:拆解上下文相关性、扎根性和答案相关性的工程实现。【核心术语表】
1.Faithfulness(忠实度/扎根性):生成答案中的每一句陈述能否在检索出的上下文里找到直接推导依据。
这一步的作用不是给你看的,是给 AI 建立注意力锚点。一旦目录和术语表被固定在对话上下文的前部,后续提问的定位准确度,至少在我的用法里明显变好。
常见坑点
未命名文档(1).pdf 或 download.html,后续 AI 根本没法告诉你出处是哪篇。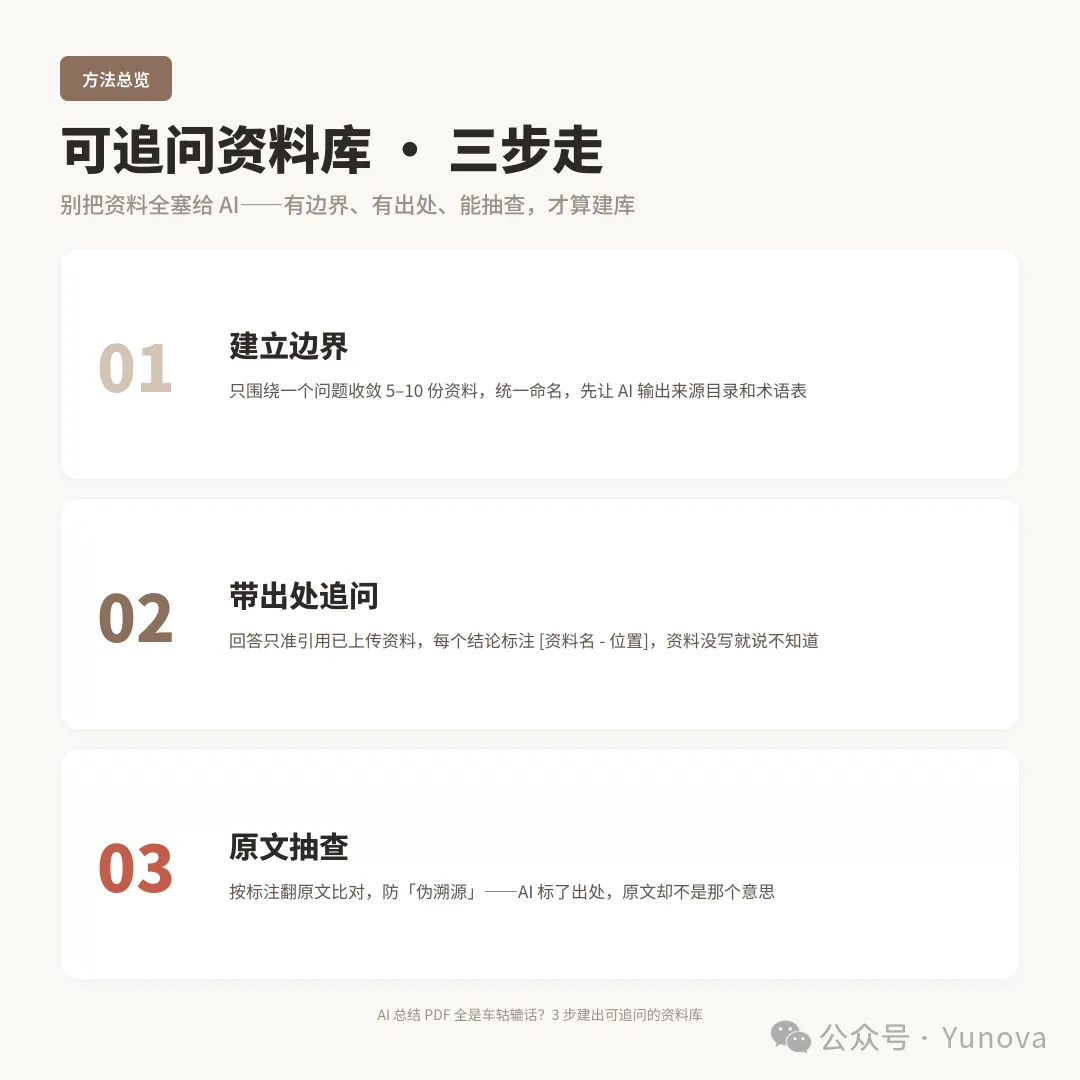
第二步:结构化追问(带标注回答与拒答测试)
有了清晰的边界后,接下来进入追问环节。这里的核心是:剥夺 AI 使用外部预训练知识的权利,并强行要求每次给出的结论都挂载“证据链”。
真实走例:向资料库追问具体差异
你不满足于知道术语名字,你想知道这几套评估方案的具体计算差异。比如追问:“Ragas 和 TruLens 在评估答案忠实度时,具体的计算公式和判定逻辑有何不同?”
如果你直接问,通用大模型会开始把网上的第三方博客甚至错误的数学公式套进来。我们必须用严格的 Prompt 限制它。
可复制的追问 Prompt
# 任务:基于资料回答具体问题 # 问题:Ragas 和 TruLens 评估“忠实度”的具体差异是什么? # 规矩: 1. 回答规则限定为只引用上述已上传的资料,禁止补充任何外部未提及的知识。 2. 每一个核心论点,必须在句末标注出处:[文件名 - 章节/页码/小标题]。 3. 严格执行“可拒答”原则:如果资料里只提到了概念但没给计算公式,请直接写“资料中未提及公式”,绝不能自行编造。AI 给出的规范回答呈现
在评估忠实度时,两者均关注生成内容是否脱离参考文本,但工程落地侧重点不同:
1.Ragas 的判定逻辑:先将生成答案拆解为独立的句子陈述(statements),再逐句去检索切片中判断是否得到支持,最终得分等于获得支持的陈述数除以总陈述数。[出处:20240315-论文-Ragas评估框架解析.pdf - 第4页 Methodology]2.TruLens 的判定逻辑:侧重于三元组闭环,使用大模型对 Context 和 Response 进行二分类判别,重点检测模型是否输出了未经检索支持的外部实体。[出处:20240520-技术博客-TruLens核心三元组实践.html - 核心三元组评估流程]3.计算公式补充:资料中仅 Ragas 论文附带了数学表达式,TruLens 博客中未提供数学公式,仅展示了 API 调用方法。[出处:资料实测比对]
看,当 AI 明确告诉你“TruLens 博客中未提供数学公式”时,这个知识库就成了——它没有去网上乱翻一个公式塞给你,而是保住了证据的纯洁性。
常见坑点
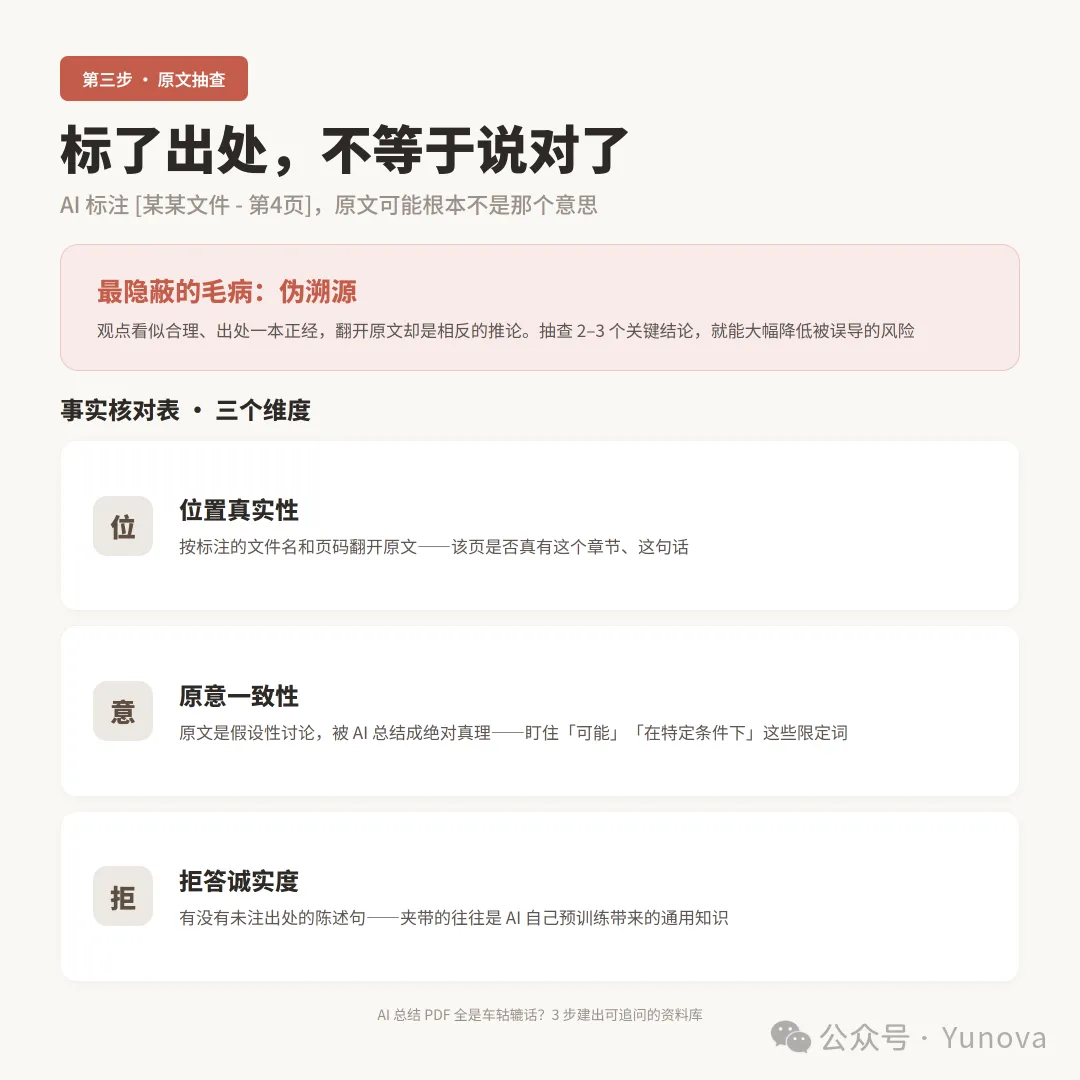
第三步:原文抽查(证据链物理核验)
AI 标注了出处,就意味着它说的全对吗?绝对不是。大模型在 RAG 场景下最隐蔽的毛病,叫做伪溯源(Source Hallucination)——它给了一个看似合理的观点,后面一本正经地写着 [某某文件 - 第4页],但你翻开第 4 页,原文根本不是那个意思,甚至是完全相反的推论。
因此,最后一步也是最关键的一步:手动抽查。你不需要把每页读完,但必须建立起一套抽查习惯。
真实走例:具体怎么做物理比对?
我们以上面 AI 说的这一句为例进行抽查:
“先将生成答案拆解为独立的句子陈述(statements),再逐句去检索切片中判断是否得到支持…… [出处:20240315-论文-Ragas评估框架解析.pdf - 第4页 Methodology]”
实操核验三步动作:
20240315-论文-Ragas评估框架解析.pdf,按 Ctrl+F 快捷键,直接跳到第 4 页的 Methodology 小节。2.核对核心动作:在第 4 页寻找关键字 statement 和 fraction。原文写道:“...we first decompose the response into a set of individual statements... then evaluate the fraction of supported statements.”3.核验结论:原文确实是这个拆解逻辑,AI 的“获得支持的陈述数除以总陈述数”转译准确,没有移花接木。这一轮里它真犯过一次:原文写的是“建议人工抽样”,它总结成了“全自动计算”。我就是靠下面这套比对动作抓出来的——把这段原文贴回对话框,执行事实修正:
我抽查了 [20240315-论文-Ragas评估框架解析.pdf] 第 4 页原文: "..." 你刚才的回答把人工抽样错写成了全自动计算。请根据这段原文重新修正你的结论,并指出错误原因。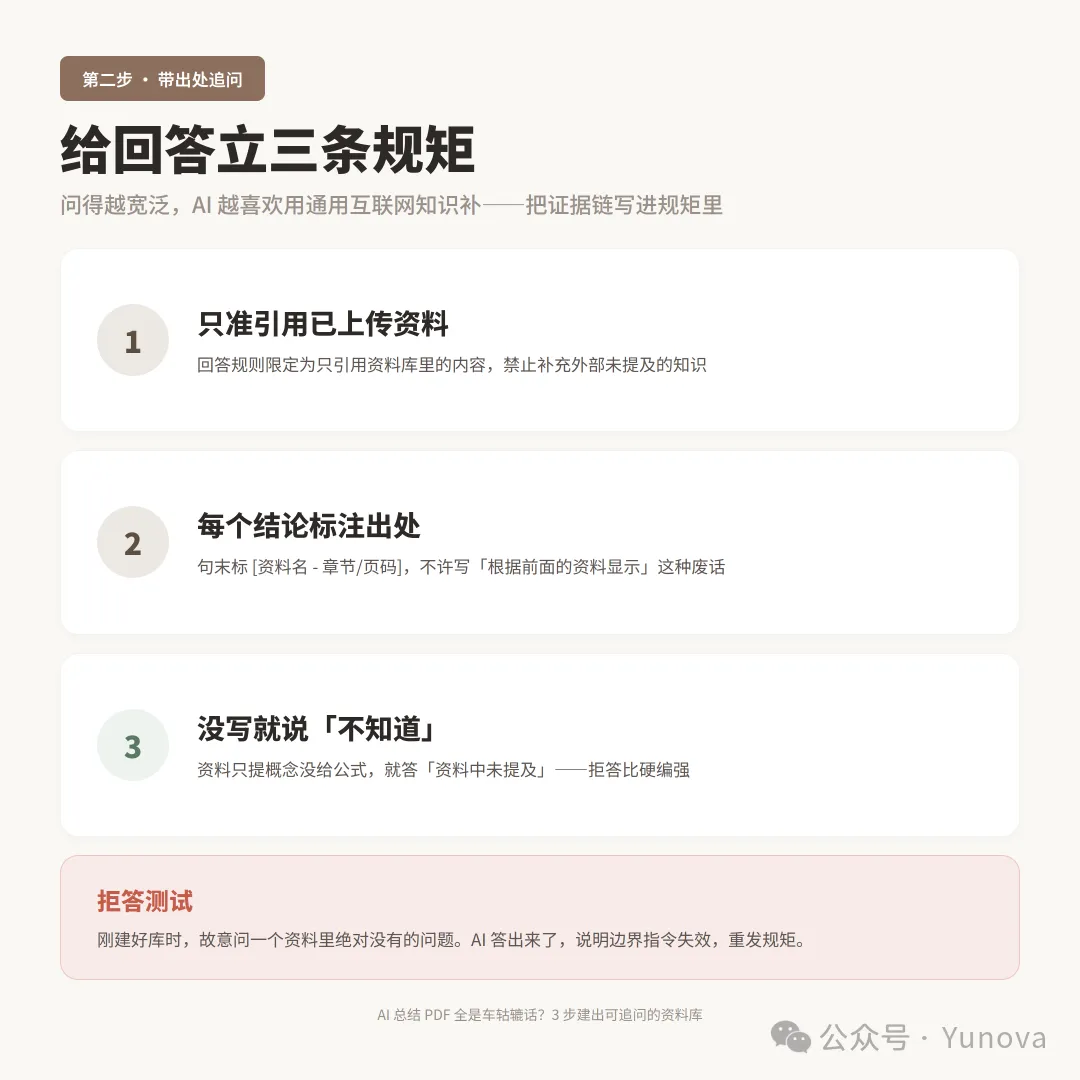
资料管理模板(直接复制可用)
为了让你不用每次都重新想规矩,这里提供一套标准化流程模板,建议直接保存在你的笔记软件或提示词库中。
1. 文件命名预设(上传前改名)
统一的命名让 AI 在回答时能够极其精准地进行定位:
[八位日期]-[资料属性]-[核心主题]-[版本/篇名].pdf•示例:20241024-架构设计-向量检索性能优化-v1.pdf•示例:20241102-官方文档-GeminiNotebook使用指南.html2. 标准提问模板(System Prompt)
# Role: 严谨的文献研究分析师 # Task: 基于限定资料库进行精准问答与证据溯源 # Rules: 1. 严格使用提供的资料回答,不得引入未经证实的外部先验知识。 2. 每个独立结论后必须附带 [文件名 - 页码或章节标题]。 3. 遇到资料未提及或模糊不清的问题,严禁推演,必须直接声明“资料未提供该信息”。 4. 语言保持客观精炼,优先输出对比表格或分点逻辑。3. 事实核对表(抽查核验标准)
在准备采用 AI 总结的结论写方案或做决策前,对照下表抽查 2–3 个关键点:
| 位置真实性 | ||
| 原意一致性 | ||
| 拒答诚实度 |
最小验收清单:怎么算真正建好了?
读完这篇文章,如果你打算马上用手头的资料试一试,请对照这份最小清单检查你的操作:
[文件名 - 章节/页码]。•测过边界拒答了吗? 问一个资料库里没有的问题,AI 是否诚实地回答了“不知道”。•抽查过原文关键行了吗? 至少按出处翻开过一次原文件的具体页码,核对过一处原文表述。不要再做假装勤奋的资料搬运工了。建一个有边界的小型资料库,让关键结论经得起至少 2–3 处原文抽查,才是把海量文档变成真正战斗力的正确姿势。
现在就可以试:拿你手头任意一份 PDF,把第一步、第二步跑一遍,卡在哪一步,回来留言告诉我。