ARTICLE · 1352301
把 PDF 发给 AI 前,先做这个 10 秒检查
文件传上去就万事大吉?
一页纸 2.34 MB,满页是字
机器却抽出 0 个字
PDF · 文字层 · 表格串行 · 30 秒探针
陪你练个AI小号
5 PARTS + 写在最后
PART 01
抽出 0 个字
那份告家长书
PART 02
先排假警报
工具读不出不等于没有
PART 03
扫描件
页数没变字全没
PART 04
表格这半坑
行列关系断了
PART 05
三件事
今晚就能做
PART ///
写在最后
别把力气担心错方向
群里发来一份 PDF,你顺手转给 AI,让它总结。
它回得又快又顺,一二三四列得很整齐。
你很难想到,它可能一个字都没看到。
我给学校做系统,学校发来的通知、规定、菜单,常年堆在电脑里。
今天我把能翻出来的文件抽了一遍文本层。
一共 4 份,其中一份是我自己拼出来的假扫描件。
每份都用两个不同的程序各抽一次。
结论有点反常识,但每一步你都能自己复现。
01
PART
满页都是字的那一页,机器抽出 0 个字
A FULL PAGE THAT READS AS EMPTY
最极端的是那份教育主管部门转发给学校的告家长书,讲学校午餐的。
1 页纸,2.34 MB。
按 100dpi 渲染出来,页面上 19.27% 的像素是墨,一眼望去密密麻麻全是字。
程序从它的文本层里抽到 0 个字符。
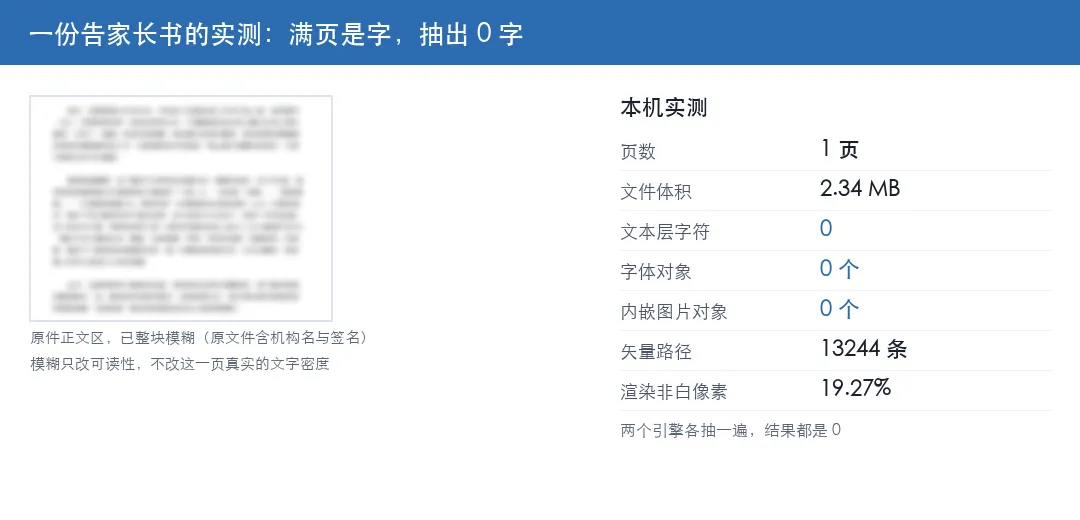
这份告家长书的正文区(已模糊)与本机实测的七项数字
我怕是自己用的程序不行,换了第二个引擎再抽一遍,还是 0。
再翻这份文件的内部对象:字体对象 0 个,内嵌图片 0 个,矢量路径 13244 条。
它纸上那些“字”,是一笔一笔描出来的曲线。
人眼看是字,机器看是一堆线条。
其余文件的情况,都在下面这张表里,全是今天跑出来的原始结果。
你眼睛看到的字,和机器能读到的字,在 PDF 里是两回事。
02
PART
先排掉一种假警报
ZERO HAS TWO CAUSES
“抽出 0 个字”有两个来源。
一个是文件里真没字,另一个是你的工具读不出来。
这两件事必须分开,不然我下面写的所有数字都可能是编的。
我差点在这上面栽一次。
上面那张表里的学校午餐表有 2 页,第 1 页抽出 1004 个字,第 2 页抽出 0 个字。
我第一反应是“第 2 页是张图片”。
往下查才发现,那页嵌着一种我用的程序读不了的字体,程序自己报了错,我把报错当成了空页。
踩坑提示 🕳
那份午餐表的第 2 页我最终没能复核通过,所以它没进任何一条结论。这篇文章里的每一个 0,都有第二个引擎或者内部对象清单作对照。
03
PART
扫描件更常见:页数没变,字全没了
SAME PAGES, ZERO WORDS
像告家长书那样把字描成曲线的文件不算多,常见的是扫描出来的 PDF。
我拿那份 11 页的学校规定做了个模拟。
做法是把每一页存成图片,再拼回一个 PDF。
拼完页数还是 11 页,看上去跟原来一模一样。
文本层从 10187 个字掉到 0 个字,体积从 0.24MB 涨到 1.61MB。
手机扫描 App 给你的文件,内部结构就是这样。
有些扫描 App 会额外补一层识别出来的文字,补得好就能读,补得差就是一堆错字。
这一层的效果我没测,各家差别大,你拿自己那份文件试一次就知道。
04
PART
文字层没问题,表格还有另一半坑
THE TABLE FALLS APART
那份午餐表的第 1 页里,有 1 张 24 行 8 列的表。
表头依次是日期、星期、主食、主菜、副菜一、时蔬、汤品、附餐。
按表格结构重建出来的第一行数据是:10/1、四、糙米飯、椰奶咖哩雞、芝麻海結、時蔬、綠豆粉角湯、豆漿。
你要是直接全选复制,拿到的是另一个样子。
“糙米飯”在文本流的第 36 个字符。
跟它同一行的那个日期“10/1”,在第 707 个字符。
中间隔着 670 个字符,全是别的菜。
日期自己那一串也乱了序,从第 651 个字符往后依次是 10/28、10/27、10/28、10/29。
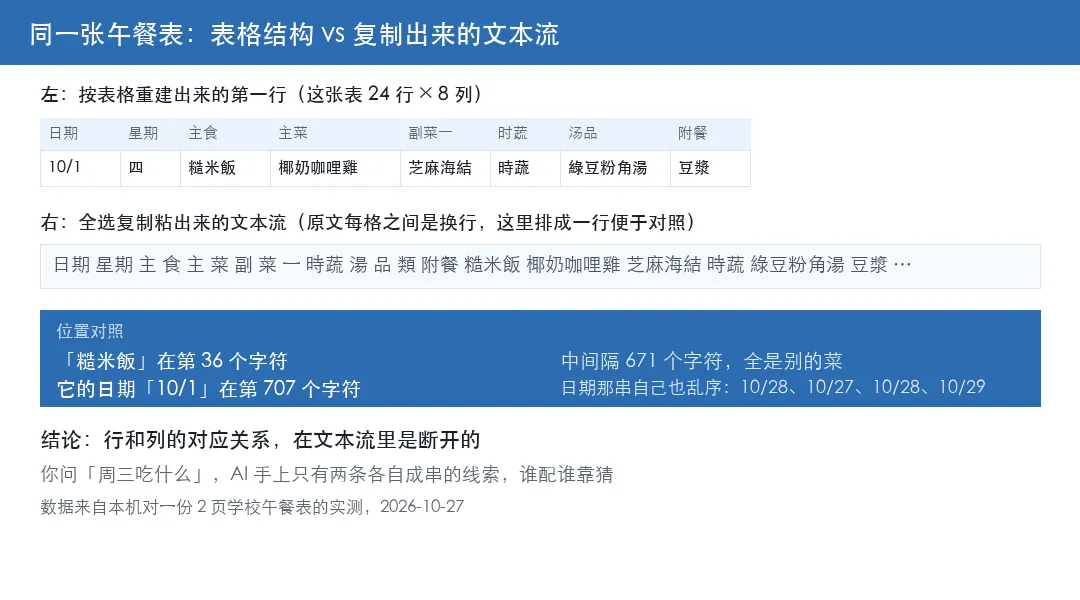
同一张午餐表:按表格重建出来的一行,与复制得到的文本流
表格在 PDF 里是一张网,抽成文本就是一条线。
这句只是帮你记住结果,实际乱到什么程度,取决于那份文件当初怎么排版的。
于是你问 AI“周三孩子吃什么”,它手上只有两条各自成串的线索,谁配谁得靠猜。
猜对了你看不出来,猜错了你也看不出来。
这是数据侧的事实。
具体某款 AI 会答成什么样,我没测,你试一次就有答案。
05
PART
你今晚就能做的三件事
THREE CHECKS TONIGHT
传之前,10 秒
在 PDF 里选中一段文字,复制到聊天框或者备忘录。
粘出来是空的,或者是一堆乱码,这份文件对机器就是空的。
再加一道保险,用查找功能搜一个你眼睛看得见的词,Mac 上按 Cmd+F,Windows 上按 Ctrl+F。
搜不到,基本就没有文字层。
说明一下边界:我是用程序抽文本层测的,没有替你点复制键。这两条路读的是同一层东西,你在手机上试,结果应该和我一致。
传之后,30 秒探针
问它一个只有最后几页才写的具体细节。
我这份 11 页规定里,“三十九”这一条只出现在第 11 页,“退休”这个词全文只在这一页出现 5 次。
这种问题它答得干脆、还给得出页码,才说明它真读到了底。
答得含糊或者绕开细节,就是没读到底。
PROMPT这份文件第 11 页写了什么?请引用原文并标页码。
表格类文件,别要总结,要重排
让它按“日期:主食、主菜、汤品”这种一行一天的格式输出。
你抽查其中两天,跟原文件对一下格子。
对上了,再信它后面那段总结。
///
LAST
写在最后
WHERE THE RISK ACTUALLY IS
顺手算一笔账,免得你把力气担心错了方向。
我测的这份 11 页规定是 10187 字。
汉字折成 token 要看各家分词器,按一个字 1 到 2 个 token 粗估,也就 1 万到 2 万 token。这只是估算,不是通用换算,实际数字受分词器和中英混排影响。
Kimi 的 API 文档 10 月 27 日写着,K3 系列上下文窗口 1,048,576 tokens,K2 系列 262,144 tokens。
这是接口侧的口径。
App 端上传文件的具体上限我没测,那要登录,我没动你的账号。
几十万字它装得下。
可那份 2.34MB 的告家长书,它拿到的是 0 个字。
你担心的“读不完”是小头,“根本没进去”才是大头。
这一篇的数字从哪来
表格里 4 行数据的页数、体积、文本层字符数、字体与图片对象数:2026-10-27 在我这台 Mac 上实测,每份都用两个不同的解析引擎各抽一遍。
两个引擎对「这一页到底有没有字」的结论一致;字符数会略有差别,那份 11 页规定一个数出 10187,另一个数出 10339。文中字符数取的是前一个引擎的结果。
模拟扫描件:我把那份 11 页规定逐页存成图片后重新拼成 PDF,用的是 120dpi、JPEG 质量 70。
上下文窗口:Kimi 开放平台文档 2026-10-27 当日页面原文。文件样本来自公开发布的学校与主管部门页面,机构名与签名未收入文中。
上面这些原始数据和三步自查,我存成了一张清单图。
后台回「PDF」,我发你。