ARTICLE · 1352968
DSH 记忆插件 * 免费 Embedding 模型:让项目拥有长期记忆
用 AI 连续做项目,有个麻烦很容易在第二天出现:代码还在,昨天聊好的项目约定却不一定能跟进新会话。
你可能遇到过这样的场景:昨天已经说好用 Python 标准库、命令行工具要保留表头、重复数据按邮箱判断,今天开一个新会话,它虽然能读懂已有代码,却可能顺手引入第三方库,或者重新设计已经确认过的去重规则。它并不是能力不够,对它来说,昨天那段聊天已经不在眼前了。
面向 DeepSeek Harness 的社区插件 dsh-hindsight-memory,想补上的就是这段断开的上下文。它会把对话中的项目约定整理进本地记忆库,并在下一次任务开始前找回少量相关内容。由于这个案例较为简单,记忆检索我们选择使用硅基流动的免费模型 BAAI/bge-m3,主任务和记忆整理所需的语言模型也接入硅基流动。
当然,如果项目比较大,或者要把这套方法搬到企业知识、客户方案、复杂代码库等不能轻易出错的场景,可以考虑更强的 Embedding 模型比如Qwen/Qwen3-Embedding-8B ,在语义对齐和检索稳定性上通常会比 BGE-M3 更好。
现在,我们让 DSH 写一个 CSV 清洗工具,并在三个独立会话中把它做完。
分清三件事:谁写代码,谁整理,谁负责想起来
一条长期记忆链路里,模型并不只出现一次。
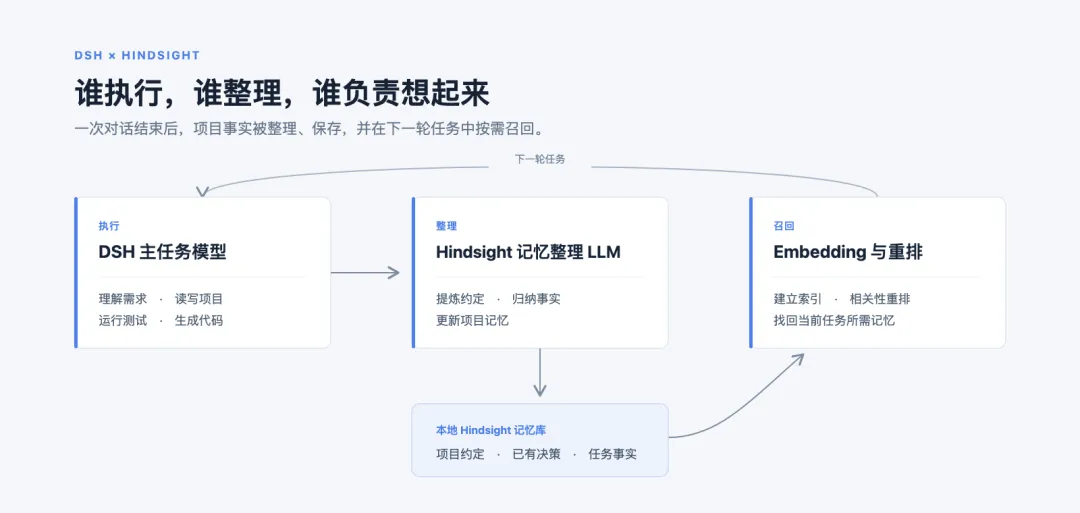
dsh-hindsight-memory 插件会在每轮对话后把内容写入本地 Hindsight;后台通过 DeepSeek v4.1 flash 等语言模型将对话整理为事实,再用 Embedding 模型 BGE-M3 建索引。
下一轮提问时,它只取回相关记忆作为背景,而不是把所有历史对话再塞给模型。它也按工作区绑定记忆库:同一项目可以连续,两个项目默认不应串台。
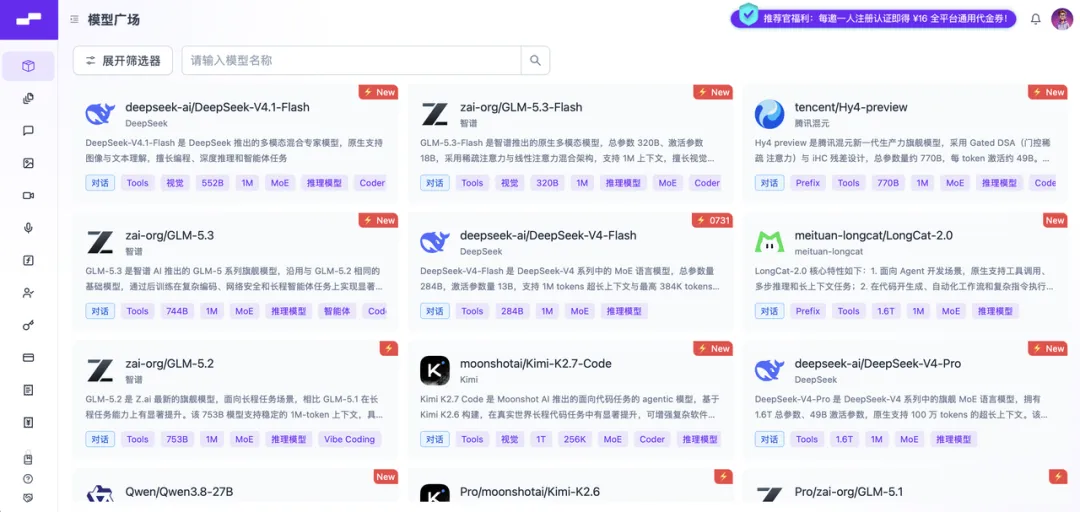
第一步:先把硅基流动接进 DSH
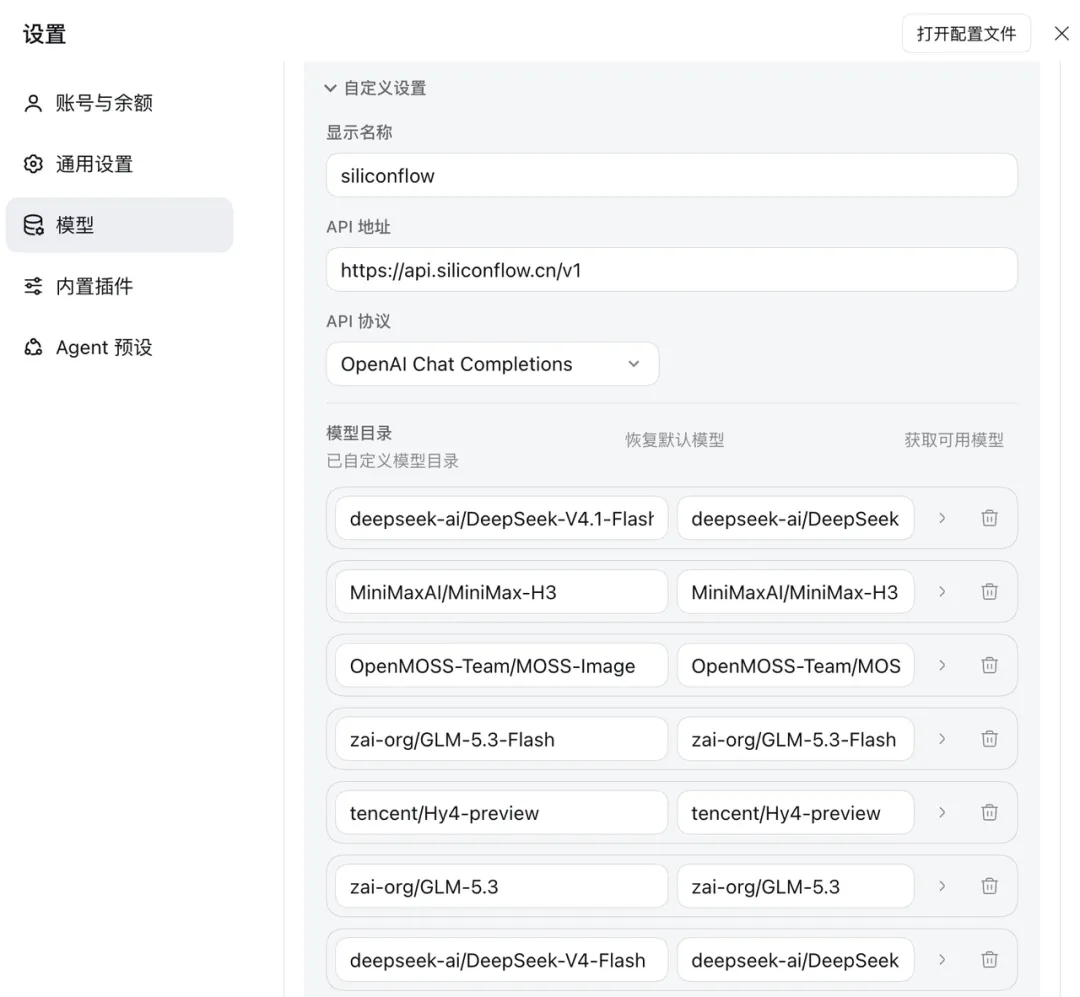
打开 DSH Web UI,进入「设置 → 模型」,选择「添加模型提供商」,再切换到「自定义模型 API」,填入以下内容
第二步:安装插件(两种方式选一种)
在 DSH 左侧打开「Plugins」,点击「+ Add plugin」
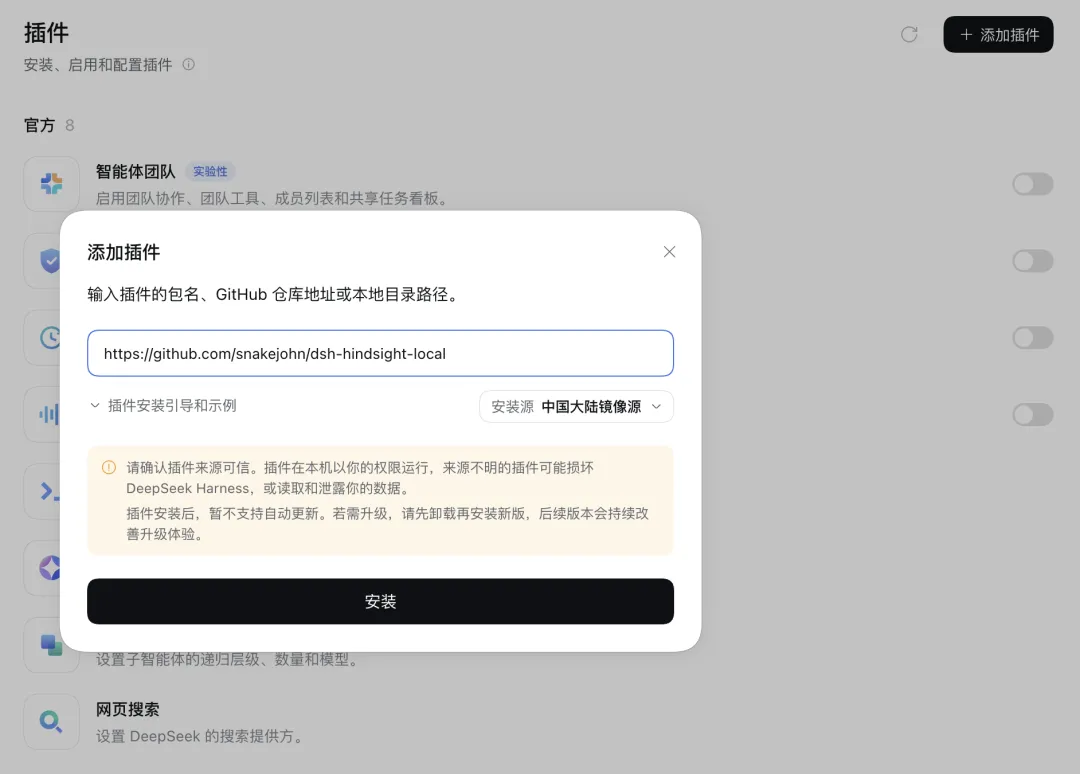
方式 A:从 GitHub 安装(推荐,最省事)
在弹出的框里粘贴下面这个地址,点「安装」:
https://github.com/snakejohn/dsh-hindsight-local方式 B:下载 zip,从本地文件夹安装(网络连不上 GitHub时用)
1. 下载最新版本里的 dsh-hindsight-local-v版本号.zip(如dsh-hindsight-local-v0.1.4.zip):https://github.com/snakejohn/dsh-hindsight-local/releases2. 右键→「全部解压缩」,记住解压出来的文件夹在哪(比如“下载”文件夹里)。 3. 在「Add plugin」框中填写该文件夹的完整路径,点「Install」。
安装完成后,在已安装插件中确认 dsh-hindsight-memory 已启用。首次配置时选择“还没有 Hindsight”,插件会在本机准备所需环境和服务;第一次等待几分钟是正常的。左下角状态卡出现“记忆正常”后,再开始做项目。
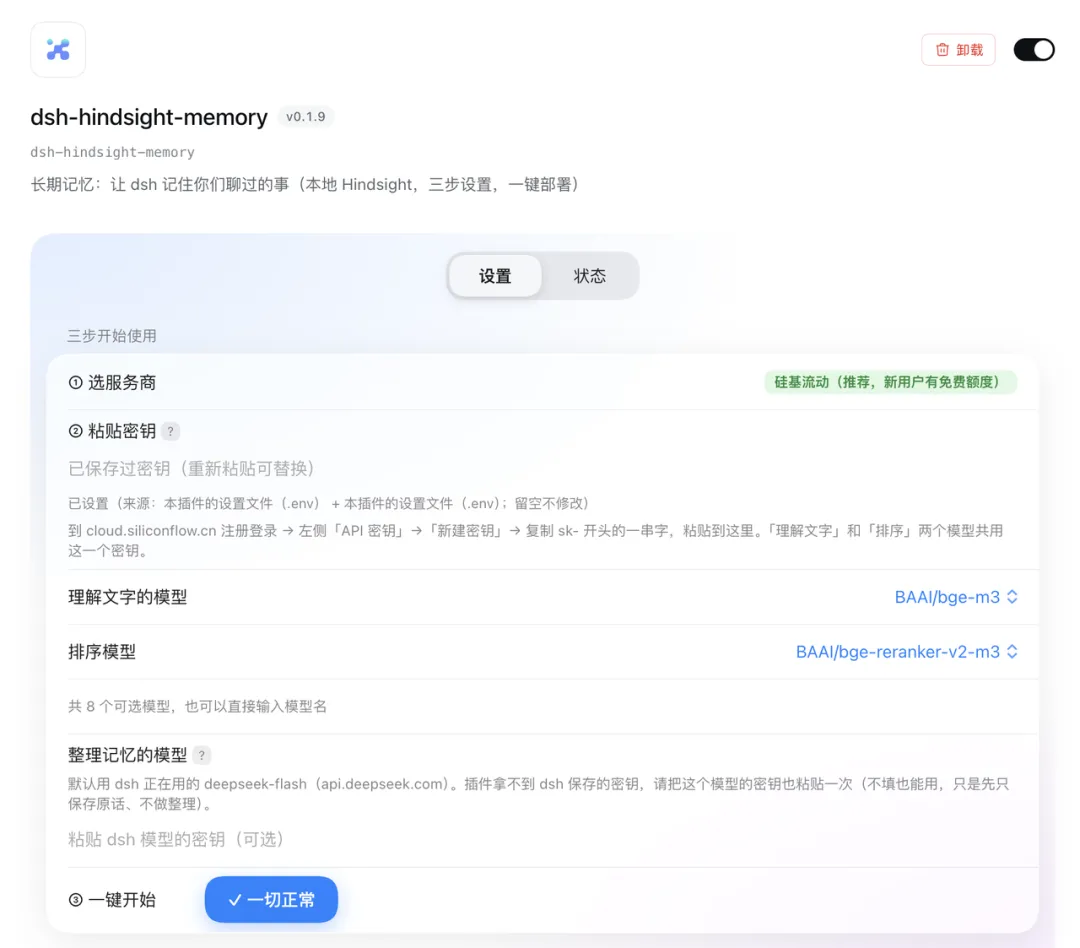
插件的快速配置会要求填硅基流动密钥,并为理解文字和排序选择模型。这里保持 BAAI/bge-m3 的 1024 维 Embedding 设置即可;重排模型可保持插件默认。进入「高级设置」,找到“整理记忆的模型”,把它改为“自定义 → 硅基流动”,选择模型。记忆整理也可以使用与 DSH 主任务相同的语言模型,这里都选择 DeepSeek-V4.1-Flash。
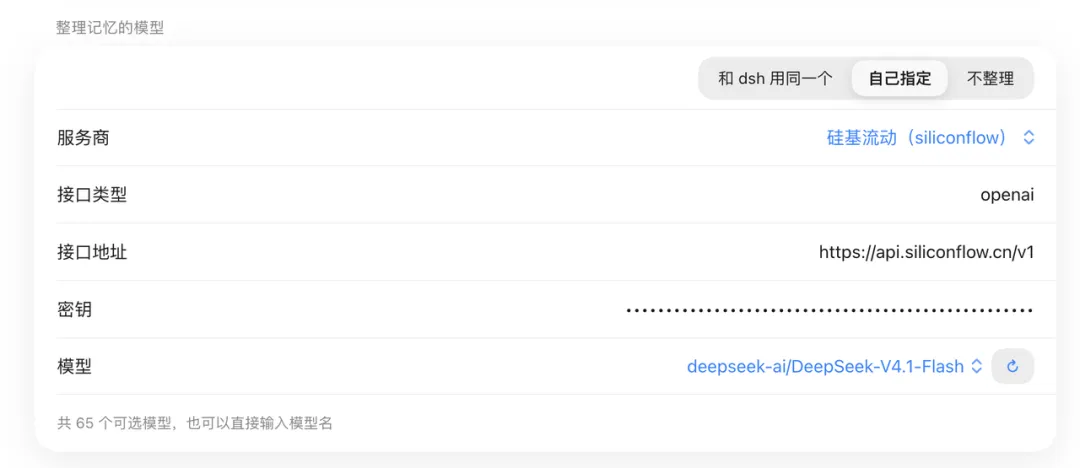
前台模型负责写代码,后台模型负责整理项目约定,Embedding 和 Reranker 则像资料管理员,在下一次任务开始前找回相关记忆。
默认情况下,插件会记住用户消息和 AI 回复;工具调用、思考过程和系统提示默认不写入。确认“聊天时自动回忆”和“自动记住对话”都打开。
把一个 CSV 清洗工具做成能跨会话继续的项目
我们把任务拆成三次会话:第一次只定规则,第二次在新会话里实现,第三次再追加需求。每次都在同一个工作区内进行,也不要归档前面的对话;归档对话默认不会被插件写入记忆。
第一次会话:先把“不能忘的规矩”说清楚
新建一个空目录,例如 csv-cleaner-demo,在 DSH 中打开它。然后发送下面这段需求:
我们要做一个 Python CSV 清洗小工具。请先不要写代码,先确认并记住这些项目约定:使用 Python 3.11,只能用标准库;命令格式为
python -m csv_cleaner input.csv output.csv;保留原表头;删除整行为空的记录;去掉每个单元格前后的空格;邮箱列按小写后去重,保留首次出现的记录;输入文件缺少邮箱列时要给出清楚的报错。请给出实现计划和测试计划,等我确认后再写代码。
这段话刻意没有让 AI 立刻输出一大段代码。先让它复述约定和计划,能减少误解,也让记忆整理模型有一份结构清楚的材料可以处理。
等它给出计划后,再补一句:
计划确认。请把这些约定视为当前工作区的项目规则,后续实现和测试都遵守它。
这时可以查看插件状态卡,或点击“现在就记住”,让第一次会话的内容尽快进入处理队列。
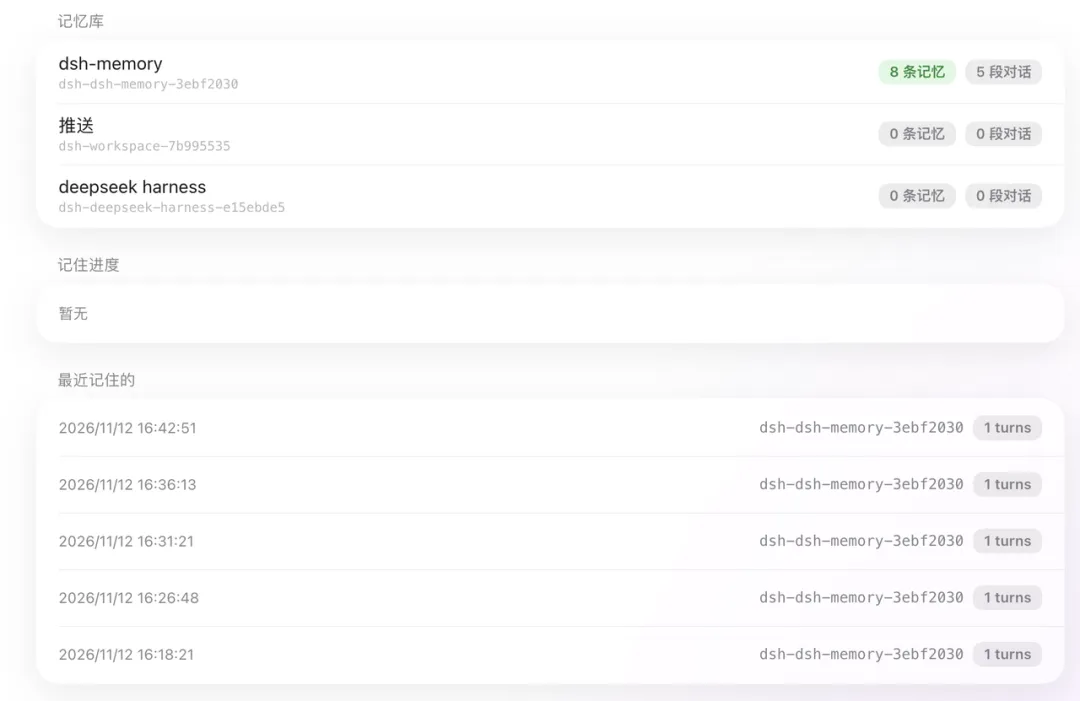
第二次会话:不重复上一轮需求,看它能否接着做
关闭或新建一个会话,仍然留在 csv-cleaner-demo 工作区。不要复制上一轮需求,只发送:
继续昨天的 CSV 清洗工具。请先告诉我你记得哪些项目约定;确认后实现它,并为核心逻辑写测试。运行测试后再汇报结果。
理想情况下,它应该能复述出 Python 3.11、标准库、命令格式、表头处理、邮箱去重等既有约定。
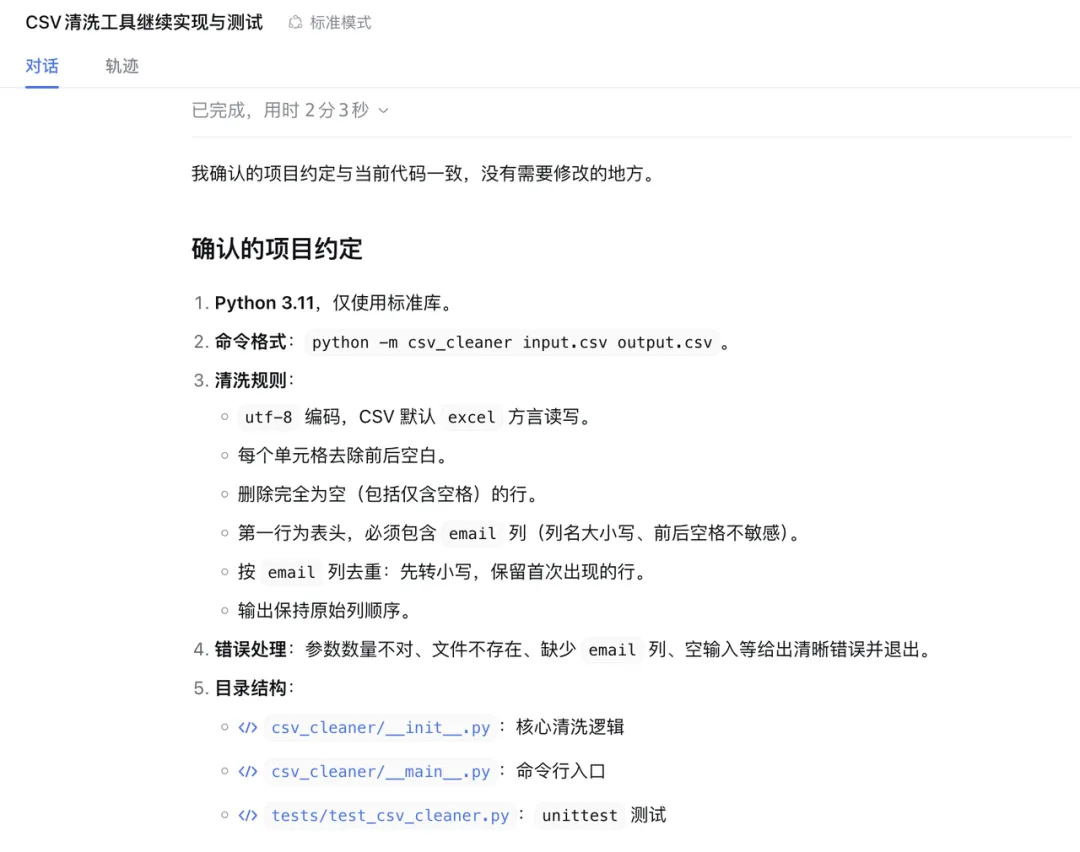
确认它复述正确后,才让它创建 csv_cleaner 包、入口文件和测试。一个符合约定的最小项目可以长成这样:
csv-cleaner-demo/├── csv_cleaner/│ ├── __init__.py│ └── __main__.py├── tests/│ └── test_cleaner.py└── sample.csv它的测试至少覆盖四件事:清除空行和首尾空格、邮箱大小写去重、保留表头、缺少邮箱列时的报错。重点是 DSH 生成的代码与测试,能不能把第一次约定变成可运行的行为。
第三次会话:需求变化后,它能否更新既有约定?
第三次会话仍在相同工作区内,新建对话后发送:
增加一项新需求:除了清洗后的 CSV,再输出一个 JSON 格式的统计文件,至少包括原始数据行数、输出行数、删除的空行数和去重的记录数。仍然只能使用标准库,原有命令行用法不能变。请先说明这项修改和既有约定是否冲突,再修改代码和测试。
好的回答不会把昨天的规则一把推倒重来。它会保留现有命令格式与 CSV 输出,再为统计文件增加一个合理参数或固定的同目录输出规则,并把这个决定写进测试。你也可以追问:“如果输入没有邮箱列,统计文件是否还会生成?”这能检查它是否把已有错误处理一路带到了新需求里。
到这里,长期记忆的价值才比较清楚:新会话能够继续遵守已经确认的约定,也能在需求变化后补充新的决定。
下一次,不必重新交代项目从哪里开始
一个能继续项目的 AI,不需要把每个字都记下来。它更应该记住那些会影响下一步工作的东西:技术限制、输入输出、已经做过的决定、失败过的尝试,以及刚刚发生的需求变化。
这正是 DSH、Hindsight 和硅基流动平台的 DeepSeek、BGE-M3 模型在这个案例里的分工。DSH 负责把模型和工具放进工作区,Hindsight 负责给下一次任务送来恰当的上下文,DeepSeek 语言模型负责理解、实现与整理;免费 BGE-M3 则留在检索位置,让“昨天的项目”能被找回来。
小工具做完以后,可以把同一套方法移到脚本重构、内部数据处理或个人自动化项目上。
更多硅基流动使用场景与应用案例:
https://docs.siliconflow.cn/
近期更新
硅基流动上线GLM-5.3-Flash