ARTICLE · 1356281
下一个超级 App 只属于你一个人——DeepSeek 开放三部曲与客户端架构拆解
2026 年 11 月 13 日晚,DeepSeek 开放全家桶应用 API,并开源了一个能 1:1 复刻官方 App 的聊天 Demo。很多人只看到了「又能套壳了」,但如果把时间线拉长三个月,你会发现这是一条极其清晰的路线图:插件化 → 接口开放 → 客户端开放 → 自主代理(Super-agent)。这篇文章把这条线拆开讲清楚,并附上客户端架构拆解与一份可以直接上手的手搓指南。
1. 一、先看时间线:这不是三次孤立发布
把 DeepSeek 近三个月的动作排在一起,逻辑立刻就清楚了。
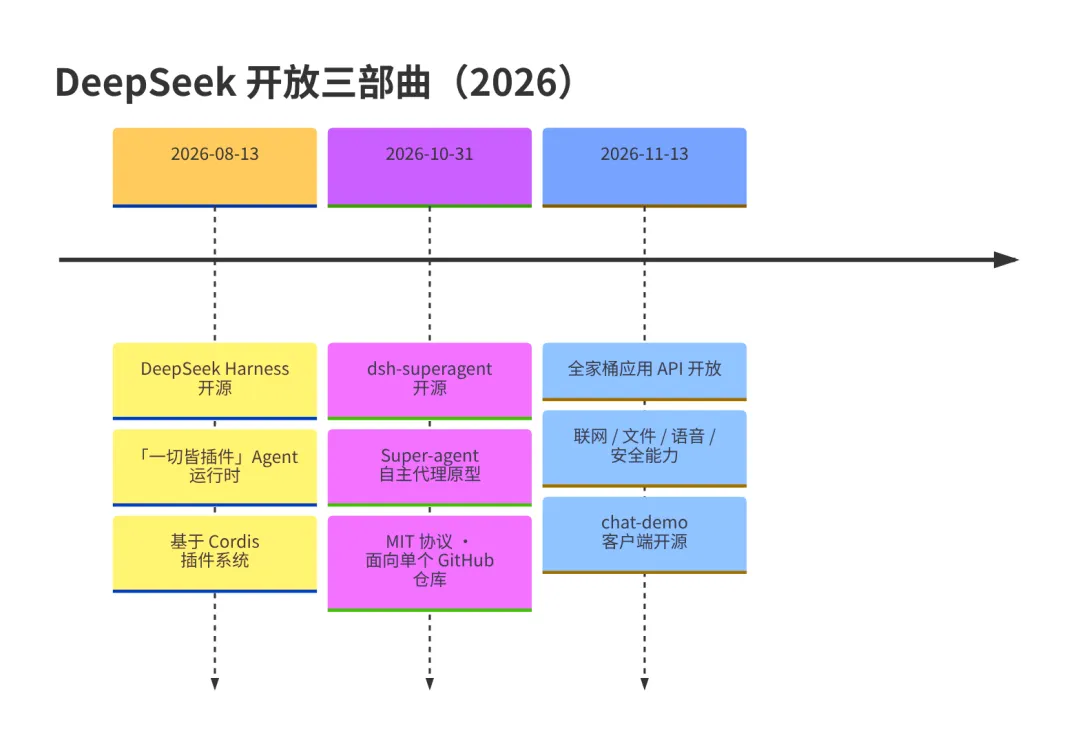
2026-08-13 · 插件化:开源 DeepSeek Harness(dsh),一个「一切皆插件」的 Agent 运行时。它把「模型之外的一切」——上下文调度、工具管理、任务状态——都做成可插拔的插件,底层由 Cordis 插件系统驱动。 2026-10-31 · 自主化:开源 dsh-superagent(Super-agent 原型,MIT 协议)。这是一个面向单个 GitHub 仓库的「主动式编码代理」,监听 GitHub / 飞书,自己开工、自己提 PR、只在需要人时才说话。 2026-11-13 · 接口 + 客户端开放:开放全家桶应用 API(联网搜索、深度思考搜索、文件解析、链接阅读、语音、安全),并开源 chat-demo 客户端,官方手把手教你复刻自己的 DeepSeek App。
三步连起来看,DeepSeek 做的不是「开放几个接口」,而是把自家产品从里到外整个拆开放出去:先开放运行时(Harness),再开放自主代理(Super-agent),最后开放能力接口(全家桶 API)和产品外壳(chat-demo)。
2. 二、第一层:接口开放——全家桶 API 分类说明
这次开放的核心,是把原本「锁在官方 App 里」的能力,变成开发者可以直接调用的 API。按调用方式可以分成四类。
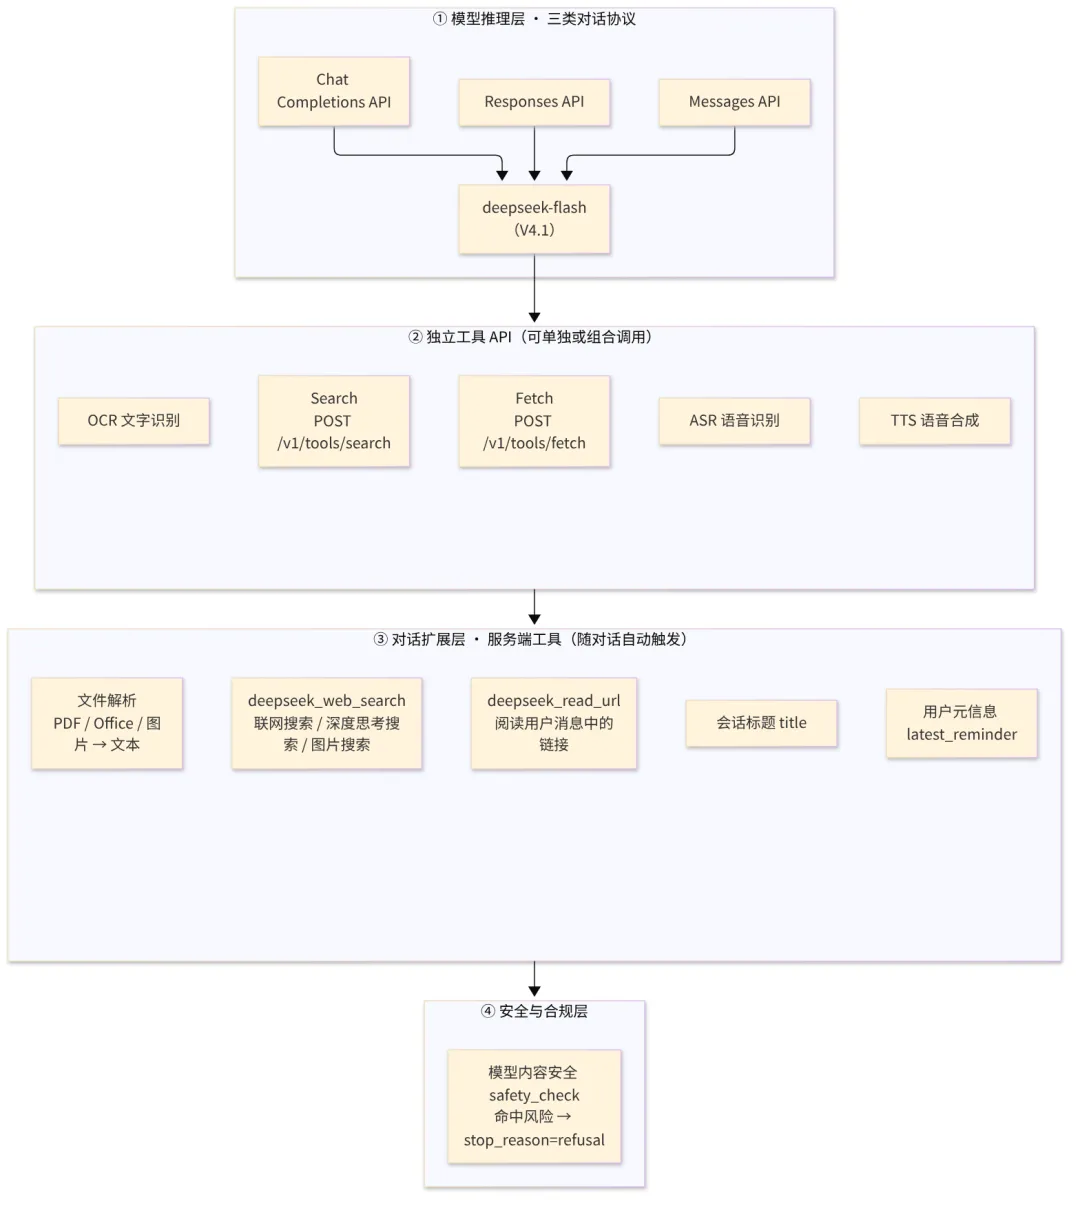
2.1 1. 模型推理层:三类对话协议
deepseek-flash(V4.1)在 Messages、Responses、Chat Completions 三类接口中都支持扩展能力。其中 Messages API 走 Anthropic 兼容协议(base_url = https://api.deepseek.com/anthropic),这意味着你可以用 Anthropic SDK、甚至把 Claude Code / Claude Desktop 的 base_url 一改就接上 DeepSeek。
2.2 2. 对话扩展层:服务端工具(随对话自动触发)
这是最「魔法」的一层。开发者只需在 tools 里声明服务端工具,是否调用、何时调用完全由模型自己判断,搜索和抓取都在 DeepSeek 服务端完成,客户端不需要执行任何工具:
deepseek_web_search,关闭思考 | ||
deepseek_web_search,开启思考 | ||
deepseek_read_url | ||
document 块 | ||
title: {"enabled": true} | ||
latest_reminder |
2.3 3. 独立工具 API:可单独或组合调用
如果你不想让模型「自己决定」,而是想在自己的流程里精确调用,DeepSeek 把底层能力单独开了出来:
POST /v1/tools/search | ||
POST /v1/tools/fetch | ||
这些可以单独调用,也可以自由组合。官方给的例子很直白:学习应用用 OCR 识别试卷再让模型讲题;语音助手用 ASR 转文字、模型理解、TTS 播报。
2.4 4. 安全与合规层
safety_check: {"level": "high"} 开启输入输出风险审核,命中风险时以 stop_reason: "refusal" 拒答。官方明确提醒:对外提供服务的应用应开启安全校验,并履行内容安全审核、大模型登记、AI 标识等义务。
2.5 定价:能力是「按次」卖的
注意计费细节:联网搜索按「查询词条数」计费(一次调用含 3 个 query 算 3 次),抓取按成功抓取的网页数计费。工具费用与模型 Token 费用是叠加的。
3. 三、第二层:客户端开放——拆解 DS 客户端架构
为了证明「新 API 真的能复刻官方 App」,DeepSeek 直接开源了 chat-demo。拆它的源码结构,就等于拆 DeepSeek 官方客户端的架构。
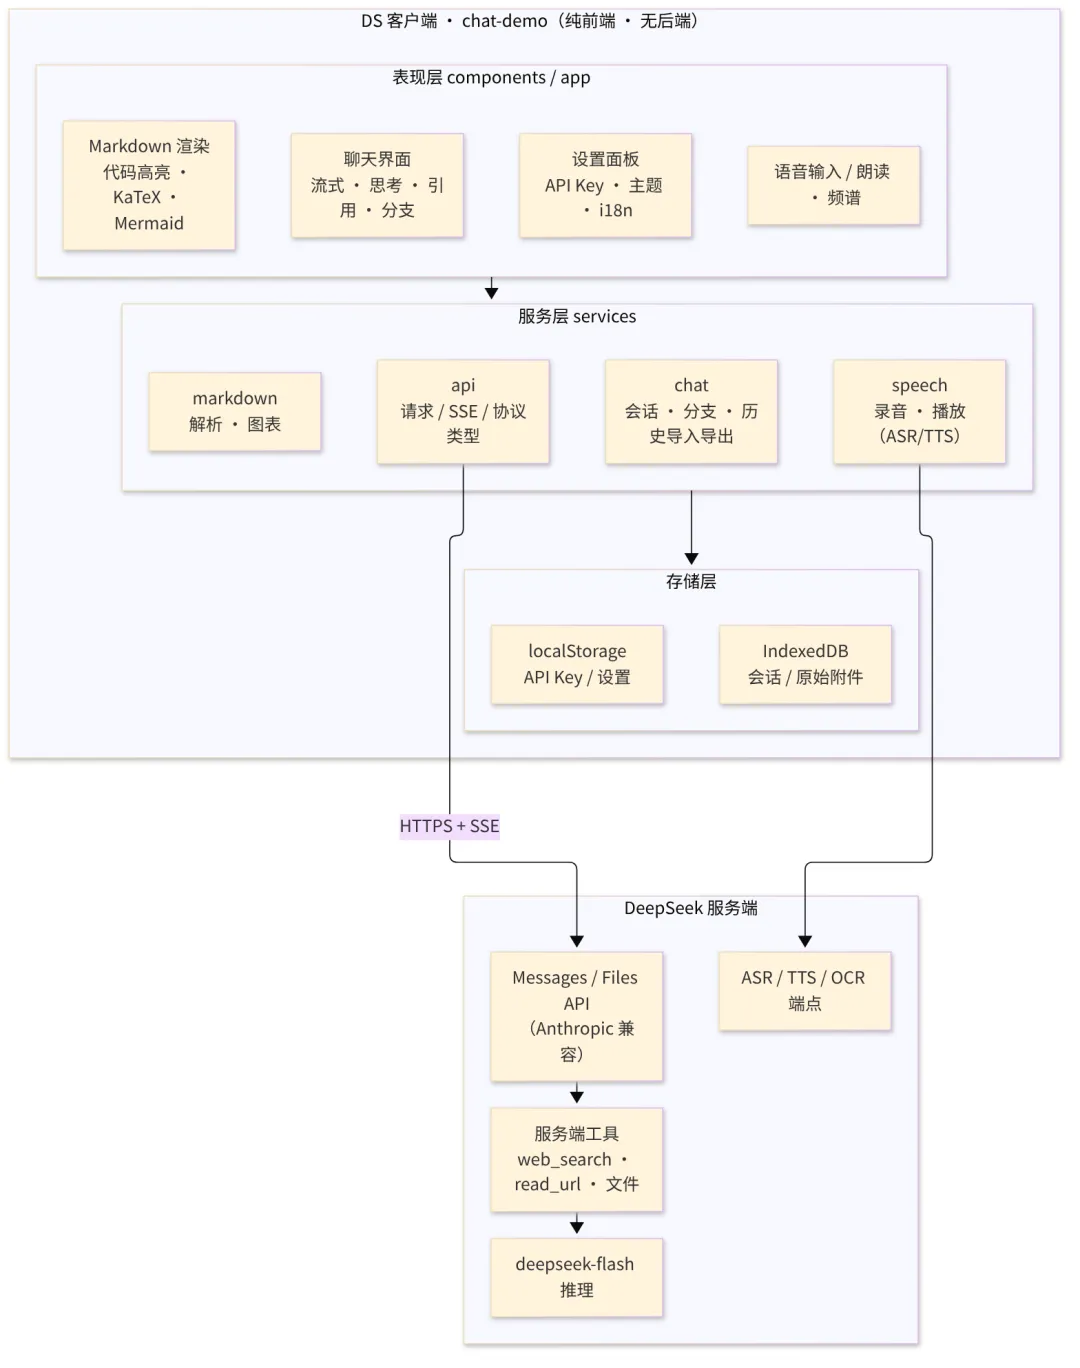
3.1 架构拆解
① 纯前端、无后端。 这是最关键的设计决策。浏览器直连 API 服务,没有自己的应用后端。API Key 和设置存 localStorage,会话和原始附件存 IndexedDB。这意味着「复刻 DeepSeek App」的边际成本几乎为零——一个静态站点就够了。
② 表现层(components / app)。 聊天界面(流式、思考过程、引用角标、消息分支)、设置面板(Key、主题、中英 i18n)、Markdown 渲染(代码高亮、KaTeX 公式、Mermaid 图)、语音输入/朗读(带实时频谱)。
③ 服务层(services)。 四个子模块各司其职:
api:请求封装、SSE 流式解析、协议类型定义;chat:会话管理、消息分支、历史导入导出(ZIP 归档,可直接导入 DeepSeek 官方历史对话);markdown:解析与图表渲染;speech:录音与播放,对接 ASR / TTS 端点。
④ 接口层。 默认用 deepseek-flash,走 Anthropic 兼容的 Messages / Files API;语音走 ASR / TTS 端点;请求里带上 search、read_url、title、latest_reminder 等扩展。
3.2 一次对话的完整活动流
理解了静态结构,再看一次请求在系统里是怎么「动」起来的。
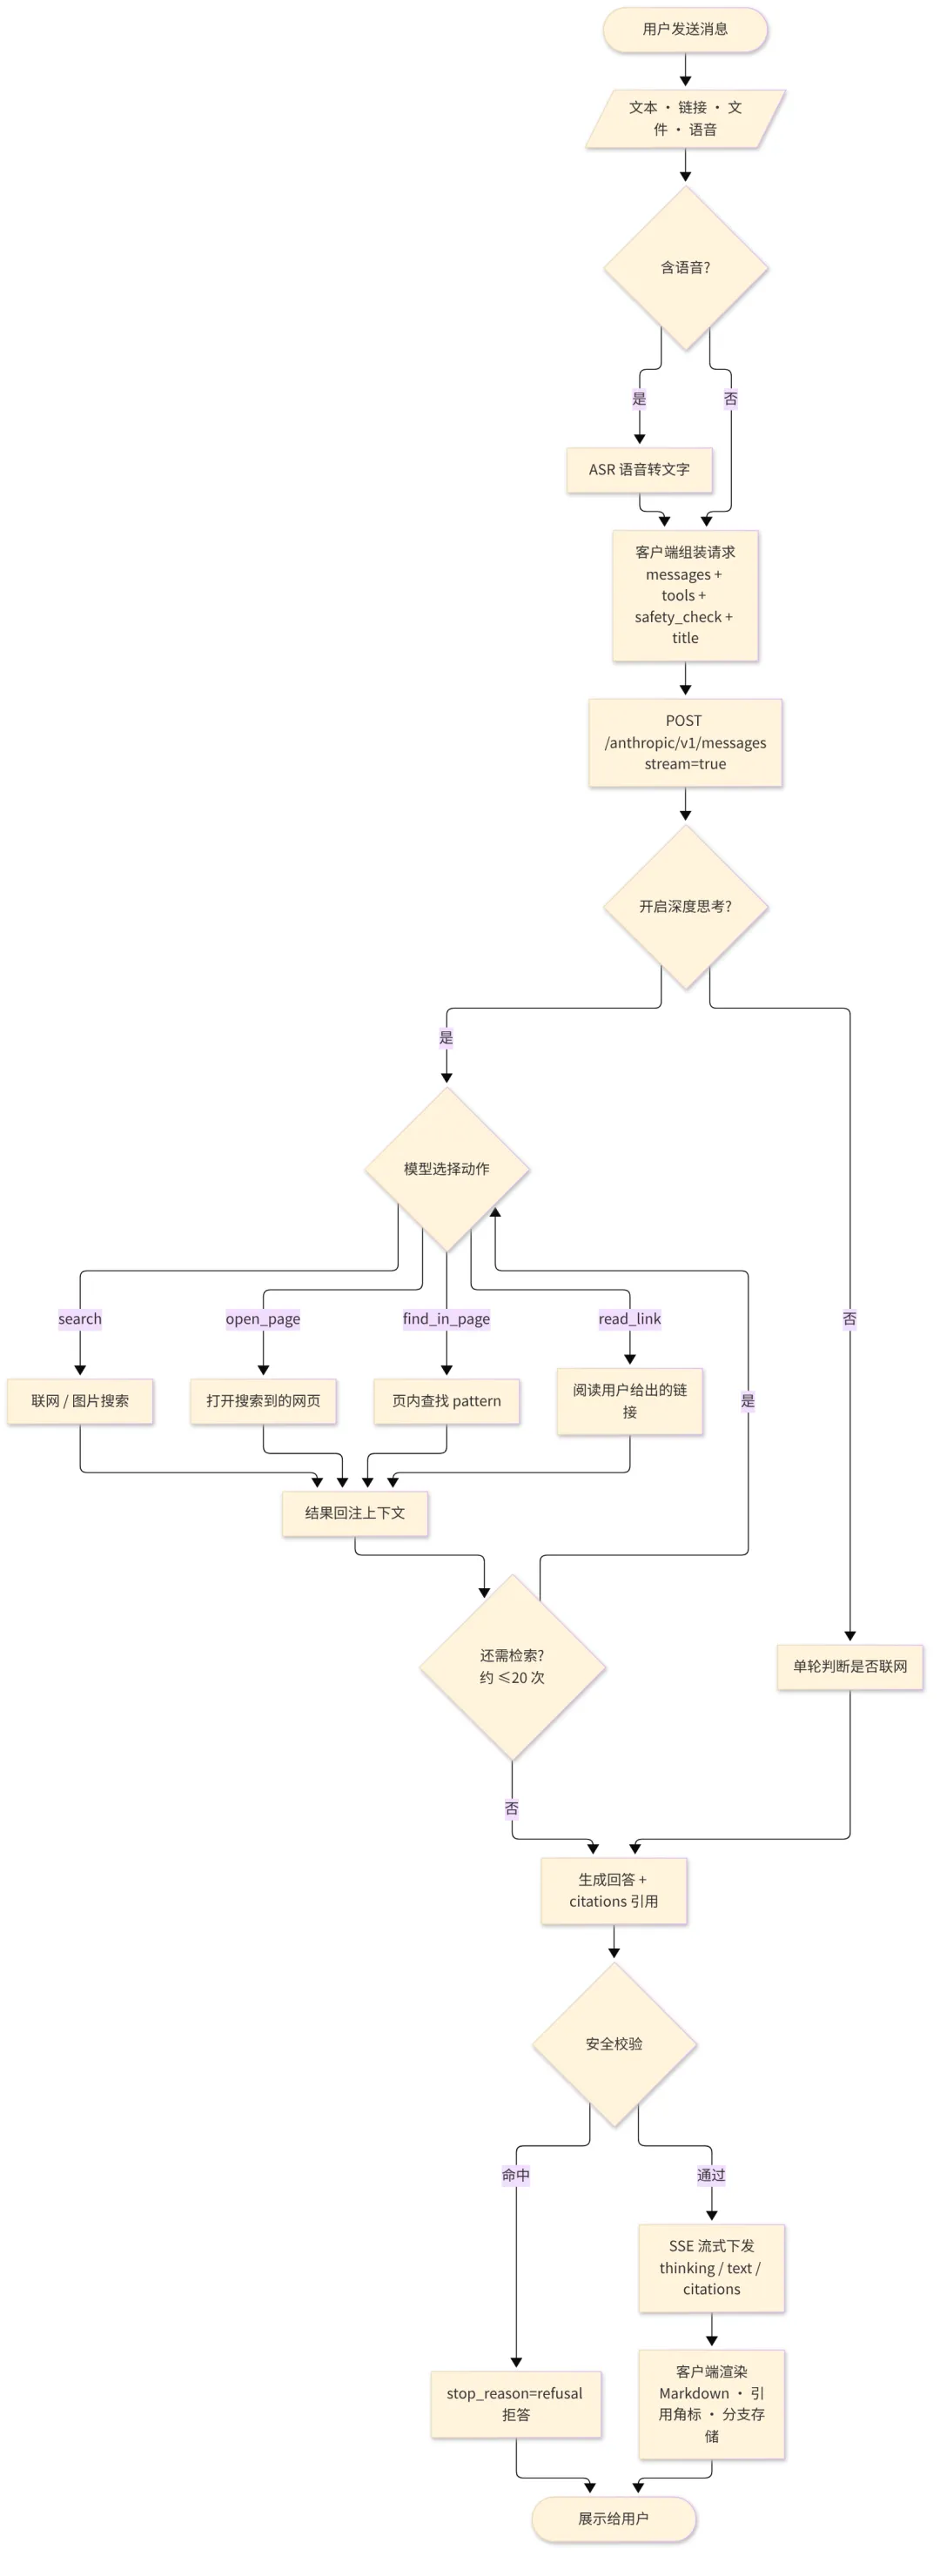
几个值得注意的设计点:
是否联网由模型判断,而非用户勾选。 客户端只负责声明工具, search / open_page / find_in_page / read_link这些动作都是模型在推理中自主发起的。深度思考搜索是一个循环。 模型在 thinking与工具调用之间反复横跳(最多约 20 次),把检索结果回注上下文后继续推理,直到信息足够才作答。引用是一等公民。 回答的 text块带citations,客户端据此渲染引用角标,这是「可信回答」的关键。多轮要原样回传。 带联网工具块的历史消息需保留 kind和signature回传,阅读过的网页靠signature还原进上下文。安全是硬闸门。 命中审核直接 refusal,客户端要能优雅处理拒答态。
4. 四、第三层:Super-agent——从「对话客户端」到「自主代理」
如果说 chat-demo 解决的是「人和模型对话」,那么 Super-agent 解决的是「模型替人干活」。它建立在 Harness 之上。
Harness 是「一切皆插件」的 Agent 运行时:包裹模型的运行时层,负责调度上下文(模型每轮看见什么)、管理工具(模型能碰什么)、维护任务状态(多轮之间记住什么),运行结构分为组合层、执行层、记录层,插件生命周期由 Cordis 管理。
dsh-superagent 则是跑在 Harness 上的一个「主动式编码代理」:监听 GitHub(Issue / PR / CI / 评论)和飞书,有人(或被规则允许)提出需求时,它自己开工、在自己的目录里干活、最后回到原会话交付(比如一个 PR)。
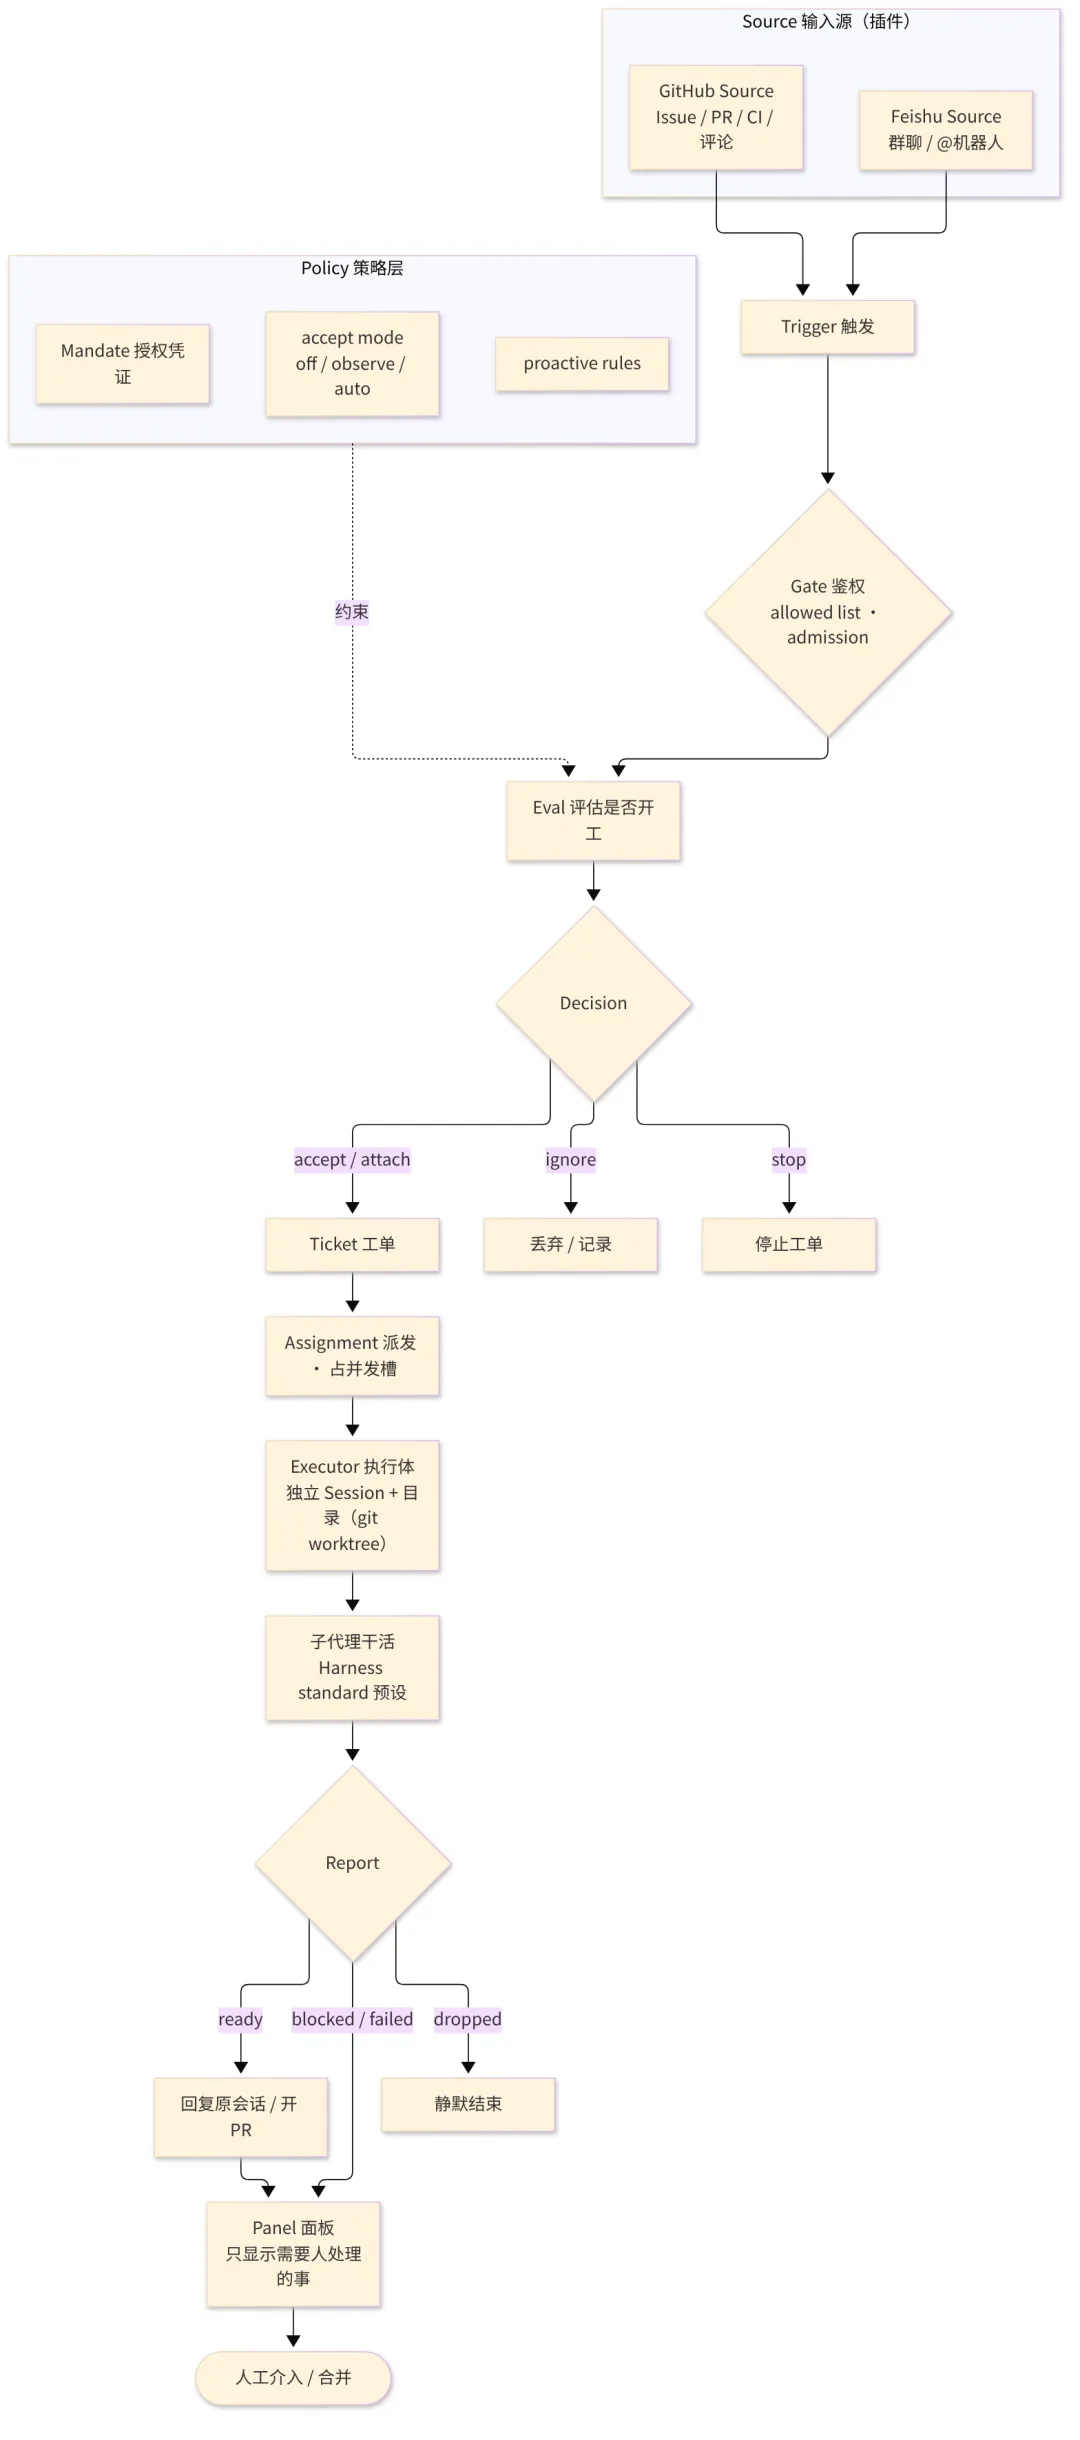
它的核心领域模型只有几个概念,却支撑起完整的自主闭环:
Source:输入源插件(GitHub / Feishu),负责「听见」外部世界; Trigger / Eval / Decision:触发 → 评估「该不该开工」→ 决策(accept / attach / ignore / stop); Policy / Mandate:策略层(白名单、admission 表、accept mode、proactive rules)与授权凭证,决定「谁能让它干活、能干到什么程度」; Ticket / Assignment / Executor:工单 → 派发 → 执行体(独立 Session + git worktree目录),子代理用 Harnessstandard预设干活;Report / Panel:执行体汇报(ready / blocked / failed / dropped),Panel 只显示「需要人处理」的事。
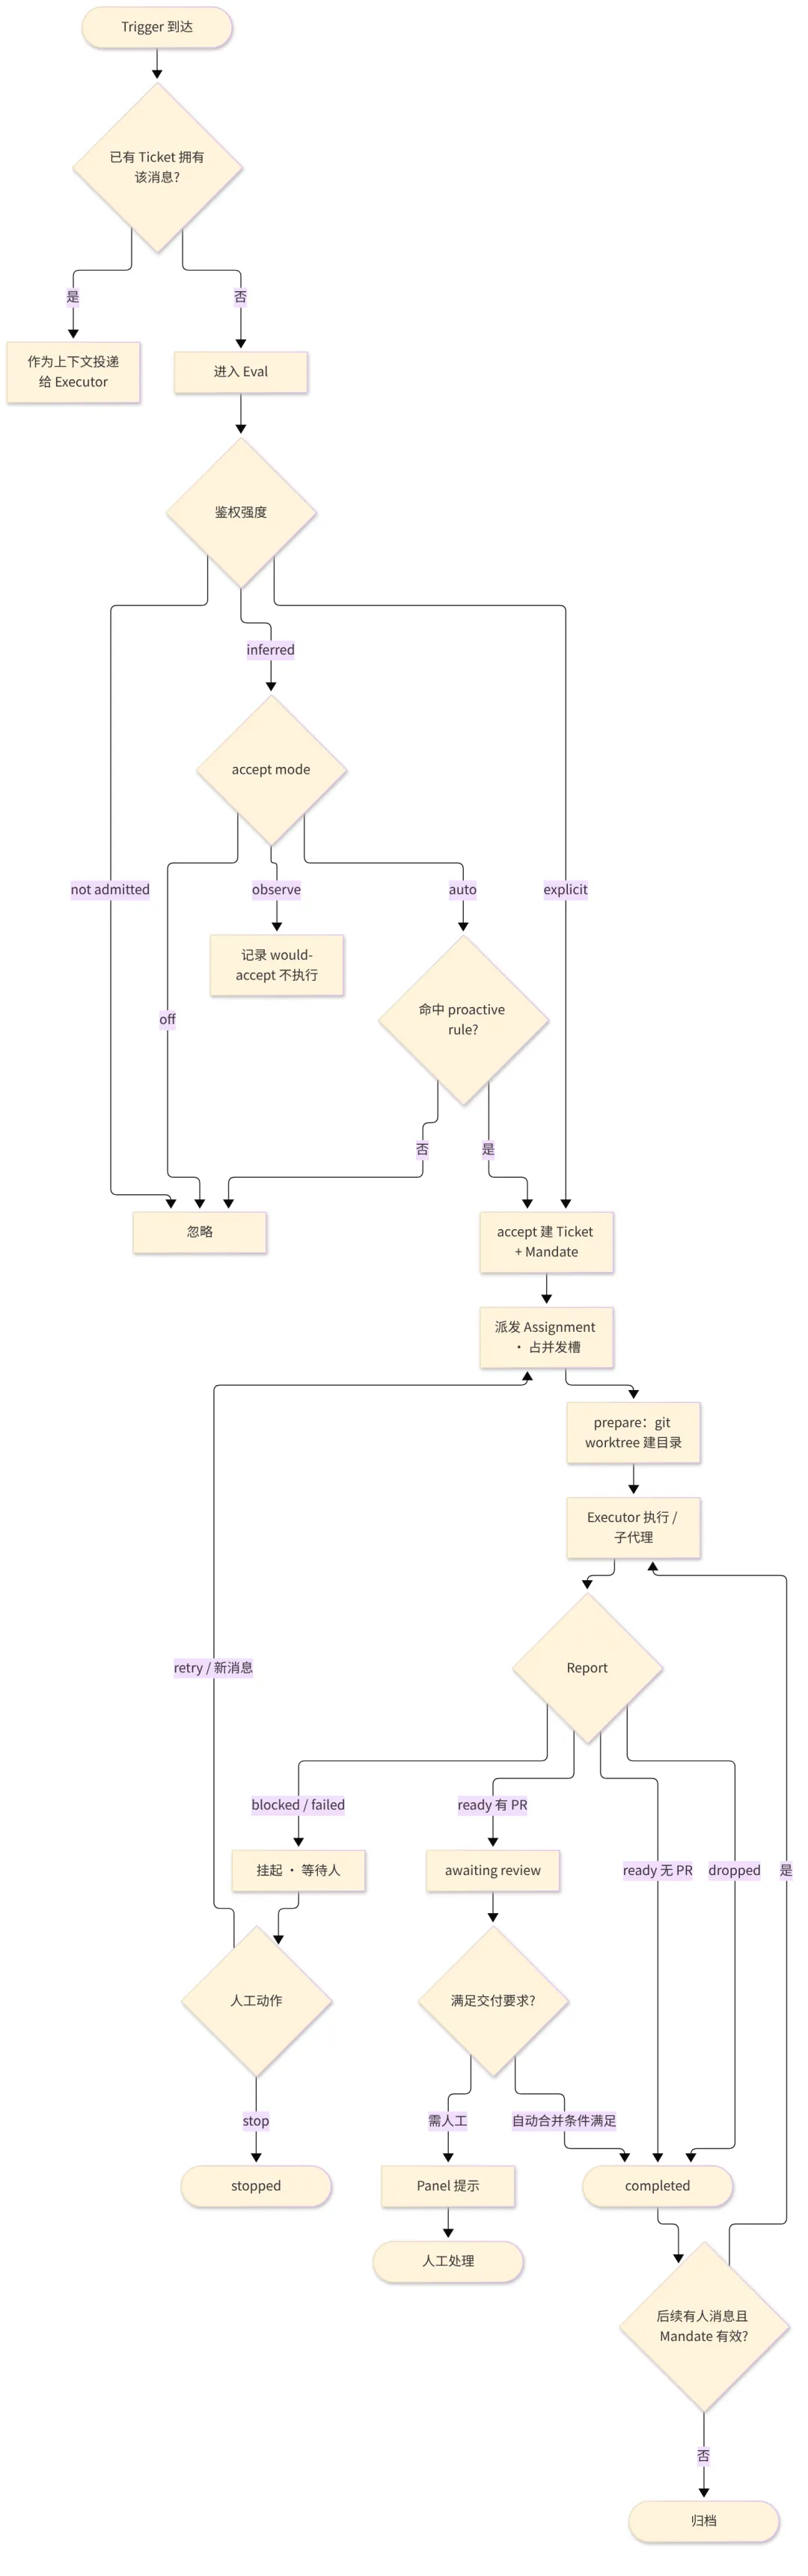
它的设计哲学只有一句话:「尽可能少地占用人的注意力,尽可能多地给出价值。」 所以它只在被请求或被规则允许时行动,只在「人必须行动」或「结果可用」时说话;accept mode 从 observe(只记录不执行)起步,确认靠谱后再切 auto。
5. 五、DeepSeek 的未来布局:把护城河从「App」换成「生态」
把三层放在一起,DeepSeek 的战略意图就浮出水面了。
1. 从「卖 Token」到「卖能力栈」。 过去大模型厂商的收入是 Token;现在 DeepSeek 把搜索、抓取、OCR、ASR、TTS 全部按次计价,模型之外长出了一整条「工具收入曲线」。开发者用得越深,工具调用越多,收入越稳。
2. 把官方 App 的护城河,变成开发者生态的护城河。 传统思路是把功能锁在自家 App 里留住用户;DeepSeek 反其道而行,主动降低「复刻官方体验」的难度,甚至提供开源示例。代价是官方 App 不再独特,收益是模型和工具服务进入成百上千个第三方产品,触达官方 App 之外的场景。
3. 押注 Agent 时代的「操作系统」。 Harness(运行时)+ Super-agent(自主代理)+ 全家桶 API(能力)+ chat-demo(外壳),合起来是一套完整的 Agent 基础设施。谁掌握了运行时和工具协议,谁就掌握了 Agent 时代的入口——这比守住一个聊天 App 重要得多。
4. 「下一个超级 App 只属于一个人。」 DeepSeek Harness 负责人崔添翼的这句话,是整条路线的注脚:
「下一个超级 App 不必是面向所有人的一个超级 App。现在,每个人都有能力创造一个超级 App。下一个超级 App 也可以是只属于你一个人的超级 App。」
过去互联网公司追求一个 App 服务十几亿人;当开发成本被 AI 和开放 API 打到接近零,未来可能是十几亿人各自拥有一个只为自己定制的 App。DeepSeek 这次开放,就是把这个未来的门槛又往下砸了一截。
6. 六、自己手搓指导:从零搭一个「自己的 DeepSeek」
下面是一条可以直接照做的路径,从一条 curl 到一个自主代理。
6.1 Step 0 · 准备
到 DeepSeek 开放平台申请 API Key,设为环境变量 DEEPSEEK_API_KEY。
6.2 Step 1 · 三条 curl 跑通「联网 + 深度思考」
Messages API(Anthropic 兼容),同时开启联网搜索、阅读链接、深度思考、安全校验和会话标题:
bashcurl https://api.deepseek.com/anthropic/v1/messages \ -H "Content-Type: application/json" \ -H "x-api-key: ${DEEPSEEK_API_KEY}" \ -d '{ "model": "deepseek-flash", "thinking": {"type": "enabled"}, "safety_check": {"level": "high"}, "title": {"enabled": true}, "tools": [ {"type": "deepseek_web_search", "name": "deepseek_web_search"}, {"type": "deepseek_read_url", "name": "deepseek_read_url"} ], "messages": [{"role": "user", "content": "DeepSeek V4.1 有哪些更新?"}], "stream": true }'响应里会出现 server_tool_use(模型发起的搜索/打开网页动作)+ web_search_tool_result / web_fetch_tool_result(结果)+ 带 citations 的 text(带引用的回答)。客户端不需要执行工具,只需把这些块渲染出来、并在多轮时原样回传。
6.3 Step 2 · 直接调用独立工具(Search / Fetch)
不想让模型自己决定?自己精确调用:
bash# 网页搜索curl https://api.deepseek.com/v1/tools/search \ -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \ -H "Content-Type: application/json" \ -d '{"query": "DeepSeek V4 发布", "count": 5, "need_content": true}'# 网页抓取(返回 Markdown 正文)curl https://api.deepseek.com/v1/tools/fetch \ -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \ -H "Content-Type: application/json" \ -d '{"url": "https://example.com/article"}'6.4 Step 3 · 跑通官方客户端 chat-demo
bashgit clone https://github.com/deepseek-ai/chat-demo.gitcd chat-demopnpm installpnpm dev # 打开 http://localhost:8090,在设置里填 API Key想改造成自己的产品,就按图 3 的分层动刀:换主题/文案在表现层,改请求和扩展在服务层 api,改存储策略在存储层。pnpm build 产出纯静态 dist/,丢到任意静态托管即可上线。
6.5 Step 4 · 组合独立能力做一个「语音学习助手」
把 OCR / ASR / TTS 串起来,就是一个最小可用的垂直应用:
拍照/上传试卷 ──OCR──▶ 文本 用户语音提问 ──ASR──▶ 文本 ──▶ deepseek-flash 讲解 ──▶ TTS ──▶ 语音播报 每一步都是独立 API,按需用哪步调哪步,不必整套接入对话。
6.6 Step 5 · 上强度:搭一个自主 Super-agent
bashgit clone https://github.com/deepseek-ai/dsh-superagent-prototype.gitcd dsh-superagent-prototype# 官方建议:让你的编码代理读 SETUP.md 和你一起完成部署按文档顺序读 000-philosophy → 001-domain → 002-authorization → 003-execution → 007-architecture。起步务必把 accept mode 设为 observe(只记录不执行),白名单放短,确认它「会做的事」靠谱后再切 auto。
6.7 避坑清单
计费:联网搜索按查询词条数计、抓取按成功网页数计,与 Token 费叠加;深度思考搜索工具调用多,成本要预估。 限速:Search QPS 100、Fetch QPS 25(账号级),超限返回 429。 多轮回传:带联网工具块的历史要保留 kind/signature,否则读过的网页不再进上下文。续写限制:用过联网工具的回复不能「继续生成」,需重发上一次请求。 拒答处理: stop_reason=refusal/content_filter要能优雅降级,别当崩溃处理。合规:对外服务务必开 safety_check,并履行内容审核、登记、AI 标识义务。
7. 七、结语
三个月,三步棋:把运行时插件化(Harness),把代理自主化(Super-agent),把能力和外壳一起开放(全家桶 API + chat-demo)。DeepSeek 没有选择把官方 App 越做越厚,而是选择把整条产品栈拆成积木递到每个开发者手里。
当「做一个自己的超级 App」的成本降到一次 git clone 加一条 curl,超级 App 的定义就被改写了——它不再属于十几亿人,它可以只属于你一个人。
而这,或许才是这次开放真正想抵达的未来。
参考:DeepSeek 官方 API 文档(api-docs.deepseek.com)、deepseek-ai/chat-demo、deepseek-ai/dsh-superagent-prototype、DeepSeek 全家桶应用 API 发布公告(2026-11-13)。