ARTICLE · 1366702
一直免费的DeepSeek网页版和App,开始限额了
从上线到现在,DeepSeek 的网页版和 App 一直是免费的。不用开会员,也没有每天能聊多少次的说法。个人用户想花钱,只有开放平台的 API 一个入口,按 Token 计费。
这个周末,情况变了。
据 IT之家 11 月 16 日报道,11 月 15 日起,多名用户反馈 DeepSeek 网页版和 App 开始限额,主要有三条:
• 超过 7 天不活跃的长对话不再支持,提示原因是"算力不足"; • 单次输入的文字上限缩短到 4 万字左右; • 每天的对话有额度,用完会提示"因服务器繁忙,使用额度已达上限"。
截至发稿,DeepSeek 没有发布正式公告,也没有给出恢复时间。
免费没有取消,但"随便用"的时代先结束了。更值得看的是,就在限额前一天,DeepSeek 刚做了一个方向完全相反的决定。
一、两天里的两个决定
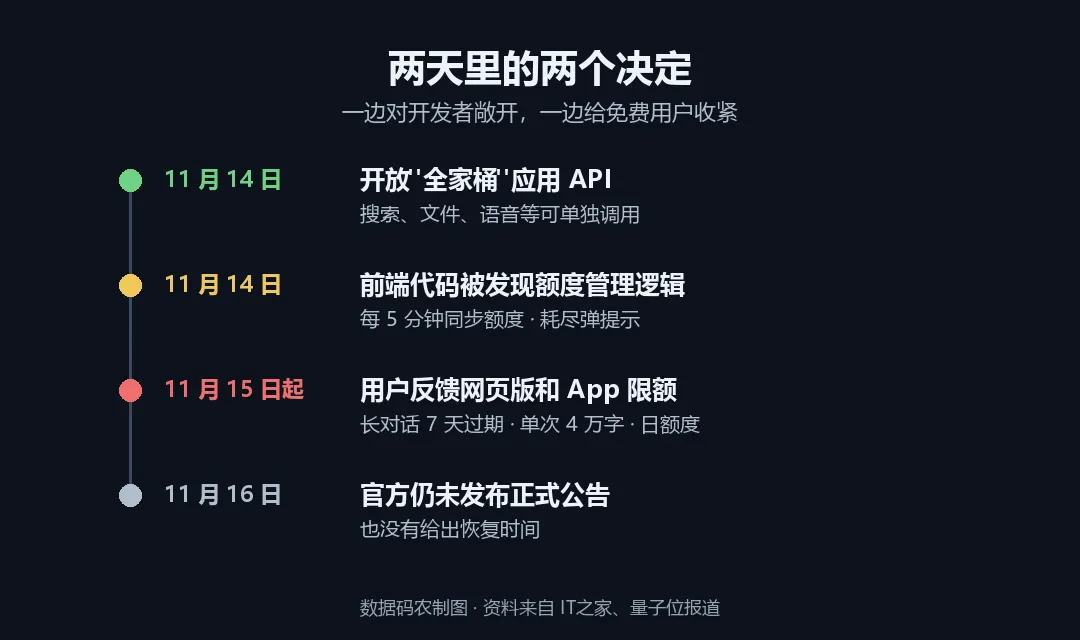
据量子位 11 月 14 日报道,DeepSeek 宣布开放"全家桶"应用 API。App 里的联网搜索、文件上传、链接阅读,以及首次开放的语音识别和语音合成,开发者都能单独调用、分别计费。官方的说法是,开发者"甚至可以 1:1 复刻出完整的 DeepSeek App"。
同一天,IT之家报道,有开发者在网页版前端代码里翻出一整套额度管理逻辑:每 5 分钟同步一次各模型额度,额度耗尽时在输入框上方弹出提示条。
第二天,用户就真的碰到了限额。
一边对开发者敞开,一边给自家免费用户收紧。这两件事放在一起看,DeepSeek 的选择很清楚:算力不够的时候,先保 API。
二、算力为什么不够
最直接的原因,是用的人太多了。
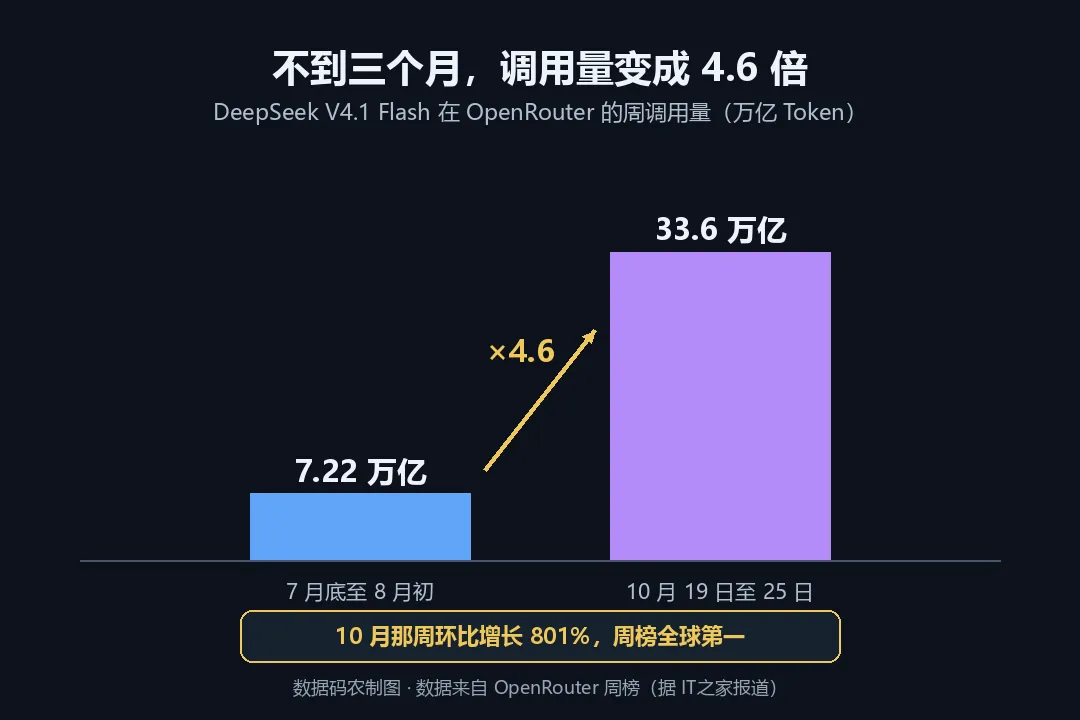
模型聚合平台 OpenRouter 的周榜显示,7 月底到 8 月初,DeepSeek V4.1 Flash 一周调用量是 7.22 万亿 Token。到 10 月 19 日至 25 日那周,涨到 33.6 万亿,环比增长 801%,不到三个月变成原来的 4.6 倍。
需求涨得比算力快,服务就会吃紧。
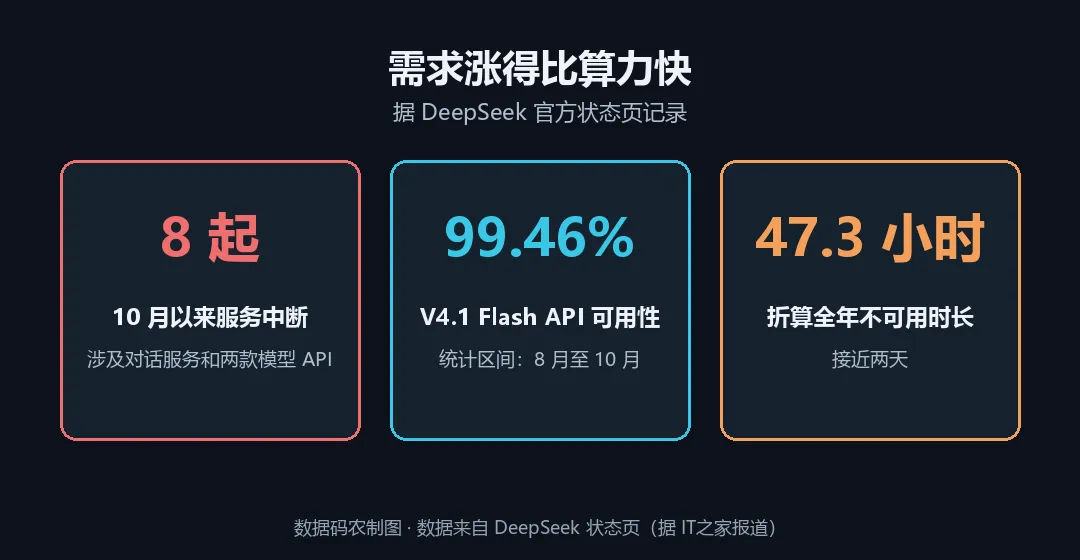
据 DeepSeek 官方状态页记录,10 月以来平台发生了 8 起服务中断,涉及对话服务和两款模型的 API。8 月至 10 月,V4.1 Flash API 可用性是 99.46%。99.46% 听起来很高,但折算成全年,约有 47.3 小时用不了,接近两天。
对按 Token 付费、把模型接进自家产品的企业来说,这两天就是真金白银的损失。
三、为什么先拿长对话开刀
三条限额里,"7 天不活跃的长对话不再支持"最容易让人困惑:放着不用的对话,为什么也要砍?
原因在于大模型的工作方式。模型没有真正的"记忆",你在一个对话里每问一句,它都要把前面所有内容重新读一遍,再生成回答。对话越长,每一轮要处理的内容就越多。
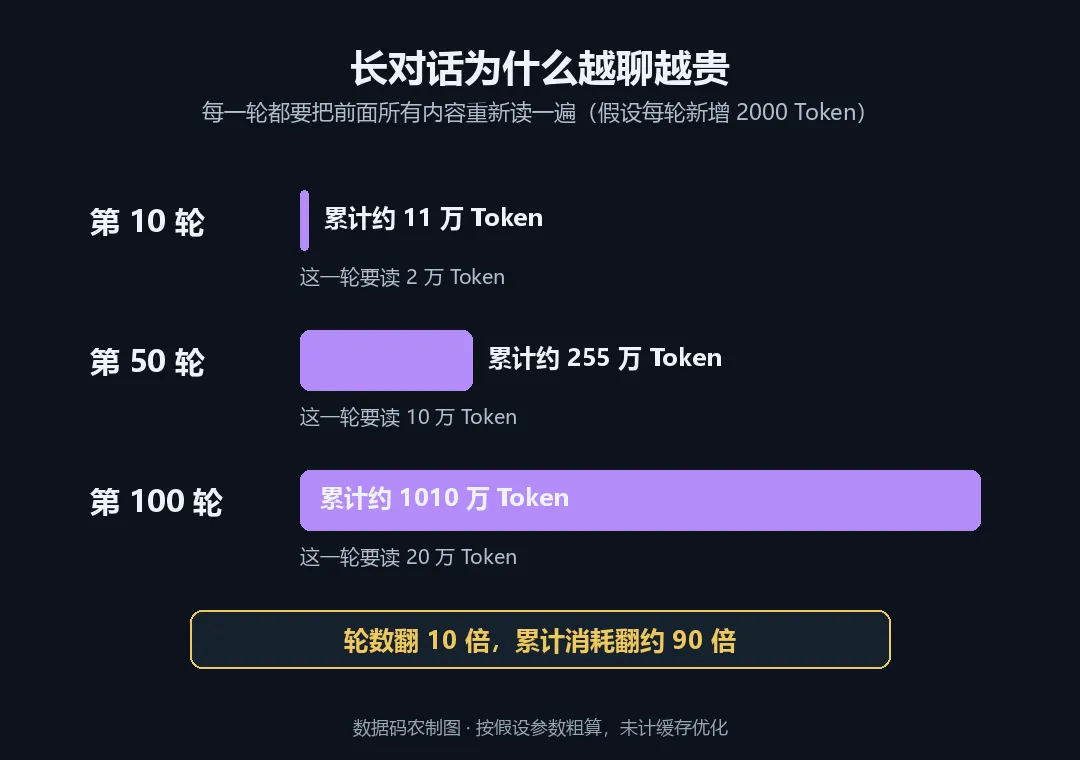
算一笔账。假设每一轮问答新增约 2000 个 Token:
• 聊到第 10 轮,这一轮要读 2 万 Token,前 10 轮累计处理约 11 万; • 聊到第 50 轮,这一轮要读 10 万 Token,累计约 255 万; • 聊到第 100 轮,这一轮要读 20 万 Token,累计约 1010 万。
轮数翻 10 倍,累计算力消耗翻了约 90 倍。实际系统会用缓存降低一部分成本,但"越聊越贵"的方向不会变。
7 天没碰的长对话,用户很可能早就不需要了。可一旦有人回来接着问,系统就要把几十轮内容重新加载一遍。砍掉这部分,省下的是成本最高的那一块。
单次 4 万字的上限也是同样的逻辑。按 1 个汉字约 0.6 到 1 个 Token 粗算,4 万字大约是 2.4 万到 4 万 Token。一次扔进一本书,等于让模型一口气读完再回答。限住单次输入,就限住了最重的那一类请求。
四、免费用户和 API 用户,谁更值钱
站在 DeepSeek 的角度,这道选择题并不难做。
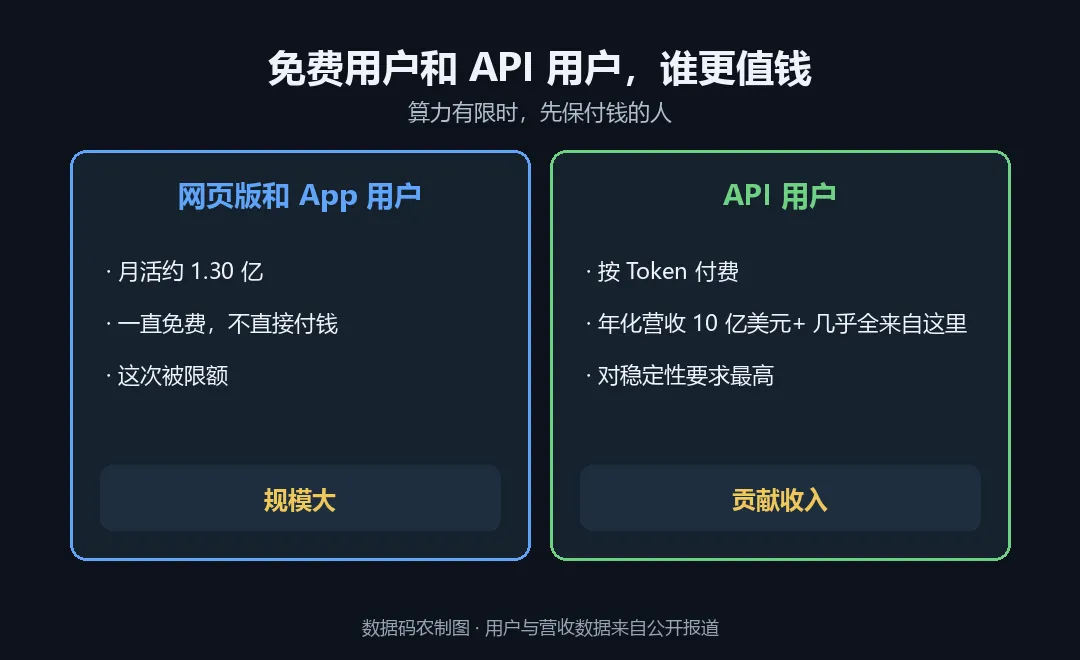
据报道,DeepSeek 目前月活约 1.30 亿,年化营收突破 10 亿美元,几乎全部来自 API。网页版和 App 的用户规模大,但不直接付钱;API 用户数量少,却贡献了几乎所有收入,而且对稳定性要求最高。
算力有限时,优先保住付钱的人,是任何一家公司都会做的选择。
那网页版和 App 会不会收费?目前还没有答案。前端代码里的额度逻辑指向一个名为"Coding Plan"的套餐,有网友据此猜测,DeepSeek 可能会推出首个面向个人的付费方案。但官方没有公布任何价格、档位和上线时间,这些都还只是猜测。
五、对普通用户和开发者意味着什么
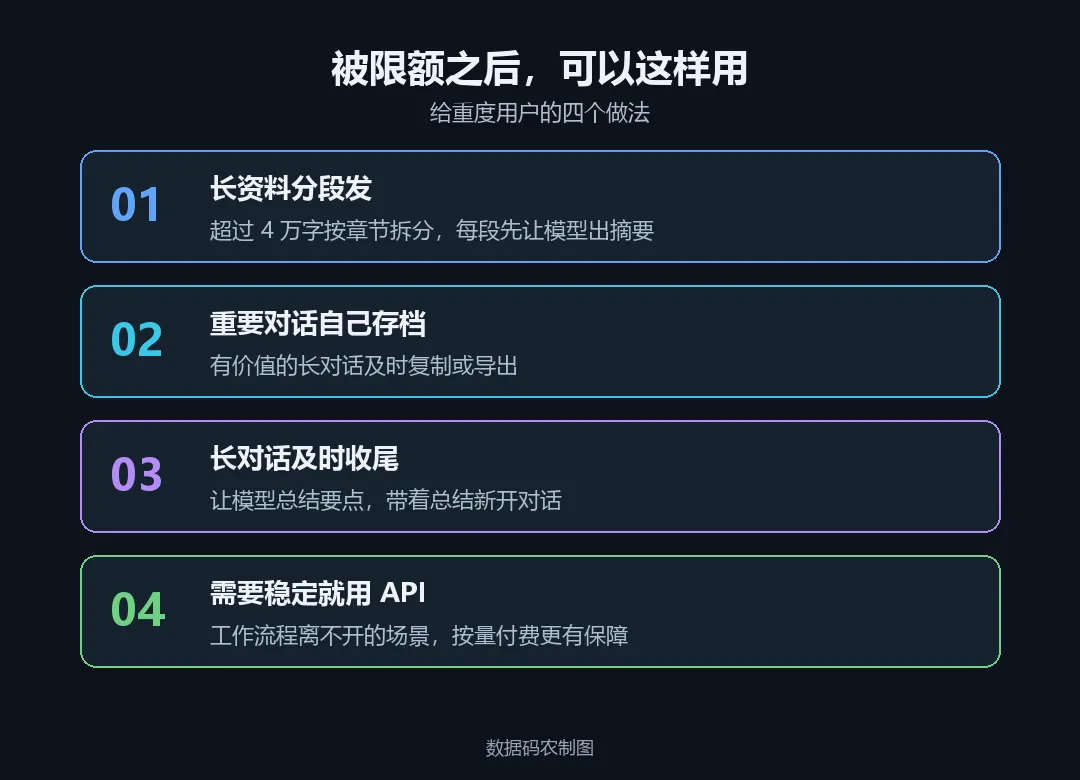
如果你是网页版和 App 的重度用户,可以先做四件事:
• 长资料分段发。 超过 4 万字的文档按章节拆分,分几次输入,每次让模型先输出一段摘要。 • 重要对话自己存档。 有价值的长对话及时复制或导出,不要指望它一直留在历史记录里。 • 长对话及时收尾。 一个对话聊到很长时,让模型总结要点,带着总结新开一个对话,比在老对话里硬接更快也更省额度。 • 需要稳定就用 API。 如果是工作流程离不开的场景,API 按量付费,可用性也更有保障。
如果你是开发者,这次限额反而说明 API 是 DeepSeek 优先保障的渠道。但 10 月以来的 8 次中断也提醒你,核心业务最好准备一个备用模型,别把所有请求压在一家身上。
写在最后
DeepSeek 的免费网页版和 App,曾经是很多人第一次认真用大模型的入口。这次限额没有取消免费,只是给免费加上了边界。
边界背后是一笔很现实的账:算力有限,收入几乎全靠 API。在扩容跟上之前,免费用户能用到多少,取决于付费用户用剩多少。
欢迎评论区聊聊:你被 DeepSeek 限额提醒过吗?如果网页版推出付费套餐,你会买吗?
关注数据码农,用数据和技术的视角重新理解科技圈。每周2-3篇硬核分析,不追热点,只追逻辑。