ARTICLE · 1368300
你别再复制粘贴,3步让AI读链接和PDF
AI 实测 · 1618 字 · 约 4 分钟
一句话说清
一人公司做简报:把联网搜索、读链接、已解析 PDF 文本串成一次请求。
我是一人公司运营者,每周用 DeepSeek 新版 API 把 3 个竞品链接和已解析的 PDF 文本串成一次请求;个人 3 次小样本里,初稿从约 40 分钟降到约 6 分钟(非普遍效果,测试条件见“效果”)。
下面是我跑通的 3 步。
先说我自己的卡点。
我每周要给两个客户做竞品简报。输入很杂:3 个竞品链接、1 份行业 PDF、偶尔一张活动截图。
以前我的动作是:开聊天窗口,复制网页正文,粘进去;PDF 下载后转文字,再粘;图片先 OCR,再粘。
一篇简报 40 分钟起步。漏链接、漏页码是常事。
客户问“这句哪来的”,我还得回去翻。
我试过什么,为个方案:全靠手动复制粘贴。卡在长文。
网页超过 1 万字,粘贴就断;PDF 表格一转就乱。
引用全靠我记。
第二个方案:自己拼搜索 API、网页抓取、PDF 解析。能跑,但维护烦。三个 Key、两套计费,一个反爬就报错。为了一篇简报,不值。
最终方案:DeepSeek 新版 API 一次请求
我最近试用 DeepSeek 新版 API:它提供标准接口,可把联网搜索、读链接等能力串进请求;具体开放公告、模型名和接口范围以官方控制台/文档为准。
在控制台按文档开启联网搜索、读链接等相关能力后,工具调用和上下文拼接由服务端完成;参数名和默认值以控制台文档为准。
我用的是控制台当前可选的对话模型(模型AI SDK Chat Completions 写法;如果你用别的接口,按官方文档替换。
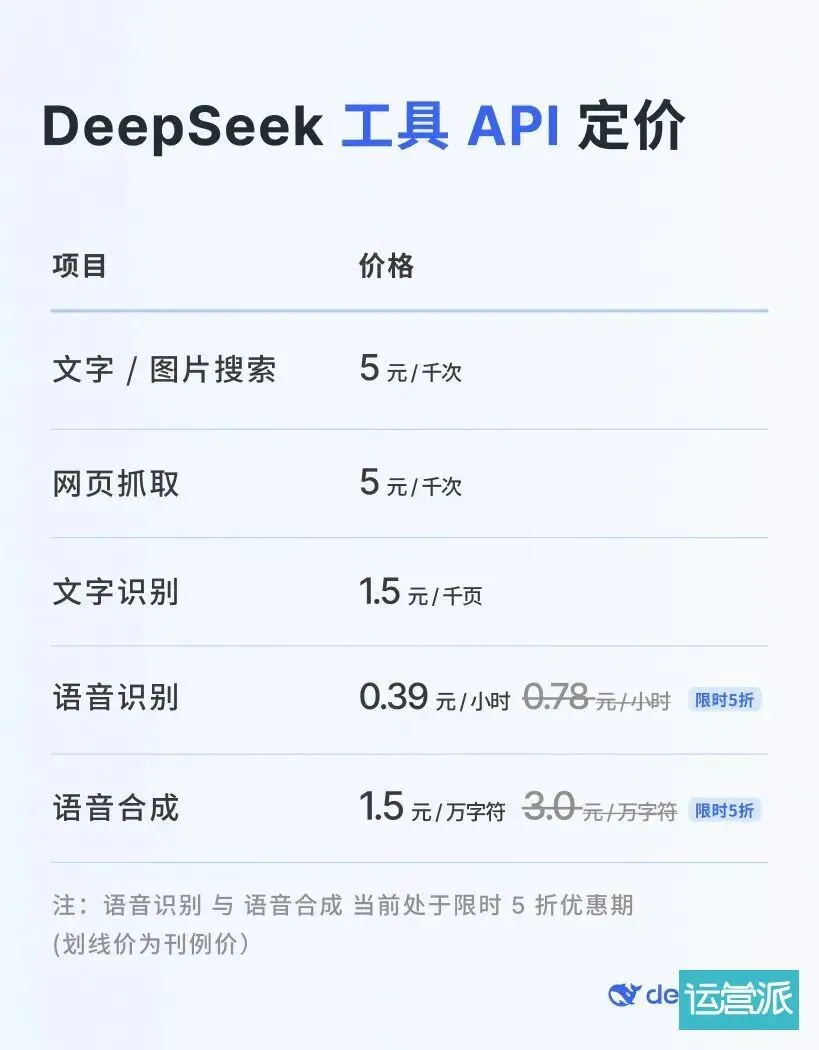
价格上,扩展能力除 Token 费用外,还会收工具调用费;单价以控制台为准。我写作时未看到公开单价,先按小批量跑。
第 1 步:零代码验一遍
先打开官方开源的轻量前端 Demo:
https://cdn.deepseek.com/chat-demo
导入一段历史对话,丢一个链接进去,看它会不会自动抓取并附引用。再贴一份已解析的 PDF 文本(或上传 PDF 后复制解析结果),看引用是否完整。
这一步只花 5 分钟。
先确认你的链接和已解析文本能跑,再写代码。
第 2 步:配一个请求骨架
下面这段是请求体骨架。
deepseek_web_search、dee 按需开;已解析的 PDF 文本拼进 user content。
工具类型名和安全校验参数名以控制台文档为准。
{ "model": "控制台当前模型名", "messages": [ { "role": "system", "content": "你是我的竞品简报助手。只输出 Markdown。结构:1. 一句话结论;2. 3 条关键证据,每条带来源链接或文件名;3. 风险与机会;4. 今天就能做的 1 个动作。找不到来源就写“未找到”,不要编。" }, { "role": "user", "content": "请分析这三个链接和这份已解析 PDF 文本,做一份 300 字内的竞品简报。链接:https://example.com/a https://example.com/b https://example.com/c。文件文本:<把 competitor.pdf 解析后的文本粘贴到这里>。" } ], "tools": [ { "type": "deepseek_web_search" }, { "type": "deepseek_read_url" } ], "safe_check": true}
注意:model 需替换为控制台当前模型名;safe_check 是我在骨架里的占位写法。
安全校验参数名以控制台为准。对外提供服务,这个必须开。
如果你用 Python,直接套 OpenAI SDK 的 Chat Completions 写法。
把 base_url 换成官方控制台给你的地址,模型名用控制台当前可选值。
import osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["DEEPSEEK_API_KEY"], base_url=os.environ["DEEPSEEK_BASE_URL"], # 填官方控制台地址)parsed_pdf = "把 competitor.pdf 解析后的文本粘贴到这里"model_name = os.environ["DEEPSEEK_MODEL"] # 填控制台当前模型名resp = client.chat.completions.create( model=model_name, messages=[ {"role": "system", "content": "你是竞品简报助手。只输出 Markdown,证据必须带来源。"}, {"role": "user", "content": f"读这三个链接和已解析 PDF 文本,输出 300 字简报。链接:https://example.com/a https://example.com/b https://example.com/c。文件文本:{parsed_pdf}"}, ], tools=[ {"type": "deepseek_web_search"}, {"type": "deepseek_read_url"}, ], # safe_check 参数名以官方文档为准)print(resp.choices[0].message.content)
这段代码不替你解析 PDF。
这篇只覆盖读链接和已解析 PDF 文本:先用你惯用的 PDF 转文本工具得到文本,再作为 parsed_pdf 拼进 user content。
Office/图片同理,先解析或 OCR;上传字段不在这篇范围,按官方文档填。工具类型名也以官方文档为准。
第 3 步:把输出固定成模板
提示词别每次重写。我固定用下面这段,粘到系统消息里。
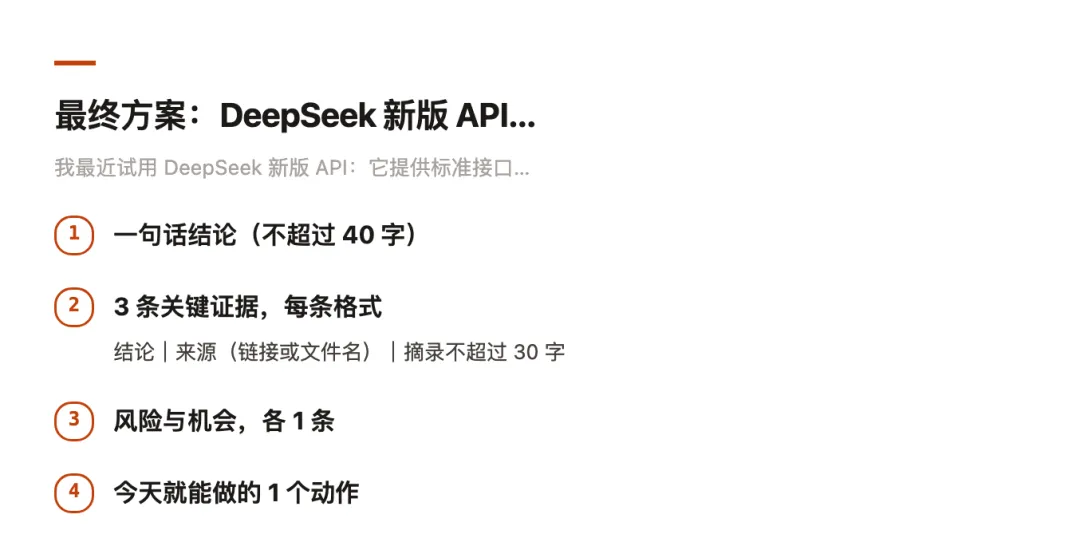
你是我的竞品简报助手。输入可能包含网页链接、已解析的 PDF/Office 文本或图片 OCR 文本。请按以下格式输出 Markdown:1. 一句话结论(不超过 40 字)2. 3 条关键证据,每条格式:结论|来源(链接或文件名)|摘录不超过 30 字3. 风险与机会,各 1 条4. 今天就能做的 1 个动作规则:- 只能使用输入材料和工具返回的内容。- 找不到来源写“未找到”,不要编。- 涉及价格、版本、日期,必须保留出处。- 输出中文,短句。
跑完把结果丢进飞书文档或 Notion。我只做一件事:抽检 3 条证据的来源。
效果
我拿同一批输入对比:3 个链接、1 份 12 页 PDF 的已解析文本、1 张活动截图的 OCR 文本。
原来手动复制粘贴,40 分钟出初稿。
现在一次请求,约 6 分钟出带引用的初稿。
这是个人小样本体验(样本仅 3 次),非普遍效果;测试条件为同一批输入、同一提示词、连续 3 次。
失败案例:需登录/反爬页面抓不到;解析质量差的 PDF 或截图 OCR 仍要人工校对。
工具数量从 5 个降到 1 个:不用再单独开搜索、抓取、PDF 解析、OCR、聊天窗口。
产出固定为 1 份 Markdown 简报、3 条带来源证据。客户追问时,我直接点链接。
避坑
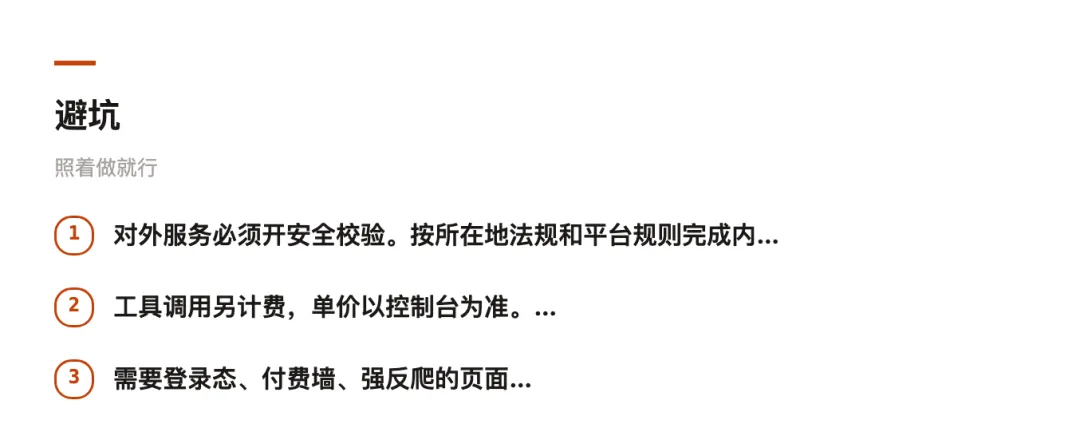
| 1 | |
| 2 | |
| 3 | deepseek_read_url 抓不到。实时金融行情、必须 100% 最新的数据,也别把宝全押在这。 |
收尾
一句话判断:一人公司做简报,这套能把“复制粘贴加拼工具”压成一次请求,值。
今天就能做:打开下方 Demo。
https://cdn.deepseek.com/chat-demo
丢一个你手头最烦的链接,看它能不能带引用答出来。