ARTICLE · 1389601
你看到一个 App 里好用的功能,却不知道它是怎么做的:rea 怎么把一个软件拆成能读、能抄、能训练的东西
AI 现场 · 第 25 期
先说一个做产品的人几乎都遇到过的场面。
你看到一个 App 里某个功能做得特别好——搜索、导出、批量操作、离线同步——想在自己产品里复现它。你拿不到源码,只能装上它、点一遍、猜它用了什么库、什么协议、什么数据结构。
猜错的代价很具体:接口对不上、协议字段猜错、边界情况没覆盖,等真正上线才发现全错。
过去这件事只有一个办法:请懂逆向的人来。现在多了一条路——把逆向工具接给 AI,让它自己读。
这条路上的代表项目叫 rea。到 2026 年 11 月 19 日,它有 468,348 颗星、114,485 个 fork,MIT 许可,TypeScript 写就,仓库当天仍有推送。
三句话先给结论:
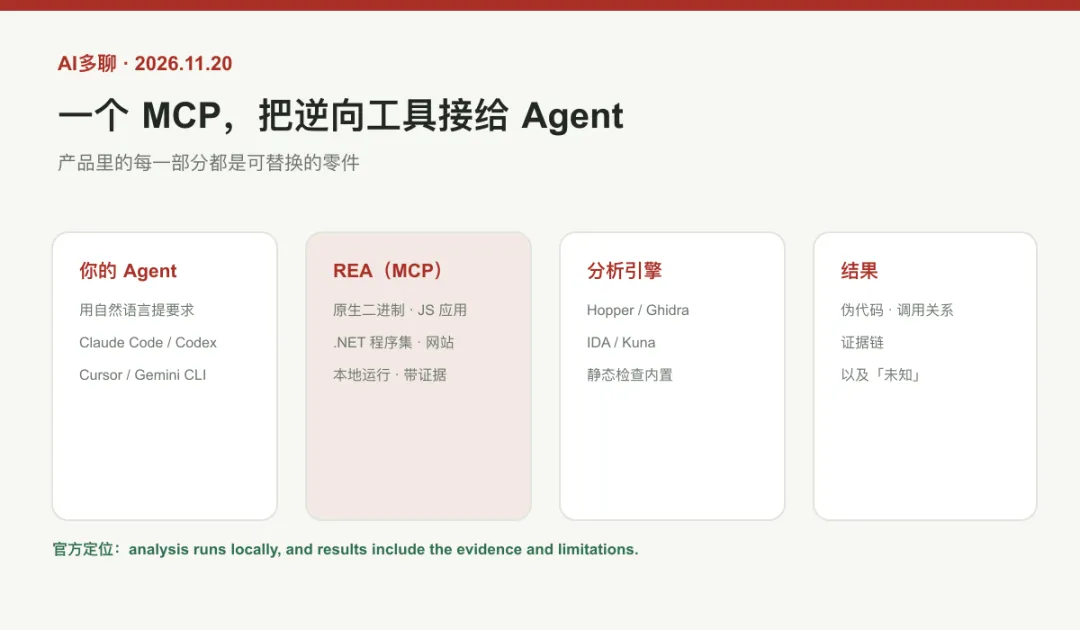
第一,rea 把自己定位成一个 MCP 服务:一个能跨越原生二进制、JavaScript 与 Electron 应用、.NET 程序集和网站的逆向外壳,AI 通过标准协议调用它,也能在终端里直接用。
第二,它的输出不只是结论,还有证据与限制:每条结论背后有可复核的代码片段、符号和调用关系,读不懂的地方会写成「未知」,而不是编一个像样的解释。
第三,它不替你做判断:有权分析的目标、能装哪些逆向引擎(Hopper、Ghidra、IDA、Kuna)、是否允许它写文件,都由你决定。
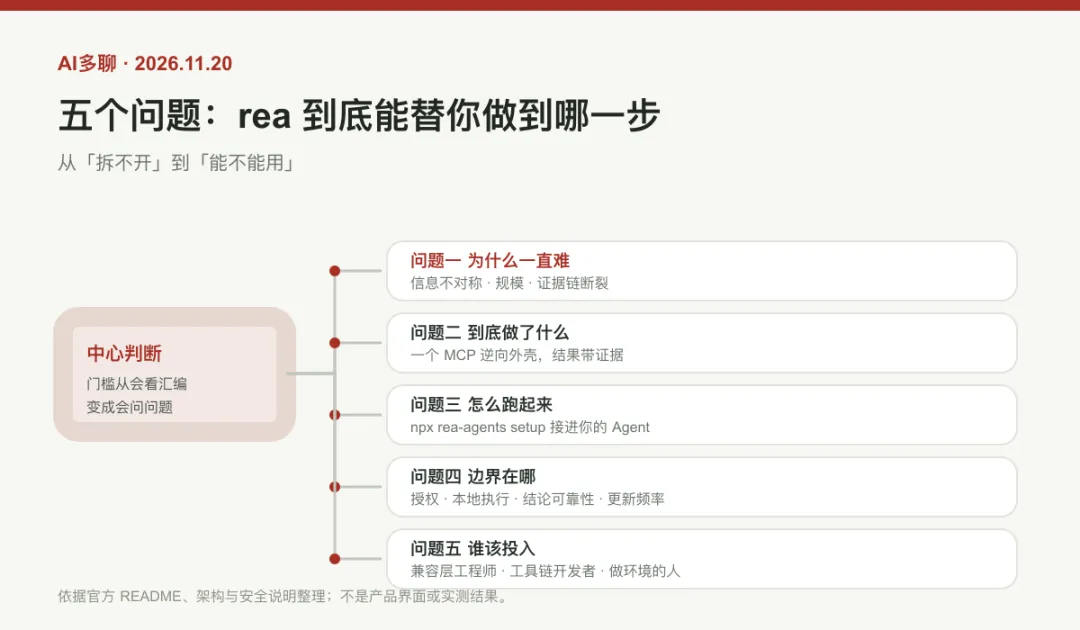
下面按五个问题回答:逆向为什么难、rea 做了什么、怎么跑起来、边界在哪、谁值得现在投入。
问题一:逆向为什么一直难
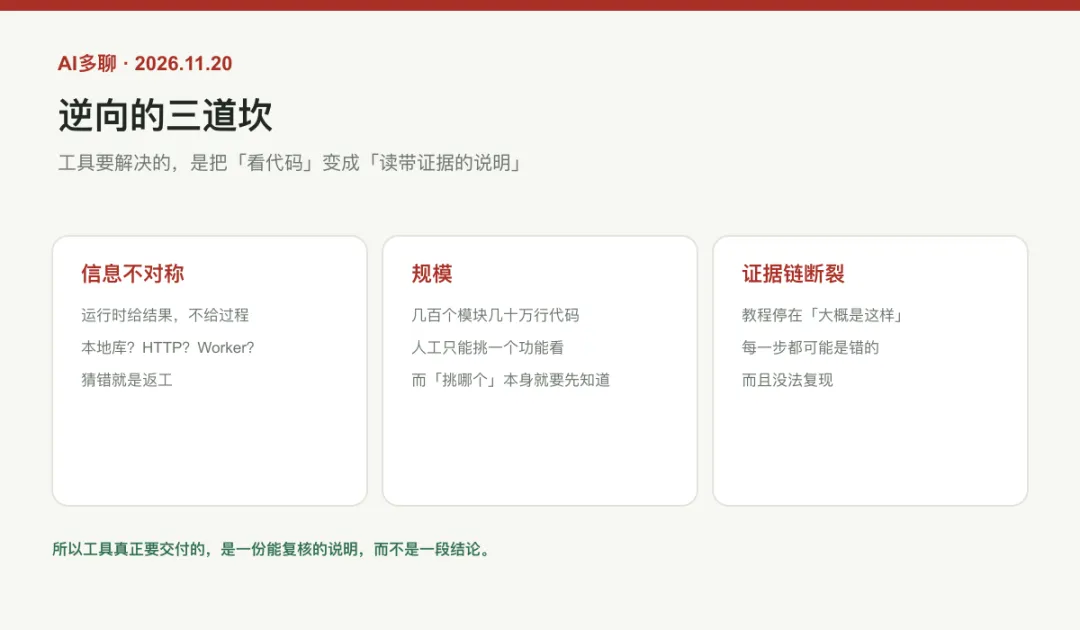
逆向的核心困境是信息不对称。软件运行时会告诉你结果,但不会主动告诉你过程。你看到按钮点击后界面变了,却不知道背后是本地数据库、HTTP 请求还是 Worker 线程。
过去靠三种办法破解这个不对称:读反汇编代码、动态调试看运行时行为、拿工具猜协议。每种都要长期训练,门槛在于「知道该看什么」。
第二个困境是规模。一个桌面应用可能含几百个模块、几十万行 JS、几十个原生库,人工看不过来;于是大家只分析真正需要的那个功能。可「只分析需要的」本身要求先知道它在哪。
第三个困境是证据链断裂。很多逆向教程停在「大概是这样」;等你自己动手,会发现每一步都可能是错的,而且没有复现方式。
所以工具要解决的,是把「看代码」变成「读一份带证据的说明」。
问题二:rea 到底做了什么
先看它自己的说法。项目标题写得很直接:
REA: Reverse Engineer Anything — One MCP for reverse engineering across binaries, applications, and runtime behavior.
翻译:REA:逆向任何东西——一个跨越二进制、应用与运行时行为的逆向分析 MCP 服务。
README 里的定位句更具体:
See a feature you like. Understand how it works, down to the binary level.
翻译:看到你喜欢的功能,就理解它是怎么工作的,一直追到二进制层面。
REA connects your agent to tools for inspecting native binaries, JavaScript and Electron apps, .NET assemblies.
翻译:REA 把你的 Agent 接到一组工具上,用来检查原生二进制、JavaScript 与 Electron 应用、.NET 程序集。
You can also use the same tools from your terminal.
Analysis runs locally, and results include the evidence and limitations behind each conclusion.
翻译:同一组工具也能在终端里直接用。分析在本地运行,结果里带着每个结论背后的证据与限制。
这里有两个词值得停下来看。
一个是 MCP:模型与工具之间的标准接口层。区别于「给模型一个命令行」,MCP 让工具自己声明能力、参数和输出结构,模型按需调用。
另一个是 evidence and limitations:结果不只有结论,还有「凭什么这么说」和「哪里不知道」。对逆向工具来说第二点更重要——最贵的成本是「信了一个错结论」。
它能分析的目标,比很多人想象的宽。官方文档列了一张表(放到文末),覆盖桌面应用、原生二进制、Go 二进制、GPU 代码对象、模型文件、IL2CPP 元数据、Rust 二进制等,另外还支持 Godot 归档、离线 ELF 诊断与 PE 证书解析。
换句话说,你不必先知道目标是什么技术栈。
问题三:怎么跑起来
官方给的第一步是给 Agent 装上它。装好 Node.js 和 npm 之后:
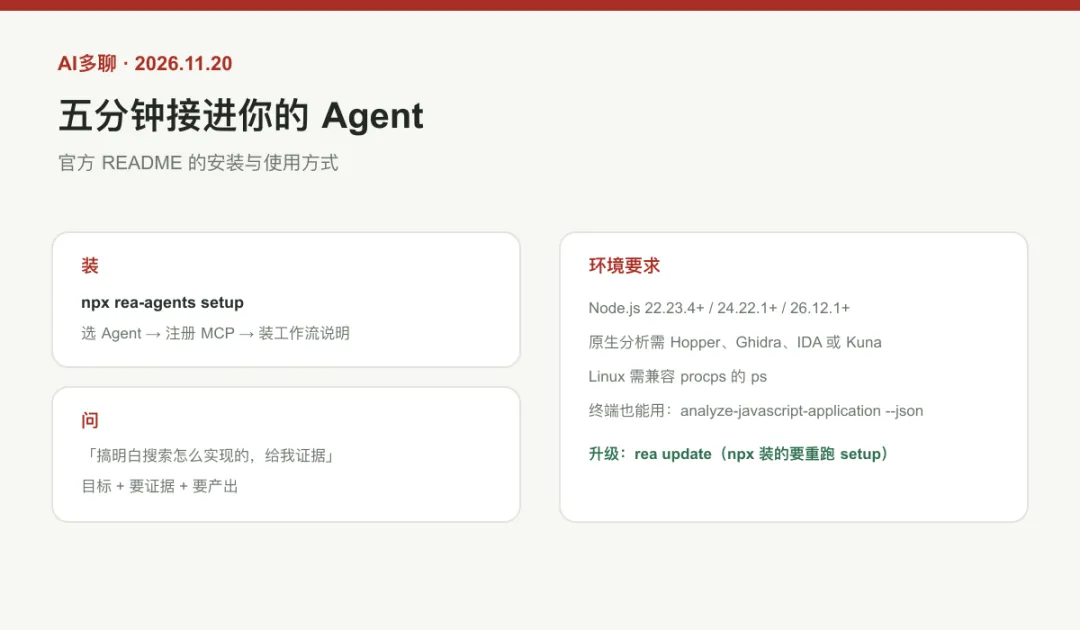
npx rea-agents setup这个命令做三件事:列出支持的 Agent 让你选、把 MCP 服务注册进去、安装配套的工作流说明(让 Agent 知道怎么用这些工具),并给现有配置备份。
官方支持 Claude Code、Codex、Cursor、Gemini CLI、Grok Build 等。
装完重启 Agent,就能用自然语言让它干活:
Understand how search works in the Notes app, show me the evidence, and build a similar feature for my project.翻译:搞明白 Notes 应用里的搜索是怎么实现的,把证据给我,然后在我的项目里做一个类似的功能。
这句话的结构值得学:目标 + 要证据 + 要产出。第三句把逆向从「学术活动」变成了「工程输入」。
不想用 Agent 也可以直接在终端跑:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json结果里包含模块、依赖、Electron 边界及证据。
环境要求也有讲究。官方文档写明需要 Node.js 22.x(不低于 22.23.4)、24.x(不低于 24.22.1)或 26.12.1 以上。
原生分析需要你已有 Hopper、Ghidra、IDA 或 Kuna 之一,setup 可以在你批准后帮你装 Hopper;纯静态的 JavaScript 分析不需要原生引擎。Linux 上还要有兼容 procps 的 ps 命令,用来判断进程归属。
这些细节琐碎,却说明一件事:它把「真实工程环境」当回事,不是把逆向简化成演示。
问题四:它的边界在哪
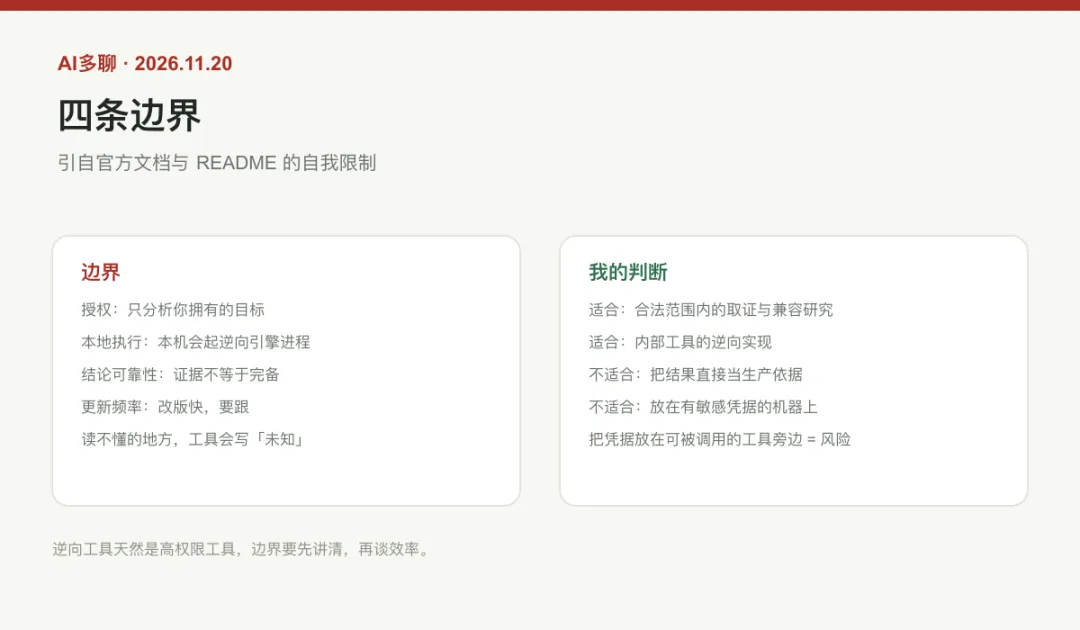
逆向工具天然是高权限工具,边界必须先讲。
第一条边界是授权。分析一个软件意味着读它的文件、看它的进程行为、必要时执行它的代码。对自己的软件做没问题,对别人的软件做就是另一回事;官方要求只分析你拥有或有权分析的目标。
第二条边界是本地执行。分析在本地跑,本机就会出现逆向引擎进程、产生中间文件。放在有敏感凭据的机器上,等于把凭据放到可被调用的工具旁边。
第三条边界是结论的可靠性。官方反复强调结果要带证据和限制,这恰恰说明结论可能不完整:逆向能告诉你某个函数做了什么,不能保证它在所有输入下都这样。
第四条边界是更新频率。README 写明 rea 变化很快,新版本常带 bug 修复;升级命令是 rea update,用 npx 安装的还要重跑一次 setup。它更像需要跟随的伙伴,而不是装一次就稳的工具。
四条合起来,我的判断是:rea 适合做「合法范围内的取证、兼容研究、内部工具的逆向实现」,不适合把结果直接当成生产实现的依据。
问题五:什么人值得现在投入
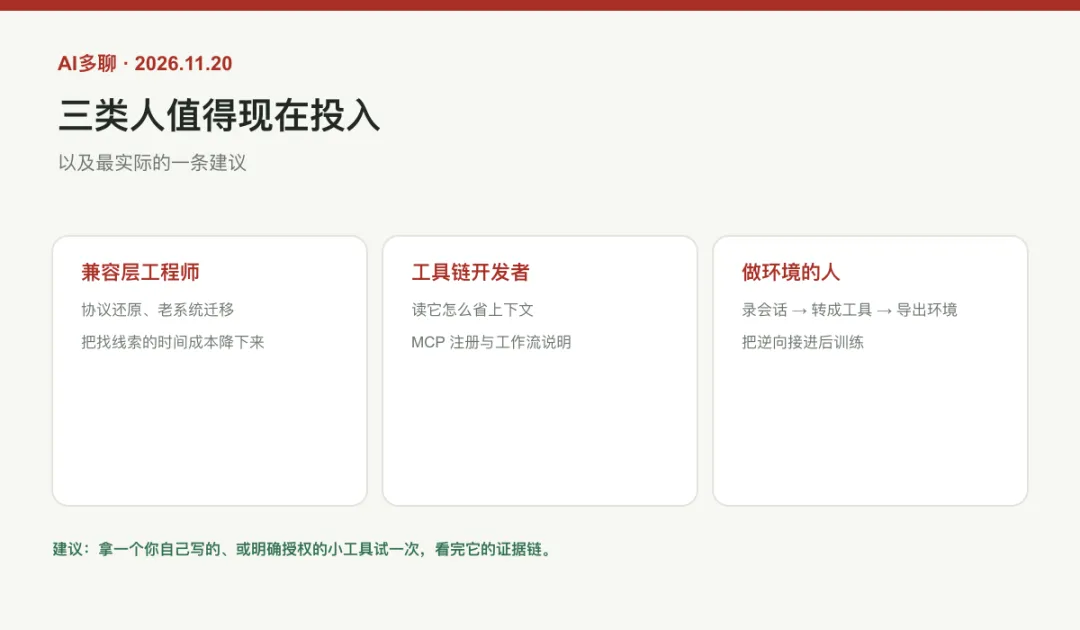
三类人。
第一类,做过兼容层、协议还原、老系统迁移的工程师。rea 把「找线索」的时间成本降下来,适合功能分散、要反复确认调用链的场景。
第二类,做 AI Agent 工具链的开发者。rea 已把 MCP 注册、工作流说明、本地证据做完了,值得读它怎么把「工具说明」和「输出结构」做紧凑以省上下文。
第三类,想把软件变成训练环境的人。这是 rea 最新、也最被低估的能力:录下一段 Web 应用会话,把 API 转成工具,导出一个 Agent 可练习的环境。
路径是:
rea environment-build ./session.har ./my-env --name my-env --jsonagent-env run ./my-env配合 AgentEnv 和 Docker 就能跑。生成的目录含一个检查能否启动的基础测试,之后可接强化学习框架,定义任务目标、加奖励检查、开始训练。
这条线值得单独说一句:它把「逆向」和「后训练」接在了一起。过去讨论 Agent 环境都是怎么写任务;现在可以直接从一个真实应用里录出来。本期日报第二条讲的物理 AI 训练环境,正是它在机器人领域的版本。
附:rea 能分析什么
数字取自 2026 年 11 月 19 日的 GitHub API:468,348 星、114,485 fork、1,383 个开放 issue、MIT 许可。
结语:逆向的门槛,正在从「会看汇编」变成「会问问题」
rea 最值得注意的地方,不是它能分析多少种二进制,而是把逆向的入口从命令行搬到了 Agent 能调用的位置。
变化体现在顺序上:以前你得先成为逆向专家才知道从哪下手;现在可以先描述想要的功能,让工具把证据摊开,再由你判断要不要相信。
但顺序反过来也意味着责任回到人身上:工具负责给证据,证据够不够、结论能不能用、目标该不该分析,仍然要你来判断。
最实际的一条建议:拿一个你自己写的、或明确授权的小工具试一次。看完证据链,你就知道这类工具现在的水平线在哪。
本期钩子
下一期我们把「本地跑模型到底要多少显存」拆成一张表,从 7B 到 70B 逐档告诉你:哪一档能用消费级显卡跑、哪一档必须上量化、哪一档老老实实该租云。
留言问题
你有没有过「想让 AI 复现某个 App 的功能,却只能靠猜」的时刻?回复【逆向】,可拿到本期提到的逆向工具清单与它的能力边界对照表,含支持的目标类型、依赖的引擎与运行要求,转给同事也能照着试。
关注 AI多聊,工作日更新 AI 现场、热点拆解与工具横评。本文收录于《AI最前线》。
扩展阅读
下面 10 篇是我写过的高阅读旧文,点标题直接跳转
关于作者
Mars小七|AI多聊 · AI最前线主笔,盯 AI 前沿的产品与工程实践,把发布会、官方文档和开源仓库拆成能照着做的步骤。
Mars叭叭叭|AI多聊 · AI热点拆解主笔,只写有来源、能追溯的动态,并把新闻拆成你能用的判断。
Mars九九|AI多聊 · 工具横评主笔,用同一道题比工具,给出评分、排名和避坑结论。
AI多聊,工作日每天更新三篇:AI 现场、热点拆解、工具横评。
关注我,持续分享高质量内容
AI多聊|工作日每天更新 AI 现场、热点拆解与工具横评三篇
实践出真知 · 每天进步一点点
路虽远,行则将至;事虽难,做则必成
觉得有用,转发给正在剪片的同事,或点「分享」让更多人看到
AI工具(简单免费),推送最新AI、财经咨询