ARTICLE · 1392186
MongoDB|怎样在 .wt 文件里读出一条文档?(下)
《数据库灾难恢复丛书》MongoDB 卷
1.1 单条数据的结构
BSON 文档的字节边界
我们将页内第 0x2B 字节的位置的 BSON〔1〕 起点重新记为文档内第 0 字节的位置。BSON 开头的四字节保存文档总长度,末尾是 00,中间依次保存各元素。图 1.1-7 标出这三个区域。
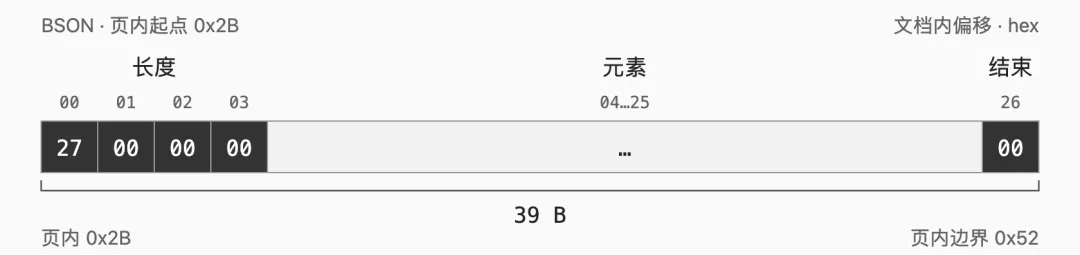
图 1.1-7 确定样本 BSON 的结束位置
这条 BSON 的 39 字节完整列在下面,左侧两列同时标出页内偏移和文档内偏移,便于在叶页中找到同一个字节。
前四字节 27 00 00 00 按照小端字节序读为 39,与短值的长度相同。这 39 字节包括长度字段和最后的 00,因此,文档结束字节应在文档内第 38 字节的位置(0x26)。在读取总长度之后,MongoDB 会将它与最小长度 5 比较,并算出文档结束后的第一个位置。
源码 1.1-5 MongoDB 8.0.16 · src/mongo/bson/bson_validate.cpp · 第 551–558 行。
BSON 元素从文档内第 0x04 字节的位置开始排列,每个元素先保存一字节的类型,再保存以 00 结束的字段名。字段名之后是该类型规定的值;值读到哪里,由类型及其长度信息决定。
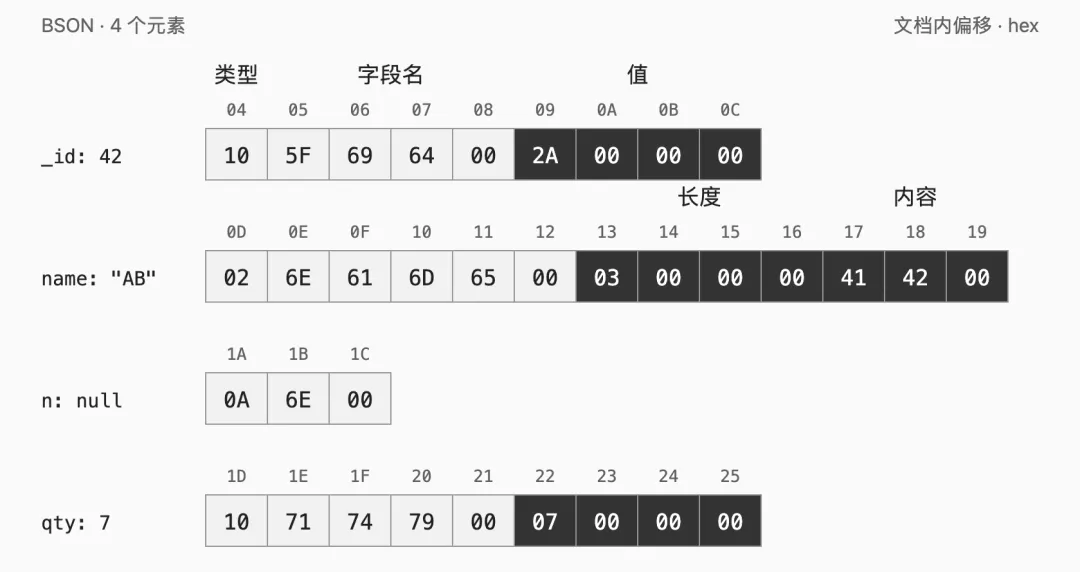
图 1.1-8 按照 BSON 元素顺序读取字段
第一个元素在文档内第 0x04 字节的位置保存类型 10,即 32 位有符号整数。接下来的 5F 69 64 00 是字段名 _id 和终止字节。字段值从第 0x09 字节的位置开始,2A 00 00 00 按小端读为 42。因为四字节值到第 0x0C 字节的位置为止,所以下一个元素从第 0x0D 字节的位置开始。
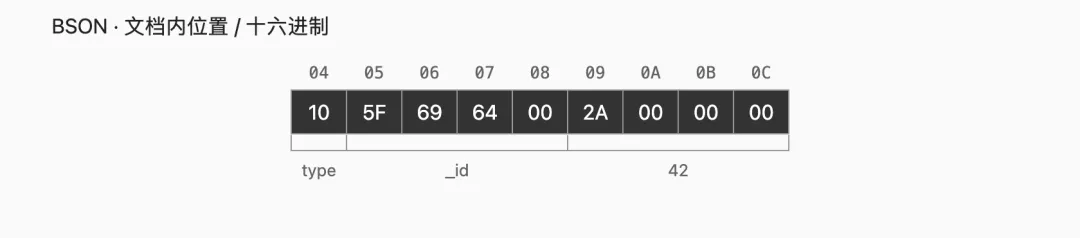
图 1.1-9 BSON 的 _id 元素
第二个元素的类型为 02,字段名是 name。值从第 0x13 字节的位置开始。先读取四字节长度 03 00 00 00,再读 41 42 00。因为这三个字节包含字符串终止字节,所以字符串本身是 AB。
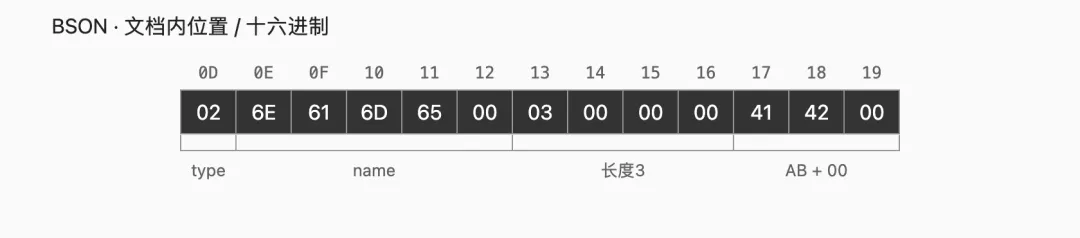
图 1.1-10 BSON 的 name 元素
接着在文档内第 0x1A 字节的位置读到 0A,字段名为 n。BSON Null 在字段名的结束字节之后不占值字节,于是文档内第 0x1D 字节的位置已是下一元素的类型。这个元素再次使用 10,字段名为 qty,其四字节值解为 7。
0x10 | |
0x02 | 00。 |
0x030x04 | |
0x0A |
在逐项读取之后,我们恰好在文档内第 0x26 字节的位置读到文档结束字节。在跳过结束字节之后,内核会比较当前位置和文档声明的末端。只有当各元素的类型、字段名和值都能按其范围读取,且结束位置相符时,才可以将这份值作为完整 BSON 导出。
源码 1.1-6 MongoDB 8.0.16 · src/mongo/bson/bson_validate.cpp · 第 665–676、690–693 行。
文档不完整时的字段保留
BSON 的 Null、空字符串和字段不存在是三种不同情况。本例的 n 在文档内第 0x1A 字节的位置有类型字节 0A,后面还有字段名 6E 00,因此它是明确保存的 Null。如果值为空字符串,元素就仍使用类型 02,长度字段应为 1,只保留字符串末尾的 00。如果文档根本没有某个字段,就没有该字段的类型字节和名称;不能因为未读到这个名称,就在输出中自行补一个 Null。
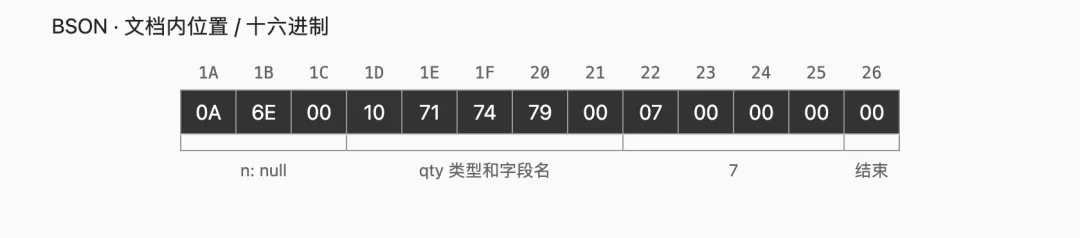
图 1.1-11 Null 元素与后续字段
文件截短会使已经确定的 BSON 长度超过现有字节。作为截短演算,文件只保留到文档内第 0x23 字节的位置,共 36 字节。因为文档声明的长度仍为 39,所以最后三个字节尚未读到。_id、name 和 n 都已完整;qty 的值应占文档内第 0x22 至第 0x25 字节,现在只有其中前两个字节,不能将它们当作完整整数 7。
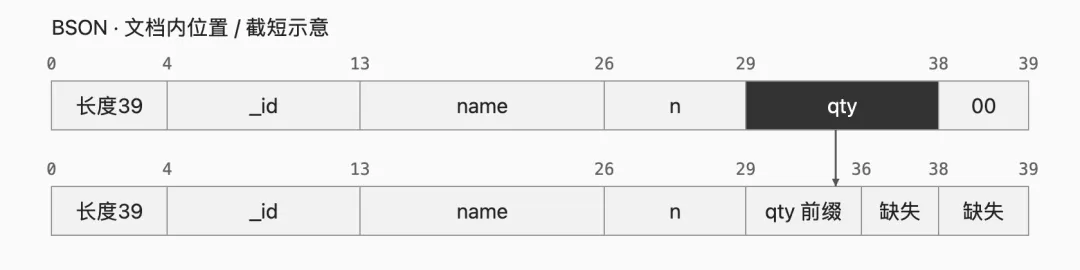
图 1.1-12 截短文档与已读字段
在这种情况下,您可以保留三个完整字段,并记录 qty 缺少文档内第 0x24、第 0x25 字节,文档内第 0x26 字节的结束标志也缺失。原来的 RecordId〔2〕 1、集合文件名、叶块文件内第 0x1000 字节的位置和文档页内第 0x2B 字节的位置应与这些结果一起保存。它们可以用于寻找另一份同记录的材料;已有字段应标为部分文档,不能因为前三个字段看似正常就声称整条 BSON 已通过验证。
字段名中的 00、字符串末尾的 00 和文档末尾的 00 由所在结构区分。您应先按类型与长度移动到下一个元素,再检查最后一个结束字节;不能在文件中碰到任意一个零就结束文档。当长度字段损坏、类型无法解释或字段范围越过外层文档时,应保留当前原始字节和读取位置,等待完整材料或同版本的其他记录。
术语详解
正文中术语首次出现时的编号,对应下方同号词条。
〔1〕BSON
BSON 是 Binary JSON(二进制 JSON)的缩写,用于表示 MongoDB 文档。文档开头的四字节小端整数记录包含末尾零字节的总长度。
每个元素先保存类型和以零字节结尾的字段名,再按类型保存值。字符串值自己的四字节长度包含字符串末尾的零字节。如果记录截断在字符串内,您就可以保留已读前缀并记录缺失字节的位置。
〔2〕RecordId
RecordId 是 MongoDB 在记录存储中定位一条记录的键。普通集合可以使用整数键,聚集集合的记录存储使用字节串键。
RecordId 的编码由存储表的键格式决定。文档中的 _id 是 BSON 字段,普通集合的二级索引可以用 RecordId 查找记录值。