ARTICLE · 1393097
内核源码精读 03 | suspend 与 resume:醒来的路,是睡下去的路倒着走
系列第 03 篇。上一篇我们看 cpufreq 和 thermal 在运行时怎么互相拉扯;这一篇看一个更极端的问题——当整个系统决定睡觉时,内核里发生了什么?以及它醒来时的样子是否和睡下去时一模一样、方向相反?
一、涉及的源码路径
这一篇的主战场非常集中,只有三个文件、一处数据结构:
kernel/power/main.c | /sys/power/state 接口 | |
kernel/power/suspend.c | 主干 | |
drivers/base/power/main.c | dpm_list 链表遍历与驱动回调分发 | |
include/linux/pm.h | pm_message_t |
另外要提前认识两个"名册":
• dpm_list:全系统所有注册过 PM 能力的设备挂在上面,drivers/base/power/main.c管"点名"——谁睡了、谁没睡、按什么顺序• suspend_ops:平台钩子(ACPI / ARM PSCI / SoC 自家代码),内核把"怎么断 CPU 的电"留给平台,自己管流程
读代码的顺序建议:main.c 的 state_store → suspend.c 从上往下通读 → drivers/base/power/main.c 只看 dpm_suspend 和 dpm_resume 两个函数。
动手之前,先看这篇讲的 suspend/resume 在整个电源管理版图里的位置——它是"内核 PM 核心"那条线的系统级出口:
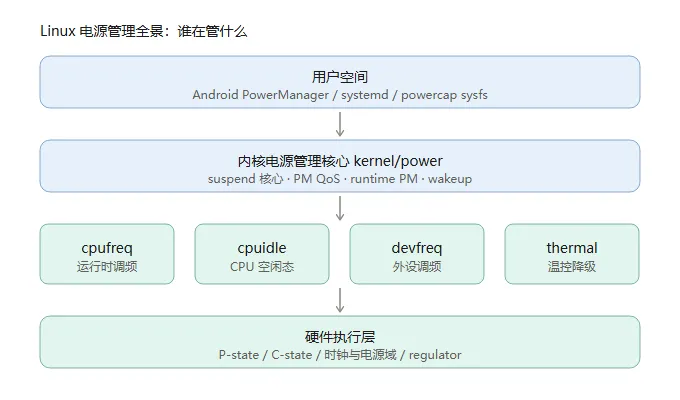
图注:suspend/resume 属于第二层 kernel/power 的核心职能;第三层的 cpufreq/cpuidle/devfreq/thermal 是"醒着时"的日常省电,suspend 是"都闲下来"的终极手段。上一篇的 cpufreq×thermal 拉扯发生在第三层,这一篇进到第二层。
二、流程骨架
先看骨架,再看血肉。整条链可以画成两列——左列睡下去,右列原路返回:
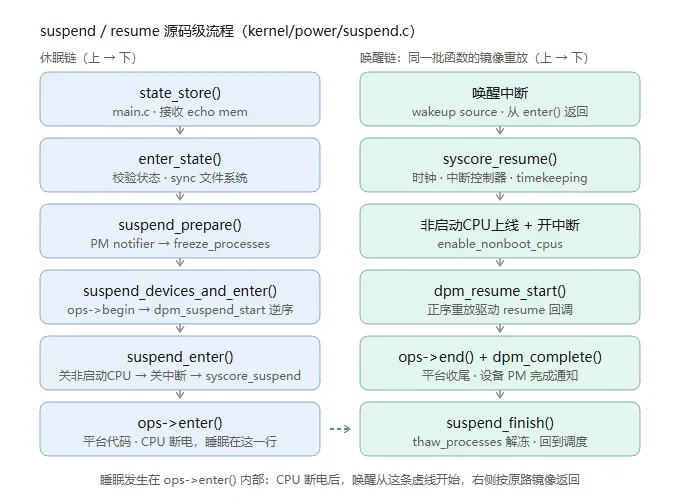
图注:蓝色是休眠链,绿色是唤醒链。睡眠发生在左列最后一格 ops->enter() 内部——CPU 在这行断电,唤醒中断把执行流从这一行原样送回,然后右列从上往下把睡前的每一步倒放一遍。
写成文字版(方便对照源码):
【休眠链:从上往下】

用户态: echo mem > /sys/power/state
  └─ state_store()            main.c     解析目标状态,mem→pm_suspend()
      └─ pm_suspend()         suspend.c  平台入口检查 → enter_state()
          └─ enter_state()               总指挥
              ├─ suspend_prepare()       通知链 → 冻结全部用户进程
              └─ suspend_devices_and_enter()
                  ├─ dpm_suspend_start() 设备逆序逐个睡(含 cpufreq/devfreq 收尾)
                  └─ suspend_enter()
                      ├─ 关非启动CPU、关中断
                      ├─ syscore_suspend()   系统地基最后睡
                      └─ suspend_ops->enter() ★ CPU 在这一行断电

【唤醒链:严格镜像返回】

唤醒中断(已注册的 wakeup source)
  └─ 从 suspend_ops->enter() 返回
      └─ syscore_resume()            地基先醒
          └─ 非启动CPU上线、开中断
              └─ dpm_resume_end()    设备正序逐个醒(cpufreq/devfreq 复位)
└─ suspend_finish() 解冻进程 → 回到调度记住一句话就抓住了全部:睡下去的每一步,醒来时都被原样倒放。
三、源码逐段通读
以下代码全部取自 torvalds/linux 主线(v6.x),逐段加读后感。
3.1 入口:state_store()——一个 sysfs 写入,两条岔路
static ssize_t state_store(struct kobject *kobj, struct kobj_attribute *attr,
               const char *buf, size_t n)
{
    suspend_state_t state;
    int error;

    error = pm_autosleep_lock();
    if (error)
        return error;

    if (pm_autosleep_state() > PM_SUSPEND_ON) {
        error = -EBUSY;
        goto out;
    }

    state = decode_state(buf, n);
    if (state < PM_SUSPEND_MAX) {
        if (state == PM_SUSPEND_MEM)
            state = mem_sleep_current;

        error = pm_suspend(state);
    } else if (state == PM_SUSPEND_MAX) {
        error = hibernate();
    } else {
        error = -EINVAL;
    }

 out:
    pm_autosleep_unlock();
    return error ? error : n;
}

power_attr(state);
读后感:
● 这个函数是 cat /sys/power/state 能看到的接口背后的写回调(power_attr(state) 注册的)。写入 "mem" 走 pm_suspend(),写入 "disk" 走 hibernate()(休眠到盘)——suspend 和 hibernate 在第一个岔路口就分家了,本文只跟左边那条。
● state == PM_SUSPEND_MEM 时取的是 mem_sleep_current——mem 其实是个"模式指针":在 sysfs 的 /sys/power/mem_sleep 里可以在 s2idle(浅睡,现代笔记本和 Android 常用)和 deep(真 S3)之间切换,同一个 "mem",底层可能睡得完全不一样深。
● 开头的 pm_autosleep_lock 是给 Android 式自动休眠(wakeup 计数归零自动睡)留的门,桌面系统不走这条路。
3.2 总指挥:enter_state()——先把自己锁起来
static int enter_state(suspend_state_t state)
{
    int error;

    trace_suspend_resume(TPS("suspend_enter"), state, true);
    if (state == PM_SUSPEND_TO_IDLE) {
#ifdef CONFIG_PM_DEBUG
        if (pm_test_level != TEST_NONE && pm_test_level <= TEST_CPUS) {
            pr_warn("Unsupported test mode for suspend to idle, please choose none/freezer/devices/platform.\n");
            return -EAGAIN;
        }
#endif
    } else if (!valid_state(state)) {
        return -EINVAL;
    }
    if (!mutex_trylock(&system_transition_mutex))
        return -EBUSY;

    if (state == PM_SUSPEND_TO_IDLE)
        s2idle_begin();

    if (sync_on_suspend_enabled) {
        trace_suspend_resume(TPS("sync_filesystems"), 0, true);

        error = pm_sleep_fs_sync();
        if (error)
            goto Unlock;

        trace_suspend_resume(TPS("sync_filesystems"), 0, false);
    }

    pm_pr_dbg("Preparing system for sleep (%s)\n", mem_sleep_labels[state]);
    pm_suspend_clear_flags();
    error = suspend_prepare(state);
    if (error)
        goto Unlock;

    if (suspend_test(TEST_FREEZER))
        goto Finish;

    trace_suspend_resume(TPS("suspend_enter"), state, false);
    pm_pr_dbg("Suspending system (%s)\n", mem_sleep_labels[state]);
    error = suspend_devices_and_enter(state);

 Finish:
    events_check_enabled = false;
    pm_pr_dbg("Finishing wakeup.\n");
    suspend_finish();
 Unlock:
    mutex_unlock(&system_transition_mutex);
    return error;
}
读后感:
● mutex_trylock(&system_transition_mutex) 用的是 trylock 而不是 lock:两个"睡觉请求"同时来,后到的直接返回 -EBUSY 拒绝,而不是排队等第一个醒来——睡眠是全局唯一状态,没有"睡一半再叠一层"。
● sync_on_suspend_enabled:睡之前把文件系统脏页落盘,断电前的最后保险。
● 注意结尾的对称结构:suspend_prepare() 睡前准备 → suspend_devices_and_enter() 进出睡眠 → suspend_finish() 醒后清理,三个函数的失败路径全部汇聚到同一个 Unlock 出口——这是整篇代码都在贯彻的"失败即回退"纪律的第一个样本。
3.3 睡前点名:suspend_prepare()——通知与冻结
static int suspend_prepare(suspend_state_t state)
{
    int error;

    if (!sleep_state_supported(state))
        return -EPERM;

    pm_prepare_console();

    error = pm_notifier_call_chain_robust(PM_SUSPEND_PREPARE, PM_POST_SUSPEND);
    if (error)
        goto Restore;

    filesystems_freeze(filesystem_freeze_enabled);
    trace_suspend_resume(TPS("freeze_processes"), 0, true);
    error = suspend_freeze_processes();
    trace_suspend_resume(TPS("freeze_processes"), 0, false);
    if (!error)
        return 0;

    dpm_save_failed_step(SUSPEND_FREEZE);
    filesystems_thaw();
    pm_notifier_call_chain(PM_POST_SUSPEND);
 Restore:
    pm_restore_console();
    return error;
}
读后感:
● pm_notifier_call_chain_robust(PM_SUSPEND_PREPARE, PM_POST_SUSPEND)——注意是 robust 版本:任何 notifier 回调返回失败,框架自动给所有已收到 PREPARE 的回调补发 POST_SUSPEND,让它们回滚。内核把"通知了就要负责善后"做成了框架行为,不靠每个回调自己小心。
● suspend_freeze_processes() 冻结全部用户进程,这是硬门槛:任何进程停在不可中断状态(典型:等 IO 卡死),冻结失败 → dpm_save_failed_step(SUSPEND_FREEZE) 记录失败步骤 → 反向解冻 → 休眠取消。手机的"灭屏后睡不下去"问题,很多就卡在这一步——查法是看 freezer 超时日志和 /sys/power/pm_wakeup_irq。
● dpm_save_failed_step() 配合 /sys/power/pm_test 可以逐层演练休眠(先只走到 freezer、再走到 devices、再走到 core……),是功耗调试的官方脚手架。
3.4 设备阶段:suspend_devices_and_enter()——睡觉是个循环
int suspend_devices_and_enter(suspend_state_t state)
{
    int error;
    bool wakeup = false;

    if (!sleep_state_supported(state))
        return -ENOSYS;

    pm_suspend_target_state = state;

    if (state == PM_SUSPEND_TO_IDLE)
        pm_set_suspend_no_platform();

    error = platform_suspend_begin(state);
    if (error)
        goto Close;

    console_suspend_all();
    suspend_test_start();
    error = dpm_suspend_start(PMSG_SUSPEND);
    if (error) {
        pr_err("Some devices failed to suspend, or early wake event detected\n");
        goto Recover_platform;
    }
    suspend_test_finish("suspend devices");
    if (suspend_test(TEST_DEVICES))
        goto Recover_platform;

    do {
        error = suspend_enter(state, &wakeup);
    } while (!error && !wakeup && platform_suspend_again(state));

 Resume_devices:
    suspend_test_start();
    dpm_resume_end(PMSG_RESUME);
    suspend_test_finish("resume devices");
    trace_suspend_resume(TPS("console_resume_all"), state, true);
    console_resume_all();
    trace_suspend_resume(TPS("console_resume_all"), state, false);

 Close:
    platform_resume_end(state);
    pm_suspend_target_state = PM_SUSPEND_ON;
    return error;

 Recover_platform:
    platform_recover(state);
    goto Resume_devices;
}
读后感:
● dpm_suspend_start(PMSG_SUSPEND) 把整个设备世界交出去(3.6 看内部),然后才轮到 suspend_enter() 碰 CPU。
● 最有意思的是中间那个 do-while 循环:while (!error && !wakeup && platform_suspend_again(state))——醒来之后,如果平台说"条件还合适",系统可以立刻再睡一次,这就是 SoC 上"反复进出浅睡攒待机时长"的框架支持,wakeup 置位或出错才真正退出循环。
● Recover_platform 标签:设备睡挂了,先请平台抢救(platform_recover),然后仍然走完整条 resume 路径——不是崩溃重启,是把系统原样拉回来。连 printk 的输出终端都要先睡(console_suspend_all),防止睡的过程中串口驱动还在收发。
3.5 深水区:suspend_enter()——关灯前的最后检查
static int suspend_enter(suspend_state_t state, bool *wakeup)
{
    int error;

    error = platform_suspend_prepare(state);
    if (error)
        goto Platform_finish;

    error = dpm_suspend_late(PMSG_SUSPEND);
    if (error) {
        pr_err("late suspend of devices failed\n");
        goto Platform_finish;
    }
    error = platform_suspend_prepare_late(state);
    if (error)
        goto Devices_early_resume;

    error = dpm_suspend_noirq(PMSG_SUSPEND);
    if (error) {
        pr_err("noirq suspend of devices failed\n");
        goto Platform_early_resume;
    }
    error = platform_suspend_prepare_noirq(state);
    if (error)
        goto Platform_wake;

    if (suspend_test(TEST_PLATFORM))
        goto Platform_wake;

    if (state == PM_SUSPEND_TO_IDLE) {
        s2idle_loop();
        goto Platform_wake;
    }

    error = pm_sleep_disable_secondary_cpus();
    if (error || suspend_test(TEST_CPUS))
        goto Enable_cpus;

    arch_suspend_disable_irqs();
    BUG_ON(!irqs_disabled());

    system_state = SYSTEM_SUSPEND;

    error = syscore_suspend();
    if (!error) {
        *wakeup = pm_wakeup_pending();
        if (!(suspend_test(TEST_CORE) || *wakeup)) {
            trace_suspend_resume(TPS("machine_suspend"),
                state, true);
            error = suspend_ops->enter(state);
            trace_suspend_resume(TPS("machine_suspend"),
                state, false);
        } else if (*wakeup) {
            error = -EBUSY;
        }
        syscore_resume();
    }

    system_state = SYSTEM_RUNNING;

    arch_suspend_enable_irqs();
    BUG_ON(irqs_disabled());

 Enable_cpus:
    pm_sleep_enable_secondary_cpus();

 Platform_wake:
    platform_resume_noirq(state);
    dpm_resume_noirq(PMSG_RESUME);

 Platform_early_resume:
    platform_resume_early(state);

 Devices_early_resume:
    dpm_resume_early(PMSG_RESUME);

 Platform_finish:
    platform_resume_finish(state);
    return error;
}
读后感:
● 设备的睡眠其实是三段式——dpm_suspend(普通回调)→ dpm_suspend_late → dpm_suspend_noirq(关中断后还要执行的回调),把"还能睡觉中断的设备"和"必须在中断全关后才能碰的设备"分开处理;层次越多,失败路径的标签越多(看那串 goto,每个对应一段已完成工作的回滚起点)。
最精妙的两行在睡着之前:
    *wakeup = pm_wakeup_pending();
    if (!(suspend_test(TEST_CORE) || *wakeup)) {
        error = suspend_ops->enter(state);
● 断电前的最后一刻,再问一次"有没有唤醒事件挂着?"——有就根本不进 enter,直接返回 -EBUSY 走唤醒路径。这防的是最尴尬的场景:刚关灯就响铃,白关一次灯还多耗一次进出睡眠的动态功耗。写功耗测试用例的人应该认得这个模式:睡前检查、睡后校验,是待机功耗优化的通用骨架。
● syscore_suspend() / syscore_resume() 是地基层(timekeeping、中断控制器根域),没有设备模型身份,单独走 syscore 通道,最后睡、最先醒。ops->enter(state) 前后各一个 trace 点:perfetto trace 里那一段长长的空白,就是这行代码。
3.6 镜像的实现:dpm_suspend() vs dpm_resume()——差两个字
现在回答"为什么醒来和睡下去一模一样、方向相反"。答案在设备点名函数里,把两个函数并排放:
int dpm_suspend(pm_message_t state)
{
    ktime_t starttime = ktime_get();
struct device *dev;
    int error;

    trace_suspend_resume(TPS("dpm_suspend"), state.event, true);
    might_sleep();

    devfreq_suspend();
    cpufreq_suspend();

    pm_transition = state;
    async_error = 0;

    mutex_lock(&dpm_list_mtx);

    /*
     * Start processing "async" leaf devices upfront so they don't need to
     * wait for the "sync" devices they don't depend on.
     */
    list_for_each_entry_reverse(dev, &dpm_prepared_list, power.entry) {
        dpm_clear_async_state(dev);
        if (dpm_leaf_device(dev))
            dpm_async_with_cleanup(dev, async_suspend);
    }

    while (!list_empty(&dpm_prepared_list)) {
        dev = to_device(dpm_prepared_list.prev);

        list_move(&dev->power.entry, &dpm_suspended_list);

        if (dpm_async_fn(dev, async_suspend))
            continue;

        get_device(dev);

        mutex_unlock(&dpm_list_mtx);

        device_suspend(dev, state, false);

        put_device(dev);

        mutex_lock(&dpm_list_mtx);

        if (READ_ONCE(async_error)) {
            dpm_async_suspend_complete_all(&dpm_prepared_list);
            /*
             * Move all devices to the target list to resume them
             * properly.
             */
            list_splice_init(&dpm_prepared_list, &dpm_suspended_list);
            break;
        }
    }

    mutex_unlock(&dpm_list_mtx);

    async_synchronize_full();

    error = READ_ONCE(async_error);
    if (error)
        dpm_save_failed_step(SUSPEND_SUSPEND);

    dpm_show_time(starttime, state, error, NULL);
    trace_suspend_resume(TPS("dpm_suspend"), state.event, false);
    return error;
}
void dpm_resume(pm_message_t state)
{
struct device *dev;
ktime_t starttime = ktime_get();
trace_suspend_resume(TPS("dpm_resume"), state.event, true);
pm_transition = state;
async_error = 0;
mutex_lock(&dpm_list_mtx);
/*
* Start processing "async" root devices upfront so they don't wait for the
* "sync" devices they don't depend on.
*/
list_for_each_entry(dev, &dpm_suspended_list, power.entry) {
dpm_clear_async_state(dev);
if (dpm_root_device(dev))
dpm_async_with_cleanup(dev, async_resume);
}
while (!list_empty(&dpm_suspended_list)) {
dev = to_device(dpm_suspended_list.next);
list_move_tail(&dev->power.entry, &dpm_prepared_list);
if (!dpm_async_fn(dev, async_resume)) {
get_device(dev);
mutex_unlock(&dpm_list_mtx);
device_resume(dev, state, false);
put_device(dev);
mutex_lock(&dpm_list_mtx);
}
}
mutex_unlock(&dpm_list_mtx);
async_synchronize_full();
dpm_show_time(starttime, state, 0, NULL);
if (READ_ONCE(async_error))
dpm_save_failed_step(SUSPEND_RESUME);
cpufreq_resume();
devfreq_resume();
trace_suspend_resume(TPS("dpm_resume"), state.event, false);
}读后感(本篇的核心):
● 方向的实现只需两个字——睡是 dpm_prepared_list.prev(从链表尾部拿设备),醒是 dpm_suspended_list.next(从链表头部拿设备)。同一个链表,遍历方向相反:注册顺序天然形成依赖序(父先于子),睡的时候尾→头(叶子先睡),醒的时候头→尾(父先醒)。没有写两套顺序逻辑,一个链表的两个方向就是全部。
还有一处和上一篇的直接联动,藏在 dpm_suspend 开头:
    devfreq_suspend();
    cpufreq_suspend();
● 整个系统睡之前,governor 先停摆——运行时调频框架自己是被 suspend 流程关掉的(dpm_resume 尾部对称地有 cpufreq_resume())。这解释了一个 trace 现象:睡眠期间 schedutil 完全静默,频率切换事件消失。上一篇讲的"thermal 和 governor 的拉扯"只发生在醒着的每一毫秒;睡前 governor 立刻下岗,约束(QoS)保留、执行者停班。
● 异步优化也值得停一眼:睡之前先扫描叶子设备(dpm_leaf_device,不依赖任何其他设备)提前并发处理,醒的时候对称地先处理根设备——设备多到几千个的现代 SoC 上,这是把 suspend 时间压下来的主要手段。suspend/resume 耗时本身就是功耗优化的 KPI:进睡眠慢,动态功耗白烧。失败路径依旧贯彻"全部转正再回滚":async_error 一旦置位,把剩余设备全部移入 suspended_list,保证 resume 时一个不漏地被唤醒。
3.7 收尾:suspend_finish()——解冻,回到人间
static void suspend_finish(void)
{
    suspend_thaw_processes();
    filesystems_thaw();
    pm_notifier_call_chain(PM_POST_SUSPEND);
    pm_restore_console();
}
读后感:
● 四行对应 3.3 节的四行,严格对仗——解冻进程 ↔ 冻结进程、解冻文件系统 ↔ 冻结、PM_POST_SUSPEND ↔ PM_SUSPEND_PREPARE、恢复控制台 ↔ 准备控制台。
● 这里能看清整篇的结构美学:enter_state 三段、suspend_prepare 四行、dpm_suspend/resume 两列、suspend_finish 四行,每一层都是"原路镜像"。这不是巧合,是内核对"全局状态转换"的标准设计姿势:先建立对称,再填内容。
四、设计结论
1. 镜像式状态机:suspend/resume 共用一份设备链表、一套回调、两条遍历方向。对称性不是事后保证的,是结构自带的——"醒来的顺序"根本不存在另一份代码 2. 失败即回退,回退即复用:任何一步失败,不做专门的"恢复逻辑",直接走正常 resume 路径。代码量减半,且恢复逻辑永远和成功路径一样被测试到 3. 睡前最后一刻的检查: pm_wakeup_pending()放在最深处、断电前一瞬。省电优化的黄金位置往往就是这种"最后半步"——不白睡一次4. 分层收权:进程 → 文件系统 → 设备 → CPU → 中断 → 地基(syscore)→ 平台,一层层收,醒的时候一层层还。和第 01 篇 reboot 的"逐层下线"是同一套哲学:内核关机/休眠类流程,都是有序地放弃控制权
本文结构与分析由作者构思,源码与资料由 AI 辅助整理,全部内容经作者逐段核对。