ARTICLE · 1393197
全球 4 成大模型下载来自中国,开源到底赢在哪

打开应用商店或者 AI 工具榜,你会看到一串名字:DeepSeek、通义千问、豆包、Kimi、智谱、MiniMax……
名字一大堆,长得都差不多,你是不是也分不清谁是谁?
国产大模型这一年真正的变化,不在某个模型又刷新了什么榜单,而在两条主线:一是集体转向一种叫 MoE 的省钱架构,二是在开源这条路上跑成了全球最活跃的玩家。看懂这两条,那一堆名字就理顺了。
主线一:从"越大越好"到"越高效越好"
前几年比模型,比的是参数。谁的参数多,谁就牛。
现在风向变了。央广网在年初的行业观察里总结得很清楚:MoE、多模态、超长上下文,几乎成了国产模型的标配;评估标准也从"参数越大越好",转成了"运行越高效越好"。
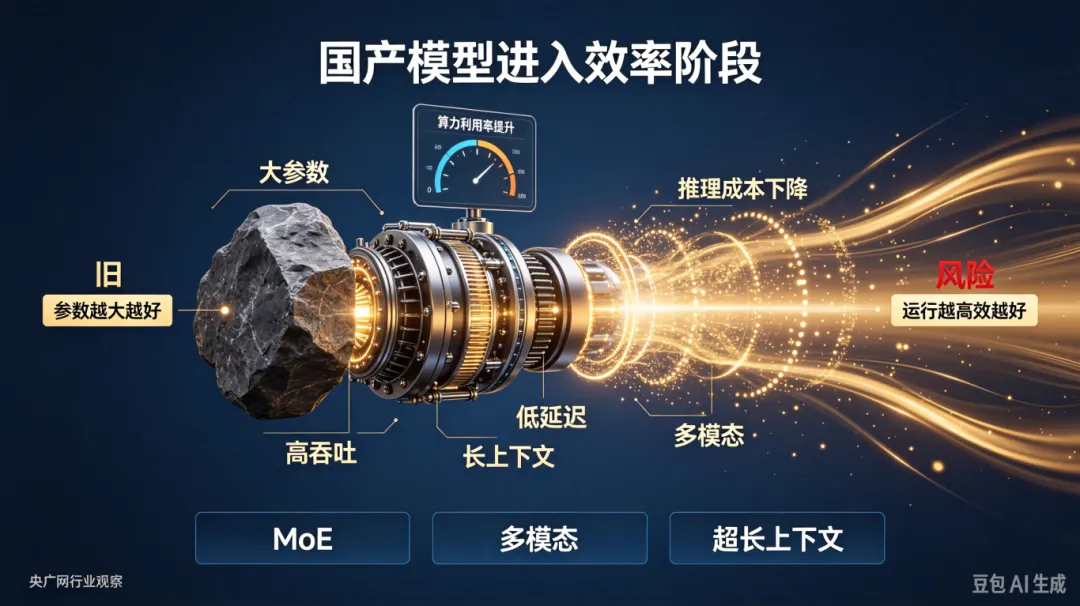
MoE,它的思路是,模型里养着一大群"专家",但每次干活只叫醒最相关的那一小撮。一个形象的比喻是:一家公司有一两百个专家顾问,开会时只叫最懂当前议题的几个人,而不是把所有人都拉进会议室。
这么干的好处特别实在:知识容量还是那么大,但每次推理算的活儿少了很多,成本和速度一下就优化了。
据公开报道,国内几家头部厂商,无论是做通用模型还是做代码、长文本,基本都往这个架构上靠。大家心照不宣:堆参数的时代过去了,拼效率的时代来了。
主线二:开源,跑成了全球第一梯队
第二条主线更值得说道,就是开源。
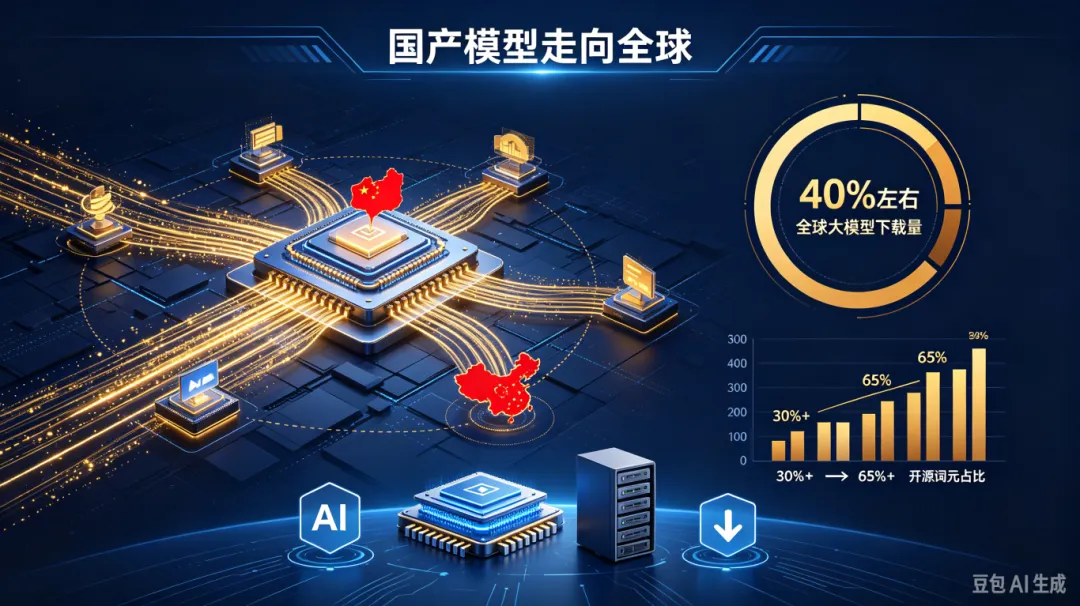
这里有个数字挺提气的。有行业报告提到,全球大模型下载量里,有相当大一部分来自中国研发的模型,比例约在四成上下。还有平台数据显示,开源模型处理的词元占比,从年初的三成多,一路涨到年中的六成半。
也就是说,全世界的开发者在用、在下载中国开源的模型。这事的意义,比某个榜单第一名大得多。因为它意味着影响力,别人是在你的地基上盖房子。
开源为啥这么重要?因为它不只是"免费"这么简单。
第一,它让全世界开发者帮你找问题、提改进。用的人越多,反馈越多,模型迭代越快,这是个正循环。有报道就提到,中国模型团队借此拿到了海量真实场景的反馈数据。
第二,它降低了门槛。中小企业、个人开发者不用从头训练,拿开源模型改改就能用。这让 AI 真正普及到长尾的地方。
第三,它方便"自己掌控"。对有些行业来说,数据不能出公司内部,那开源模型就特别合适,拿来自己部署,数据安全感强。
具体的模型参数、版本号、榜单名次,我这里就不一一报了,那些数字变得太快,今天记明天就可能过时。你只要记住这个大方向:国产模型这一年,在开源上确实跑出来了。
份额和用户,也在起变化
光说开源有点虚,再看点实在的,看看市场份额和普通用户的变化。
有报告显示,在国内的市场份额上,几家头部厂商你追我赶,通义千问、豆包、DeepSeek 都占了不小比例。用户这头,某平台的数据显示,豆包的月活用户数断层领先,通义千问和 DeepSeek 紧随其后。
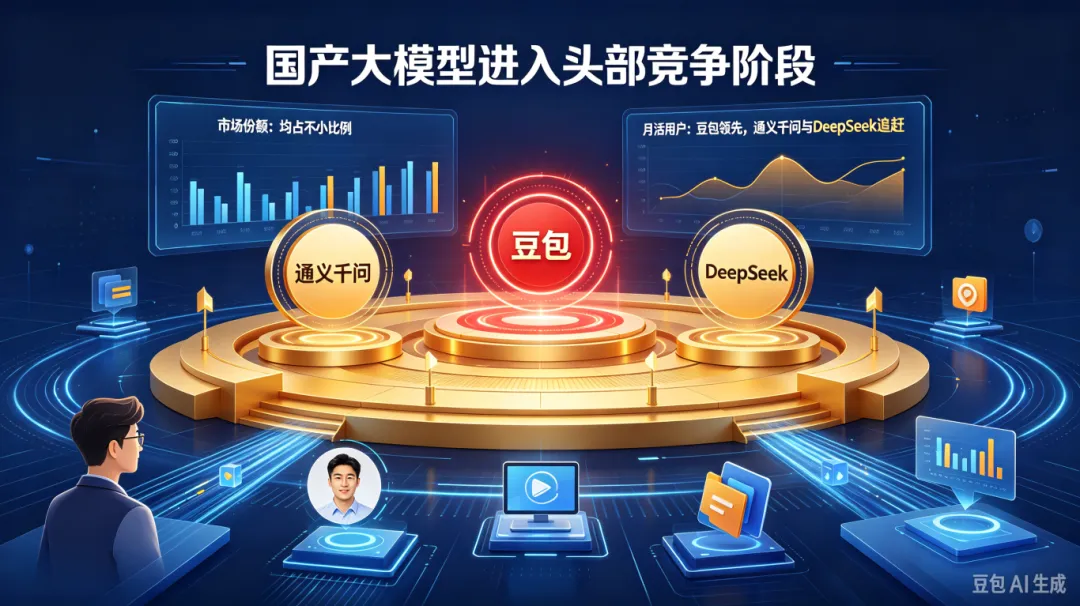
这些数字你不用记具体多少,看个趋势就行:国产 AI 应用,已经走进了几亿人的日常。它不再是极客圈子的玩具,而是普通人手机里的常用工具。
还有个细节挺关键。据报道,国产模型普遍在深度适配国产算力。软硬一起优化,这事短期看不出啥,长期看是要紧的。它意味着整套链条更可控,不容易被卡脖子。
这对普通人有啥好处
说了这么多行业的事,落到你身上,到底有啥用?
最直接的一条:更便宜。国产模型把价格打得很低,你用 AI 的成本在实打实地降。以前要花钱买的东西,现在很多免费或者几毛钱就能用。
第二条:更好用。竞争激烈,逼着各家把中文能力、本地场景做得越来越好。你用中文问问题、处理中文材料,体验比早年强太多。
第三条:更多选择。开源生态繁荣,意味着你不只有"大厂 App"这一个选项。想要隐私,可以自己部署;想要省钱,有各种轻量版本;想要专精,有针对特定场景的模型。
第四条,也是隐性的:底气。整个生态起来,不是一家两家强,而是一片强,这对咱们是好事。
最后说点实在的
国产大模型这一年,热闹在表面,主线在底下。表面是名字一大堆、发布一个接一个;底下是两条清晰的路,一条用 MoE 把效率提上去,一条用开源把生态做大。
那个"全球四成下载来自中国"的数字,是这两条路交出的答卷。它说明中国 AI 已经不只是"跟跑",在开源这个战场上,是实打实的领跑者之一。
作为普通人,你不用分清每个模型有啥区别。你只要知道:你手边这些越来越便宜、越来越好用的 AI 工具,背后是一整个正在快速崛起的生态。
而这场竞赛越激烈,最后受益的,终究是每一个用它的人。