 夜雨聆风
当"让 AI 写代码"从猎奇变成日常,下一个问题来了:它能不能独立干完一整票活?
你有没有发现一个变化?
半年前,"让 AI 帮我写代码"还是个值得发朋友圈的事情。现在?它已经变成了打开电脑后最自然的第一个动作。
Cursor 的爆火, Windsurf 的追赶, Cline 的死忠粉,还有一大堆不知道名字的 AI 编程工具——它们都在解决同一个问题:把你的想法变成代码。
这个问题, 2026 年已经基本解决了。
但新的问题浮出水面:
当任务不再是"写一个函数",而是"从零搭建一个项目,调试三天,推翻重来,再调试"——AI 还能跟得上吗?
一个被忽略的瓶颈
很多人的体验是这样的:
简单任务, AI 又快又好。写个 API 、改个 bug 、写个测试——咔咔咔就完事了。
但一旦任务变得复杂,需要多步推理、反复试错、中途调整策略……大多数模型会在 20 到 30 轮之后开始"变钝"。
具体表现为:重复之前的方案、忽略你最新的反馈、在错误方向上越走越远、或者干脆给出一个"差不多就行"的答案。
这不是工具的问题。这是模型的问题。
所有主流模型都有这个毛病——Claude 有, GPT 有, Gemini 有,之前的 GLM-5 也有。
GLM-5.1 的答案
4 月 3 日,智谱 AI 开源了 GLM-5.1 。 753B 参数, MoE 架构, MIT 协议,中英双语。
如果你只看 benchmark 表格,它确实很强: SWE-Bench Pro 58.4%(开源第一), Terminal-Bench 63.5%, CyberGym 68.7%。但这些不是最 interesting 的部分。
最 interesting 的是:智谱说这个模型"跑得越久越好"。
这不是营销话术。他们观察到的一个现象是——之前的模型在 Agent 任务中会快速消耗掉自己的"套路储备",然后进入平台期。给更多时间,不会变得更好,只是浪费更多 token 。
GLM-5.1 的改进方向是:在长周期任务中,让模型持续保持有效判断。
怎么做?几个机制:
学会"回头看"。 做了几步之后,不是闷头继续,而是重新审视自己的推理过程,看看有没有忽略的线索。
学会"认错"。 发现当前方向不对时,不是硬撑,而是主动切换策略。
学会"拆问题"。 遇到大问题,先分解成小问题,逐个击破,而不是一口吞。
学会"用结果"。 每一步的结果不是执行完就丢,而是作为下一步决策的依据。
听起来都很基础对吗?确实基础。但在一个需要跑几百轮、调上千次工具的真实工程任务里,能持续做到这些基础的模型,目前凤毛麟角。
一些值得记住的数字
不堆砌,只给你几个关键数据点:
代码工程——GLM-5.1 的主战场:- SWE-Bench Pro 58.4% → 超过 Claude Opus 4.6 和 GPT-5.4- CyberGym 68.7% → 比 GLM-5 提升了 20 个点- Terminal-Bench 63.5% → 比 GLM-5 提升了 7 个点
传统推理——够用但不拔尖:- AIME 2026 : 95.3%- GPQA-Diamond : 86.2%
许可证——可能是最被低估的亮点:- MIT 协议,无任何附加条款
关于许可证,多说两句
在开源大模型领域, MIT 正在变成稀缺品。
Llama 系列有 LLaMA License , Qwen 有自己的许可协议,很多模型在"开源"的同时附加了使用场景限制。
GLM-5.1 是纯粹的 MIT 。商用、修改、再分发、嵌入产品——没有限制。
对个人开发者来说,这意味着你可以自由折腾。对企业来说,这意味着法务部门不会找你麻烦。
在 2026 年,"真正的开源"比"更强的模型"更难得。
部署:没你想的那么难
753B 参数听着吓人,但 MoE 架构每次只激活一部分参数。再加上多种量化方案,实际门槛并不高:
框架支持也很全面: SGLang 、 vLLM 、 Transformers 、 KTransformers 都已适配。你现有的 LLM 基础设施基本可以直接复用。
一个更深的思考
GLM-5.1 让我想起了一件事。
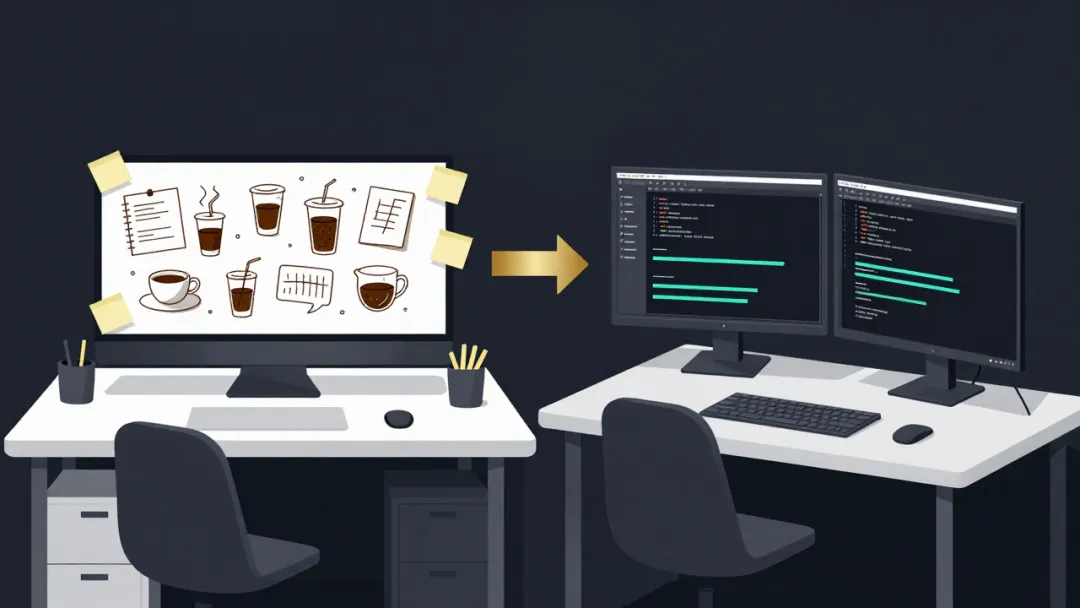
一年前,我们讨论的还只是"AI 能不能写代码"。半年前,变成了"AI 写的代码能不能用"。现在,问题变成了"AI 能不能独立完成一个复杂工程任务"。
这个演进方向,其实就是智谱说的"Vibe Coding → Agentic Engineering"。
Vibe Coding 是什么?就是你描述一个大致的想法, AI 帮你快速出原型。很爽,但只适合简单的、短周期的任务。
Agentic Engineering 是什么?是你给 AI 一个目标,它自己分析需求、设计方案、写代码、调试、测试、迭代,全程不需要你手把手。
Vibe Coding 是 2025 年的故事。 Agentic Engineering 是 2026 年的战场。
GLM-5.1 不是第一个站上这个战场的,但它可能是目前准备得最充分的——至少在开源阵营里。
值得关注,但不急于下结论
几个客观的建议:
✅ 如果你在评估 AI 编程方案, GLM-5.1 值得放入候选名单。它在代码工程和长周期任务上的表现确实突出。
✅ MIT 协议是加分项。对于有合规顾虑的企业,这可能是一个决定性因素。
⚠️ 但不要急于替换现有方案。模型发布仅一周,缺乏独立第三方验证。
⚠️ "长周期有效性"是一个正确但尚未被充分验证的主张。建议在自己的实际场景中跑一跑再判断。
vibe coding 是入门, agentic engineering 是正题。 GLM-5.1 是这个正题里,目前开源阵营交出的一份不错的答卷。