 夜雨聆风
如何对AI编程的效果进行度量?这个问题一开始以为很简单——看看代码量涨没涨、合入快不快、工时少没少不就行了。
这篇就聊聊我的一些思考。
先看一组让人"分裂"的数据
先从这几组数据说起:
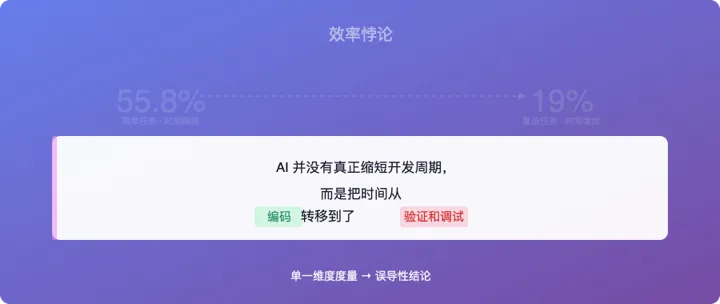
- 简单任务
:完成时间减少 55.8%(GitHub Copilot RCT 2023) - 复杂任务
:完成时间反而增加 19%(METR RCT 2025) 超过 45% 的开发者认为调试AI生成的代码比调试自己的代码更耗时
是不是很分裂?
同一个工具,简单任务直接起飞,复杂任务反而把你拖慢。这不是哪个工具的问题——AI编程本身就存在一个结构性矛盾。
我们把这个矛盾叫做"效率悖论":
**AI并没有真正缩短开发周期,而是把时间从"编码"转移到了"验证和调试"。**
传统开发大概 6:4 的编码:调试比例,被AI彻底打破了。
但最致命的问题不是数据本身,而是——
如果只用"代码量"或"提交速度"来度量AI的价值,你会得出完全错误的结论。
这就是我们踩的第一个坑。
坑一:我们差点被"工时"骗了
一开始,我们的度量思路很朴素:"AI让开发变快了,那我们就量开发时间呗。"
大家看了几周的数据,很满意——"开发人员工时提效30%,不错!"
但慢慢地,不对劲的事情开始浮现:
工时提效涨了30%,但文档覆盖率反而下降了40%。 新人上手周期不降反升。随之而来的是我们担心在AI coding流程下,文档不全了、细节把控的少了、开发人员对于系统代码的掌握度变差了,那么线上故障的恢复时间(MTTR)会不会因此反而增加了。
问题出在一个经典的经济学定律上——古德哈特定律:
当一个指标成为目标时,它就不再是一个好指标。
简单说:我们盯着"工时"去度量,所有人的行为就会扭曲成"看起来省时"的样子——代码能跑就行,注释不写了,设计文档不补了,反正省下来的时间就是"成绩"。
这种扭曲层层传导:
- 表层
文档和知识沉淀流失。新人看不懂AI生成的代码,上手反而更慢。 - 中层
开发者的细节把控力下降。很多人从"设计者"退化为"审核者"——AI写的代码大致方向对,细节经常出问题,但大家看到"能跑"就合入了。 - 深层
系统可维护性系统性衰退。技术债务在无声积累,代码库变成"能跑但没人能全懂"的状态。
教训很痛:单一的"工时节省"指标,会掩盖AI带来的隐性代价。
这不是AI的问题,是度量体系的错。
坑二:我们试图用一把尺子量所有人
踩了第一个坑后,我们开始建更复杂的指标。但紧接着犯了第二个错误——
我们做了一个大而全的指标排行榜,打算全团队推广。
结果呢?
个人看到自己的AI采纳率排名靠后,开始"刷数据"——为了用AI而用AI,明明自己写更快也要硬套AI 团队之间开始横向对比,有的组因为业务复杂,AI代码接受率天然低,被"亮红灯"
这个教训让我们重新思考一个根本问题:
度量到底是为了什么?
不是为了排名,不是为了奖惩,而是为了诊断和改进。
于是我们重新思考了整个框架,对于个人度量,是否应该“三不”:
1. 不与绩效直接挂钩
2. 不做跨团队横向对比
3. 不用单一指标排名
同时把度量体系分成了三个层次,越往上权重越大:
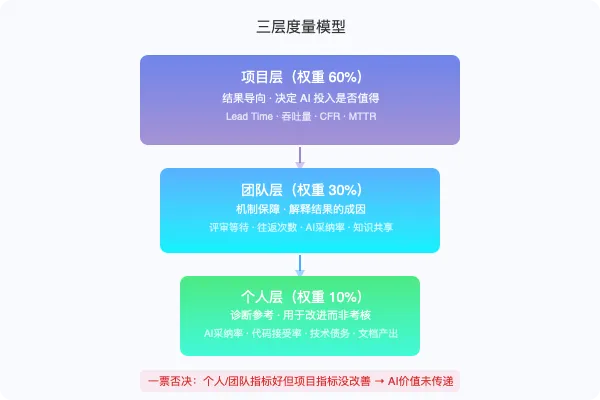
最关键的底线是:如果个人和团队指标都好看,但项目层的关键指标没改善,说明AI价值没有传递到交付层面。这种时候,一票否决。
坑三:我们忽略了"验证负担"这个隐形杀手
第三个坑来自一个很日常的场景。
有一天团队里一位资深工程师跟我说:"我用了AI以后,写代码确实快了,但我总觉得比原来更累了。"
这句话让我愣了一下。仔细一聊才发现,他的感觉不是错觉——
之前写一个功能模块,他自己写,边想边写,写完跑一下,过了就过了,不过修一下。
现在呢?让AI生成代码,他要:
1. 花时间构思提示词
2. 等AI输出
3. 逐行检查AI的代码有没有"翻车"
4. 修改那些"几乎正确但不完全对"的部分
5. 再检查一次
每一步看似不费事,但累加起来,验证和调试的时间已经悄悄超过了编码本身。
我们把这种隐形成本叫做 "AI验证负担"。
为了量化它,我们设计出一个公式,姑且叫它 AVBI(AI验证负担指数):
**AVBI = 0.4 × 返工率 + 0.35 × 调试耗时比 + 0.25 × 提示词迭代次数**
这个指数不是用来考核的,而是用来自我诊断的——如果你的AVBI持续偏高,说明当前任务不适合用AI,或者你的提示词策略需要优化。
兜兜转转,我们最终画了一张五维表
踩完这三个坑,最终沉淀出一个 "五维平衡度量体系":
| 交付效率 | |||
| 交付质量 | |||
| 验证负担 | |||
| 代码健康 | |||
| 知识沉淀 |
以及我们最看重的五大设计原则:
1. 效率和质量并重 — 不为了效率牺牲质量
2. 显性和隐性兼顾 — 不仅看省了多少时间,还要看增加了多少验证负担
3. 短期和长期平衡 — 技术债务和知识沉淀是长期指标,防"短期提速、长期还债"
4. 个人和系统分层 — 越往上权重越大,避免个体最优但系统最差
5. 护栏一票否决 — 质量恶化时,效率提升也不算有效
还有一个容易被忽视的基础设施
在落实这一切之前,有一个前提需要达成——
代码来源标记。
没有它,你根本分不清哪些代码是AI生成的、哪些是人写的。圈复杂度没法对比、缺陷密度比算不出来、AI代码覆盖率也无从谈起。
我们最终的做法很简单:在Git commit和PR上打标签,标记哪些代码由AI辅助生成。听起来很基础,但这件事不做,后面的所有分析都是空中楼阁。
写在最后:度量不是目的,洞察才是
回头看这三个坑,学到了一件事:
度量AI编程的价值,不是在证明"AI很好"或者"AI不好",而是在回答"AI在什么场景、对什么人、产生什么影响"。
没有一套万能指标。
我们的五维框架和AVBI指数,也只是现阶段最接近我们认知的东西。随着团队使用AI的深度变化,这些指标一定会需要迭代。
但这五个原则,我觉得应该不会变:
效率、质量、健康、负担、知识——五个维度,缺一个,都算不上一份合格的答卷。