ARTICLE · 988891
端侧AI多平台迁移:换块板子不是"再转一次"——守住 ONNX 中间层,让迁移成本可预估
端侧AI多平台迁移:换块板子不是"再转一次"——守住 ONNX 中间层,让迁移成本可预估
序 曲
一树生千枝
各自向长空
换土复栽时
方知根最重
根若扎得浅
移栽俱成空
同一个模型换一块板子,你以为"再转一次"就好了。结果 RKNN 能转、NCNN 转不了、地平线干脆让你把算子一起重写。多平台迁移的成本,从来不在"转换"那一步,而在"每个平台都不完全一样"。
先抛三个反直觉的事实:
1. 转换脚本通常只要几分钟,真正的大头是"某个平台不支持的算子"。 你只要有一个自定义算子或冷门算子,第 2 块板子不是"多转一次",而是把这个算子再做一遍——N 个平台就是 N 份实现,不是 1 份。
2. 支持的平台越多,能"白跑"的算子越少——这是交集,不是加法。 平台 A 和平台 B 各自支持的算子都不少,但两个集合的交集往往比单边小一圈;你把模型喂给 3 个平台,就得保证它落在三家都认识的交集里。
3. 同一个 INT8 配方,在不同平台落地的精度能差出约 1~2 个点(估算)。 量化从来不是"一次校准、处处生效"——每个平台的 per-channel 支持、默认标定方式、BN 折叠时机、layout 都不一样,精度只能逐平台去验、去调。
这篇文章给你三样东西:公式(迁移成本到底怎么算)、表(典型工具链的算子脾气)、纪律(怎么守 ONNX 中间层,让换板子的成本变成可预估的账)。
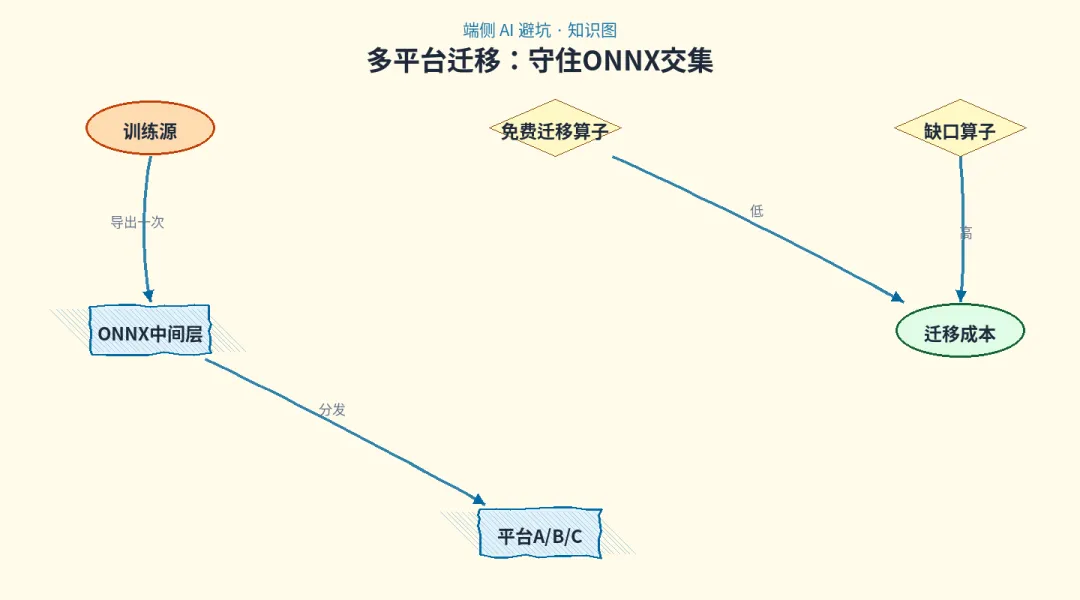
01 多平台迁移,搬的从来不是"模型",是"交集"
先画一幅迁移图。多平台迁移有两种形状:
PyTorch / 训练
│ 导出一次
▼
ONNX 中间层(唯一公共底座)
┌────────────┼────────────┐
▼ ▼ ▼
RKNN NCNN 地平线 / 昇腾
板子 1 板子 2 板子 3
这叫星形:一个源、多片叶子,每片叶子只依赖同一份 ONNX 图。它的反面是链形:先把 ONNX 转成平台 A,再拿平台 A 的结果去喂平台 B(有时候是因为某家工具链只吃特定格式)。链形会把成本和误差一路往前拖——平台 A 的坑还没填完,平台 B 又叠一层。
所以多平台迁移的第一个判断,是你到底在走星形还是链形。星形的前提,就是你守住了 ONNX 这个中间层。
一个公式:成本集中在哪
这是全文最核心的一支笔账:
免费迁移算子集 = ∩_i(平台 i 的算子支持集)
缺口算子集 = 模型用到的算子集 − 免费迁移算子集
迁移成本 ∝ Σ_平台(缺口算子在该平台的处理成本)
• "免费迁移算子":每个平台都认识的算子,转过去基本不用动,成本几乎为零。
• "缺口算子":至少有一个平台不认识。它才是搬家的真正成本。
成本全部集中在交集之外。 模型落在"全平台交集"里的算子越多,迁移越便宜;落在交集外的算子越多,每加一个平台,就要把这些算子再处理一遍。这就是为什么"从 2 平台到 3 平台"不是 +50% 的工作量,而是可能翻倍。
迁移成本阶梯:模型站在哪一级
第一句话就点破:换板子是"交"的问题,不是"转"的问题。 你先回答"我的模型站在哪一级",迁移成本心里就有数了。
02 一张表看懂典型工具链的"脾气"
每家工具链的算子支持、shape 要求、量化默认值都不一样。下面是一张实践观察(估算)的表——不是精确规格,是"你会撞上的典型脾气",以你们实际工具链版本为准。
三个"脾气"要点
1. 动态 shape 是跨平台重灾区。 每家把动态退化成静态的策略不一样:有的补 batch、有的复刻多档、有的要求你显式给多档输入。你在一家调通的动态策略,搬到另一家要重新来一遍。
2. 量化默认值各不一样。 per-channel 开不开、是不是 W8A8、支不支持混合精度、默认标定用最小/最大还是分位数——一家一套。同一份校准数据,喂给三家得到的量化结果不同。
3. 自定义算子生态,一家一个深圳。 每家一套 SDK、一套注册方式、一套 simulator 比对、一套真机验证。写一次,只能在一个平台用。
这张表给你一个直觉:"能用"和"三个平台都能用",中间隔着一整个交集。 你的目标不是让模型在某一家好用,而是让它落在"三家都认识"的集合里。
03 三笔真正的成本账
"换个平台"听起来像个动作,其实是三笔独立的账:
迁移总成本 ≈ Σ_平台 [ 接入成本 + 算子缺口成本 + 量化对齐成本 + 验收回归成本 ]
三笔成本驱动
| 算子覆盖差 | |||
| 量化策略差 | |||
| 第三方依赖差 |
第一笔:算子覆盖差——一个算子 × 平台数
这是最主要的一笔。一个缺口算子,在平台 A 你走"融合",在平台 B 可能只能"CPU fallback",在平台 C 干脆"自研"。所以成本不是"一个算子处理一次",而是"一个算子 × 每个平台各处理一次"。回 03.5 里说的决策顺序(融合 → fallback → 换结构 → 自研),在跨平台时要针对每个平台各走一遍。
第二笔:量化对齐差——只能用"最差平台"当基准
回 02 那篇:量化掉的精度跟标定数据、敏感层、per-channel 强相关。但跨平台时你还会遇到一个新坑——同一个配方,三家落地精度不一样。 你没法拿"精度最好的那个平台"去买单,因为你最终交付的是"三块板子都得达标"。
所以跨平台量化的正确姿势是:
1. 统一一份标定数据,不要给每个平台单独找一份。
2. 先跑三家各自的"默认量化",看精度分别掉多少。
3. 以精度最差的那个平台为基准,做敏感层保护、per-channel、混合精度(回 02 的方法)。你在好的平台上的优化,到差的平台可能不成立。
这一步很多人偷懒:"我在 RKNN 上调好了,直接转给别的平台就行。"——结果在最后一个平台崩掉,前面全白干。
第三笔:第三方依赖差——最隐蔽的一笔
这是最容易被忽略、也最耗时的。PyTorch / ONNX / opset / pip 环境版本一变,导出的图写法就变。某家工具链要 opset 11,另一家要 17;一家转换脚本里装的 numpy 是老版本,另一家一跑就报错。跨平台时,"环境漂移"再叠上"平台差异",排错成本直接翻倍。
解法就是 03.7 那套:每平台一根独立的版本线 + 一份能一键重放的转换脚本 + 一份最小回归集。 别指望一套环境打天下。
04 一个案例:三平台,"放任" vs "守纪律"
以下数字为示意,量级按端侧项目里多平台迁移的常见情况构造;过程能复现,数值不必当真。
项目:一个要卖给三块板子的通用检测盒子,模型 YOLOv8s。目标平台:RK3588、征程 5、Jetson Orin Nano。
方案 A(放任)
工程师觉得"一步到位",模型里加了一个 DCN 提精度、输入走动态尺寸、预处理用了个冷门的 torchvision 变换直接塞进 ONNX、NMS 也放进图里。
| 合计约 6~10 人周 |
方案 B(守纪律)
先用一天把模型"收拾到 ONNX 中间层里":
• 把 DCN 换成一个可由普通卷积 + 注意力替代的模块(精度接近),或把 DCN 部分留在独立的"适配层",方便逐平台 fallback;
• 固定 640×640,动态输入退化成明确的多档静态(回 03.4);
• 预处理、后处理(letterbox / 归一化 / NMS)全放 CPU,不塞进 ONNX 图;
• 只用常见算子;锁 opset + 锁 torch / onnx 版本,保留一份"标准图";
• 统一一份标定数据。
| 合计约 2~3 人周,新增一个平台 ≈ 0.5 人周 |
结论
方案 A 多花在"模型自由发挥"上的爽感,到多平台全还回去。方案 B 用 1 天把模型扳回交集,后面每个平台都是"转 + 量化 + 回归"的固定动作。
迁移成本要可预估,就得先控制住"模型离全平台交集有多远"这个变量。 距离越远,账就成了"每个平台 × 每个缺口算子",怎么估都会超。
05 守住 ONNX 中间层:八条纪律
把成本压下去,靠的不是遇到问题再修,而是从一开始就让模型站在"全平台交集"里。八条纪律,逐条过:
1. 锁 opset 和 torch / onnx 版本,用 CI 出一份"标准图"。升级走 03.7 那套回归,别让 PyTorch 偷偷改图。
2. 只用常见算子。 冷门算子先到"目标平台交集"里核一下,再写进模型。
3. 固定 shape。 动态输入退化成明确的多档静态(回 03.4)。每家一套,别赌。
4. 冷门模块做成独立"适配层"。 让它在主图之外、可以整体替换,给每个平台留 fallback 口,而不是织进主图里。
5. 预处理 / 后处理(letterbox / 归一化 / NMS)放 CPU,别塞进 ONNX 图。这一步能躲掉一大半跨平台差异。
6. 统一一套标定数据,先跑各家默认量化。 拿精度最差的那个平台当基准,做敏感层保护(回 02)。
7. 每平台一根版本线 + 一份转换脚本 + 一份最小回归集(回 03.7)。别混着用一套环境。
8. 验收用同一批固定输入 + 同一套指标,跨平台横向对比。 别各平台各说各话,否则你永远比不了"哪块板子最差"。
06 自检清单
决定"要不要再对一个平台"之前,先过一遍:
☐我的模型只用常见算子吗?冷门算子在目标平台交集里核过吗?
☐我锁了 opset 和 torch / onnx 版本,并保留了一份"标准图"吗?
☐输入 shape 是固定的,或退化成明确的多档静态吗?(回 03.4)
☐冷门模块做成了可整体替换的适配层,能给每平台换 fallback 吗?(回 03.5)
☐预处理 / 后处理都放 CPU,没进 ONNX 图吗?
☐用的是同一套标定数据,先跑各家默认量化,再在最差平台做敏感层保护吗?(回 02)
☐每个平台都有独立的版本线 + 转换脚本 + 最小回归集吗?(回 03.7)
☐验收用同一批固定输入 + 同一套指标,跨平台横向对比了吗?(回 03.8)
☐新增一个平台前,我估过"每平台固定成本 + 缺口算子成本 + 量化对齐成本"吗?
附:关键数字速查表
换板子,换的不是模型,是交集。转换脚本几分钟就完事,真正的成本在"某个平台不认识的算子"和"每个平台不一样的量化"里。守住 ONNX 中间层,让模型站在全平台交集里,迁移这件事才会从"每次从头踩坑"变成"可以预估的一本账"。
下期预告
工具链自检清单:上线前逐条过,别替工具链背锅
模型能转、能跑、精度也还行,你以为就稳了?工具链给过的"假阳性"——转换成功但算子做错、simulator 通过但真机崩、版本一升全作废——往往在最后一刻才爆。下一篇给一份上线前逐条过的自检清单,把工具链的锅和你的锅分清楚。