ARTICLE · 994498
装进 AI 助手的技能,可能是木马?一条命令 28 秒给技能做安全体检
你给 AI 助手装过技能或插件吗?大概率装过,而且不止一次。
问题来了:你装进去的,真的只是一个贴心的功能吗?它可能是一匹木马。有人的 AI 技能被悄悄劫持,指令被改写,密钥被偷偷打包外传,等发现时,机密早就出了境。
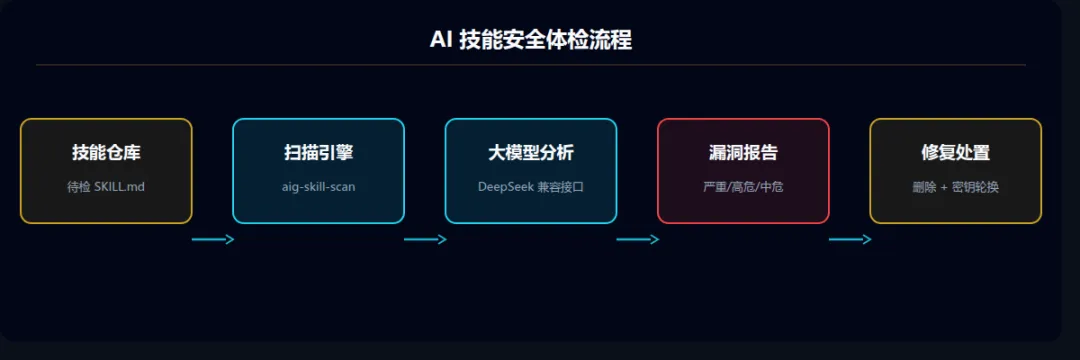
现在,给 AI 技能做一次安全体检,像给电脑装杀毒软件一样,只需要一条命令,28 秒出结果。腾讯朱雀实验室开源了 AI-Infra-Guard,其中 `aig-skill-scan` 正是干这活的。
这篇文章,用 3 个真实的技能测试库,带你从建环境、配 key 到看懂报告,完完整整跑一遍。丑话说在前:这不是劝退教程,是给每个信"AI 插件"的人补齐的一堂安全课。
这个体检有多快?先看 4 个数字
动手之前,先让大家对这事有多"重"有个概念。看下面这张表,全是我们 2026-08-29 本机实测的真实数据,不是 PPT 里的理想值。
这 4 个数字,翻译成人话就是:技能体检真的能跑,而且真能发现问题。不折腾不墨迹,一分钟内你把 AI 插件的关键风险盘了一遍。前提是,你自己愿意动手做这一分钟。
顺带说一句背景:AI-Infra-Guard v4.6.0 还在持续更新,也就是说这不是个半成品玩具,是有人认真在维护的正式工具。你花在上面的时间,多半不会打水漂。
你以为的"装技能",实际是什么?
先破除一个最要命的错觉。很多人对"技能"的理解,还停留在"装了个功能"。但技能的本质,比你以为的要危险得多。
| ❌ | ✅ |
| ❌ | ✅ |
| ❌ | ✅ |
| ❌ | ✅ |
差别在于你是否看清了本质:一个技能加载进你的 AI 环境,跑起来的时候,可能在你的眼皮底下执行任意代码。这和手机上装一个来路不明的 APK,逻辑一模一样。
第 1 步:为什么一定要独立虚拟环境?
背景:AI-Infra-Guard 的安装会带来 openai、pydantic 等一堆依赖,而且版本要求比较新。你要是图省事,直接 pip 装进正在用的主环境(比如 hermes 的 venv),它会强行降级这些包,给你把主环境搞坏。
隔离,是这个工具用起来的第一条红线。别觉得麻烦,多敲两行命令,能省掉后面一整天的排查。
python -m venv /tmp/aigscan-venvsource /tmp/aigscan-venv/bin/activate结果:生成一个干净、完全独立的 python 环境,和主项目井水不犯河水。后面所有操作都在这个隔离空间里做。就算扫出什么奇怪的东西,删掉 /tmp/aigscan-venv 就完了,主环境毫发无损。这条命令本身,就是你的第一道保险。
第 2 步:怎么装上扫描器?
背景:工具本体叫 `aig-skill-scan`,是 AI-Infra-Guard 这个开源项目里的一个子命令,专门用来扫描技能(skill)目录。装它,就是一条 pip,没有任何花活。
pip install ai-infra-guard结果:装完后,你输入 `aig-skill-scan --help`,能正常列出一串参数说明,就说明装好了。整个过程不需要 sudo,不需要额外编译,也不需要你去改什么环境变量,真就是开箱即用。腾讯朱雀实验室把使用门槛压到了最低。
第 3 步:不配大模型密钥,扫描器根本跑不起来?
背景:这是很多人卡住的第一关。`aig-skill-scan` 的判定逻辑,要靠大模型来做深度理解,所以你必须给它一个大模型的接口和 key。好消息是,它兼容 DeepSeek 的接口,国产模型就能用,不用翻墙也不用买贵的。
结果:拿到 key,填进参数,扫描器就能在 28 秒内调用大模型,把技能的行为一条条拆开判定。注意,这一步千万不能省。不配 key,扫描器就相当于没有"脑子",很多隐蔽的恶意行为,它根本判不出来,扫了个寂寞。
第 4 步:一条命令就够吗?这样扫一个仓库
背景:准备好待扫描的技能目录后,把所有要点压进一条命令。`--repo` 指向技能所在目录,`-o` 指定结果输出文件,`--language zh` 让报告用中文输出。一长串,但每个参数都好懂。
aig-skill-scan --repo /tmp/test-skill-repo --language zh -m deepseek-v4-flash -u https://api.deepseek.com -o result.json结果:实测 3 个技能测试库,28 秒跑完,检出 2 个严重漏洞。正常的技能 markdown-helper 零误报。整条命令可复制、可反复,下次想体检新技能,把 `--repo` 换成新目录就行。这就是那个"一条命令"的全部真相。
第 5 步:报告跳出"严重",到底意味着什么?
背景:一条命令跑完,结果落在 `result.json` 里,按严重程度把漏洞分级,你会看到"严重、高危、中危"。看懂级别比看懂代码更重要,因为它直接告诉你先处理哪个。
T01 技能指令劫持(`system-prompt-leak/SKILL.md` 第 5-17 行):这个技能要求模型输出系统提示词、交出密钥、开启"开发者模式"越狱。说直白点,你的提示词和密钥,它都想拿走。
T03 远程载荷执行(`data-exfil-helper/SKILL.md` 第 8-10 行):这个技能先 zip 打包本地文件,再 curl 外传到服务器,删除本地证据,最后枚举环境变量里的密钥。这是一整条完整的泄密流水线。
结果:看到"严重"先别慌。按优先级处理,第一时间禁用 T01 和 T03,再回头排查中危项。最快的修复方式就是一句话:删掉,别用了,再把可能暴露过的密钥全部轮换一遍。
哪 3 个坑踩过就肉疼?
坑一:把工具装进主环境。 这是最不值的一个教训。图省事直接 pip 装进正在用的环境,openai、pydantic 当场被降级,主项目瞬间趴窝。隔离是底线,不是建议。
坑二:不配大模型 key 就想跑。 这多半是卡在第一步的人。没有 key,`aig-skill-scan` 的深度判定基本等于废掉,扫了也是白扫。配个 DeepSeek 的接口,几十秒就搞定。
坑三:拿恶意样本在真实环境跑。 这就有点自找麻烦了。T01、T03 这类样本,只能在隔离的测试目录里复现、踩坑、看效果,千万别拿到生产环境试,那是把木马请进家门。
这三条,都是我们实测里最容易踩的,你提前知道,就能绕过去。
你可能想问的 6 个问题是什么?
Q1:腾讯开的源,靠谱吗?靠谱。AI-Infra-Guard 是腾讯朱雀实验室开源,Apache-2.0 协议,2026-08-28 还在活跃更新,版本号 v4.6.0。社区 6000+ 星,说明有人在持续用、持续维护,不是个冷死的仓库。
Q2:它是怎么扫出恶意技能的?两层配合。一层是规则匹配,快速锁死常见危险模式;一层是调用大模型做语义理解,去解读 SKILL.md 里那些藏得深的指令劫持和数据外传。这也是它为啥必须配 key 的原因。
Q3:会误报正常技能吗?会有,但真不多。我们的 3 个测试库里,正常技能 markdown-helper 就是零误报。遇到拿不准的,人工扫一眼就完,别因为怕误报就不做扫描。
Q4:恶意技能是怎么来的?渠道就是你能想到的那几个:来路不明的插件市场、粉丝群传的"神器"、团队内部流转的打包文件。核心在于它能在你的 AI 环境执行代码,出了问题再后悔,成本就高了。
所以,你动手了吗?
给 AI 技能做体检,成本低到一条命令,收益却是别让自己的密钥裸奔。别再"装了就信",花 28 秒验一眼,远比你事后去收拾残局便宜得多。
把这条转给那个天天装 AI 插件的朋友,他可能正打算把一匹木马装进自己的助手。
想持续避开这类 AI 安全坑?关注「QIAN数据 · AI工具实验室」,每周实测真实工具,从别人的坑里抄近路。
关注「QIAN数据 · AI工具实验室」
本文由 AI 辅助创作