ARTICLE · 995096
律师学 AI 的第一步:搭一条从 OCR 到脱敏的本地工作流
律师学 AI 的第一步:搭一条从 OCR 到脱敏的本地工作流很多同行把"学 AI"理解成"选工具"。但比选错工具更贵的,是不动手。这一篇想给一个具体的起点:用本地模型把一份客户扫描件,安全地变成可以交给 AI 分析的文本。 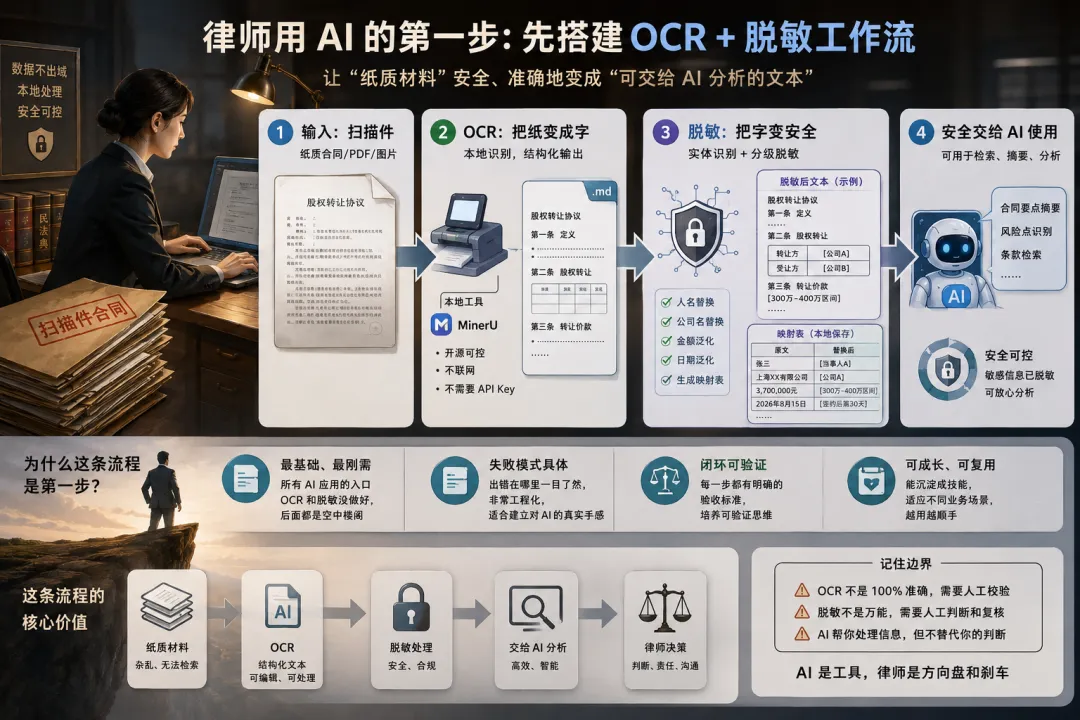
为什么是这条流程?因为 OCR 和脱敏是法律 AI 应用里最基础、也最容易被误解的两个环节。OCR 解决"把纸变成字",脱敏解决"把字变成能安全交给 AI 的字"。这两步没做好,后面所有高大上的应用都是空中楼阁。而且这两个环节有一个共同点:它们的失败模式非常具体、非常工程化,非常适合用来建立对 AI 的真实手感。 这一篇还有一个更硬的前提,先说在前面:客户文件,必须走本地模型管线;OCR 不走任何云端 API,脱敏也用本地模型。这不是技术洁癖,是保密底线。下面整条流程都按这个前提来搭。 开始之前需要三样东西:一个能听懂指令、调度工具、管理文件的 AI 工作台,一个开源文档解析工具,一份扫描版合同。 这里的主角是MinerU——一个开源的文档解析工具(GitHub 仓库 opendatalab/MinerU,上海人工智能实验室出品)。它可以把扫描版 PDF 转成结构化的 Markdown 文本,全程在本地运行:不联网、不需要 API Key、不付费、数据不出这台电脑。 先说清一个容易混淆的点。MinerU 有两层:一层是完整的开源项目,就是我们接下来要装的,它是一套完整的解析流水线,能做版面分析、表格识别、阅读顺序排序,支持批量处理;另一层是别人把 MinerU 的模型单独抽出来放到了 Ollama 模型库里,那只是模型本身,不是完整工具。我们要装的是前者。 安装分三步。第一步装 Python 环境,去 python.org 下载 3.11 版本。第二步打开终端,输入: 第三步下载模型: 它会问你从 HuggingFace 还是 ModelScope 下载,国内用户选 ModelScope,速度快很多。模型文件加起来大概 2GB,一次下载,永久使用。 到这里,准备工作全部结束。你没注册任何云服务账号,没绑银行卡,没往任何服务器上传过一个字节——这正是一条客户文件工作流该有的起点。 找一份真实的扫描版合同,在终端里进入合同所在文件夹,输入: MinerU 会自动判断这份 PDF 是文字版还是扫描版。如果是扫描版,它会启动本地的 OCR 引擎逐页识别。一份 12 页的股权转让协议,在普通笔记本上跑大概 2 分钟出结果,比云端 OCR 慢一些,但全程数据没离开过这台电脑。 识别完成后,output 文件夹里会生成一个 Markdown 文件,合同的全部文字、标题、段落、表格结构都保留下来了。 这里有一个关键细节:MinerU 默认用的是 1.2B 参数的视觉模型,对标准印刷体识别效果很好,但对模糊扫描件、手写批注的处理能力有限。这不是 MinerU 的问题,是所有本地小模型的共同边界——而恰恰因为是本地模型,这个边界换来的,是文件从始至终没离开你的机器。 我第一次用的时候,合同金额"3700000"识别正确,但有一处"不得"被识别成了"不的",还有一处手写签名旁边的备注直接漏掉了。这种错误很隐蔽,不仔细看根本发现不了。所以我的做法是,打开生成的 Markdown 文件,人工快速扫一遍关键条款,重点是当事人名称、金额、日期、违约责任这几处。 这一步教会你的事,是 AI 的输出永远需要人工校验,校验的重点放在"错了会出大事"的地方。 如果你有一批合同要处理,MinerU 支持批量模式: 它会自动遍历文件夹里所有 PDF,逐个解析。这个功能在月底集中处理案件材料时特别有用——而且因为是本地批处理,几百份客户合同过一遍,没有任何一份触过网。 MinerU 默认模型只有 1.2B 参数,优点是轻量,普通电脑就能跑。但如果你电脑配置不错(16GB 以上内存或带独立显卡),可以接入 Ollama 上更大的本地视觉模型,识别准确率会明显提升——注意,这里换的仍然是跑在你自己机器上的模型,不是某个云端 API。 方法分两步。第一步装 Ollama,官网下载,然后拉一个本地视觉模型: qwen3-vl 是阿里开源的视觉模型,8B 参数,6.1GB,对中文文档、票据、表格的识别能力比 MinerU 默认模型强不少。如果你的电脑有 24GB 以上显存,还可以试试 qwen3vl:32b,效果更好,但模型文件有 20GB。 第二步改 MinerU 的配置文件,让它把请求发给本地 Ollama(localhost:11434,本机端口,不对外): api_key 随便填一个非空值即可,Ollama 本地服务不需要真实密钥。改完后,MinerU 在解析时会调用你本地的qwen3-vl 模型,速度比默认模型慢一些,但复杂版面的识别质量好很多。 这里有一个实际的取舍。MinerU 默认模型 398MB,qwen3-vl:8b 是 6.1GB,qwen3-vl:32b 是 20GB。模型越大,识别越准,但下载越久、占硬盘越多、对电脑要求越高。我的建议是,先用默认模型跑通流程,遇到识别不满意的复杂件,再考虑换更大的本地模型。无论怎么换,文件始终在你机器上。 拿到 MinerU 生成的 Markdown 文件后,下一步是脱敏。这一步也用本地模型做——把脱敏交给本地部署的大模型(通过你的 AI 工作台调度本地模型),而不是某个云端 API。 为什么脱敏也必须本地?因为脱敏之前的那份文本,还完整带着当事人、金额、日期这些敏感信息。如果你把这份"尚未脱敏"的文本发给云端模型,那前面 OCR 全程不出域的努力就白费了——敏感数据在脱敏前这一秒,已经出了域。所以脱敏这一环,绝对不能走云端。 MinerU 只负责把纸变成字,脱敏需要理解上下文、判断哪些信息敏感,这是大模型的强项。脱敏不是简单地把人名换成"甲方""乙方",真正的脱敏要处理好几层信息。 脱敏可以分成四级,从浅到深:
日常工作中,L1 和 L2 用得最多。L3 和 L4 适合需要把材料发给外部顾问或者做公开培训的场景。 在本地模型里做 L1 和 L2 脱敏,先把 MinerU 生成的 Markdown 文件交给它,然后下指令。我一般这么说: 本地模型会生成两份文件:一份是脱敏后的合同文本,一份是映射表。映射表非常重要,它是你以后还原信息的唯一依据。我的习惯是把映射表存在本地一个加密文件夹里,文件名用日期加案件编号,比如"20260831_股权转让_映射表.csv"。 这一步有一个坑要提醒。本地模型做实体识别时,可能会漏掉一些不标准的写法。比如合同里写"张总"或者"王工",模型可能识别不出来这是人名。所以脱敏后的文本,还是要人工检查一遍,重点看有没有漏网的敏感信息。这一点和 OCR 校验一脉相承:AI 替你做了大部分活,但"错了会出大事"的地方,永远要你自己过一眼。 手动做一次 OCR 加脱敏,大概要 15 分钟。但律师的工作是重复的,每周都有新的合同要处理。这时候就该把流程固化下来。 你的 AI 工作台通常有一个"技能创建"功能,可以把刚才的整套操作打包成一个技能。以后每次只需要把扫描件拖进去,技能自动完成 OCR、脱敏、生成映射表三步,且全程运行在本地模型上。 创建方法是在对话框里说: 工作台会生成一个 SKILL.md 文件,里面记录了完整的操作流程和判断规则。这个文件你可以反复修改,比如调整脱敏级别、增加新的实体类型、修改映射表的保存路径。 我建议每个律师都建一个自己的脱敏技能。因为每个律师的业务领域不同,敏感信息的类型也不同。做知识产权的律师,可能要额外处理专利号、商标名;做劳动法的律师,可能要处理身份证号、社保卡号。这些个性化规则,只有你自己最清楚——而它们都应该锁在本地模型里跑,不该交给任何外部服务。 上面这条流程全部基于本地模型,优点是零成本、零配置、数据不出域。缺点也很明显:速度慢一点,复杂版面的识别准确率有限,需要人工校验的地方多。 所以自然会有人问:那有没有更快更准的云端方案?有。比如市面上确实有云端 OCR 服务,装上 API Key,识别速度和准确率都会上一个台阶。 但这里必须划一条红线:客户文件,不走云端 API。 具体说: 任何含当事人、含保密义务、含尚未脱敏信息的客户原始文件,OCR 与脱敏一律走本地模型管线,绝不允许上传到任何云端服务。 云端 OCR / 云端大模型,只可用于已经脱敏的公开材料或纯测试样本——比如你拿一份网上下载的公开判决书练手,那走云端也无妨。 判断标准只有一条:这份文件如果泄露,会不会让客户或你本人承担责任?会,就本地;不会,才考虑云端。 换言之,云端不是不能用,而是它的使用前提是"内容已经安全"。而客户扫描件在 OCR 和脱敏完成之前,恰恰是最不安全的时候。把这个顺序反过来——先本地、后云端、且云端只接已脱敏内容——才是守得住底线的用法。 充值就能变强,这是好事,但不应该成为处理客户文件的前提。对带保密义务的材料,本地管线的"慢一点",买的是你睡不着觉时那份安心。 上面几步做完,你已经拥有了一条能跑通的工作流。但我必须把边界说清楚,这套方案有它的适用范围。 第一,本地 OCR 的准确率受模型大小限制。1.2B 的 MinerU 对标准印刷体够用,但对模糊件、手写件、复杂表格的处理能力有限。这种情况下,人工校验的时间会增加,甚至可能超过手动打字的时间。 第二,AI 脱敏不是万能的。L1 和 L2 级脱敏,本地模型做得比较好。但到了 L3 和 L4,需要律师自己判断哪些信息构成"案件骨架",哪些信息剥离后不影响 AI 推理。这个判断没有人替你做,也不该交给云端。 第三,也是最重要的一点,这条工作流解决的是"安全地使用 AI",不是"AI 替代律师"。脱敏后的文本可以交给 AI 做摘要、做检索、做初步分析,但最终的法律判断、文书定稿、客户沟通,仍然是律师的工作——而且脱敏后交给 AI 做分析时,同样建议走本地或你已确认合规的部署,别因为"已经脱敏"就放松对通道的要求。 我搭完这条流程后的真实感受是,它没让我失业,也没让我效率提升十倍。它只是把"从扫描件到可安全分析的文本"这个过程,从原来的 1 小时缩短到了 15 分钟,并且把"数据不出域"从一句口号,变成了工作流里默认发生的事。 回到开头的问题,为什么律师学 AI 的第一步,是搭这条本地工作流。 因为它逼你面对 AI 的真实面貌。本地模型会出错,脱敏会漏检,AI 的理解有边界。这些不是在 PPT 里能学到的,必须亲手做一次才能建立手感。 因为它是一个完整的闭环。从输入到输出,每一步都有明确的验收标准。OCR 完要检查关键信息,脱敏完要检查漏网之鱼,这种"每一步都可验证"的思维,是管理 AI 的核心能力——而它和"客户文件不出域"这条红线,从第一天就该绑在一起。 因为它让你习惯了开源世界的基本动作。装 Python 环境、跑 pip install、读 GitHub 文档、在终端里输命令,这些动作对工程师是日常,对律师是陌生领域。但一旦做过一次,你会发现没有想象中难。以后看到任何一个新的开源 AI 工具,你都能自己装起来跑一遍——而且你会本能地先问一句:"它能在本地跑吗?客户文件安全吗?" 因为它是一个可以生长的起点。这条流程跑通后,你可以往上游加"自动从邮件下载附件",往下游加"脱敏后自动发给本地模型做摘要",往旁边加"批量处理多份合同"。每一步扩展,都是对你工作流的深化,也都该守住同一个前提:客户文件,本地优先。 最后说一句实话。这条工作流搭完,你对 AI 的理解会超过大多数同行。不是因为你用了多高级的技术,而是因为你亲手把 AI 放进了自己的工作流程里,知道了它哪里行、哪里不行、哪里需要你盯着——并且从第一步起,就没让客户的一页纸,莫名其妙地出现在某个你控制不了的服务器上。 这种理解,比任何培训都值钱。
〔碳硅圆周律 · 专注 AI 法律实务,面向律师 / 仲裁员 / 法务同行〕
本文为操作性方法论论述,核心论点(客户文件必须本地 OCR、脱敏必须用本地模型、云端仅用于已脱敏/公开/测试材料)为本号一贯立场的方法论展开,非对特定平台的功能承诺。 MinerU、Ollama、qwen3-vl 均为真实开源项目;文中命令、模型名、端口(localhost:11434)、模型体积(1.2B / 8B 6.1GB / 32B 20GB)基于 2026 年 8 月公开信息,开源项目迭代较快,实际以 GitHub / 官方文档为准(发布前建议复核一次版本与命令)。 "超过大多数同行""效率从 1 小时缩短到 15 分钟"等为说理性表述与经验性估计,非实测基准数据,不当作已核验统计。 本地 OCR 的识别错误类型(金额正确但"不得"误识为"不的"、手写批注漏识别)为代表性经验案例,非系统性基准测试结果。 本文未引用任何未核验的法条、令号或判例;所提保密要求(客户文件不出域)与已发文《律师使用云端 AI 的泄密风险》《不该把全量案卷塞进云知识库》中的论证一致,未引入新待核断言。
〔碳硅圆周律 · 专注 AI 法律实务,面向律师 / 仲裁员 / 法务同行〕
很多律师问过同一个问题:学 AI 到底从哪里开始?别急着上"十大工具盘点"课,也别先研究哪个模型最强。第一步应该是自己动手搭一条最基础的工作流——从扫描件 OCR 开始,到脱敏结束。这条流程做通了,你对 AI 能力边界的理解,比听十场讲座都管用。
一、十分钟准备:装一个只跑在本地的解析器
pip install -U ”mineru[core]”
mineru-models-download
二、第一步·把扫描件变成文字(数据不出电脑)
mineru -p ./合同.pdf -o ./output
mineru -p ./contracts/ -o ./output
三、配置够好,换更强的本地模型
ollama pull qwen3-vl:8b
”llm-aided-config”: {”title_aided”: {”base_url”: ”http://localhost:11434/v1”,”model”: ”qwen3-vl:8b”,”api_key”: ”ollama”,”enable”: true}}
四、第二步·让本地模型帮你脱敏
把这份合同做 L1 和 L2 级脱敏。规则如下:1. 所有自然人姓名替换为[当事人A][当事人B]这种格式,按出现顺序编号2. 所有公司名替换为[公司A][公司B],同样按顺序编号3. 所有金额替换为区间,比如 370 万改成 300 万到 400 万4. 所有具体日期替换为相对时间,比如 2026 年 8 月 15 日改成 签约后第 30 天5. 生成一个映射表,记录原文和替换后的对应关系,这个映射表只保存在本地,不上传
五、第三步·把流程固化成技能
把刚才的 OCR 脱敏流程保存成一个技能,名字叫”合同脱敏助手”。触发条件是用户上传 PDF 或图片格式的合同,输出包括脱敏后的文本和本地映射表。要求:OCR 与脱敏全程使用本地模型,不调用任何云端 API。
六、红线:客户文件,不走云端 API
七、这条工作流的真实边界
八、为什么这是最好的第一课(之一)
事实与推断标注