ARTICLE · 1004931
APatch 源码笔记(二):apd 到底是什么?从 main.rs 追踪守护进程的启动与 multicall 设计
本文基于双仓库交叉核实:APatchmain@6ec140e + KernelPatchtag 0.13.8(HEAD bcc8498)。所有结论附 仓库:文件:行号。
01 这一篇我们要解决什么问题?
上一篇我们追完了开机四阶段,但在结尾留了三个没解开的谜:
1. su、resetprop、magiskpolicy、开机事件处理器——凭什么都是同一个二进制/data/adb/apd?2. apd 名字里带着"d"(daemon),开机时被内核"召唤",它到底是不是一个常驻的后台进程? 3. --superkey到底把 apd 送到了什么权限级别?没有密钥时它会怎样?
这三个问题都指向同一个地方:apd/src/main.rs。它只有 23 行,但 APatch 用户态的几乎所有谜底都藏在这 23 行和它调用的 cli::run() 里。
02 为什么从这里开始?
因为 main.rs 是整个 crate 的"部门目录"。先看全文——注意,这不是节选,这就是完整的文件(APatch:apd/src/main.rs,23 行):
mod apd;mod assets;mod cli;mod defs;mod event;mod insmod;mod late_load;mod lua;mod magica;mod metamodule;mod module;mod module_config;mod package;#[cfg(any(target_os = "linux", target_os = "android"))]mod pty;mod resetprop;mod restorecon;mod sepolicy;mod supercall;mod utils;fn main() -> anyhow::Result<()> { cli::run()}20 个 mod 声明 + 一个 3 行的 main。读 Rust 项目有个小技巧:mod 列表就是源码的目录页——event(上篇主角)、module(模块系统)、supercall(与内核通信)、sepolicy(SELinux)、late_load/magica/insmod(越狱三件套)……专栏后续每一篇都能在这张目录页上找到自己的位置。
顺带一个 Rust 语法点,只讲一句:#[cfg(any(target_os = "linux", target_os = "android"))] 是条件编译——pty(伪终端)模块只在 Linux/Android 上编译。后面我们会看到 daemonize 也用了同样的手法做双实现。
真正的戏肉在 cli::run()。我们直接跳进去。
03 cli::run() 第一幕:argv[0] 多重身份(multicall)
cli::run() 的前 30 行(APatch:apd/src/cli.rs:196-225)是日志初始化加一段注释非常直白的代码:
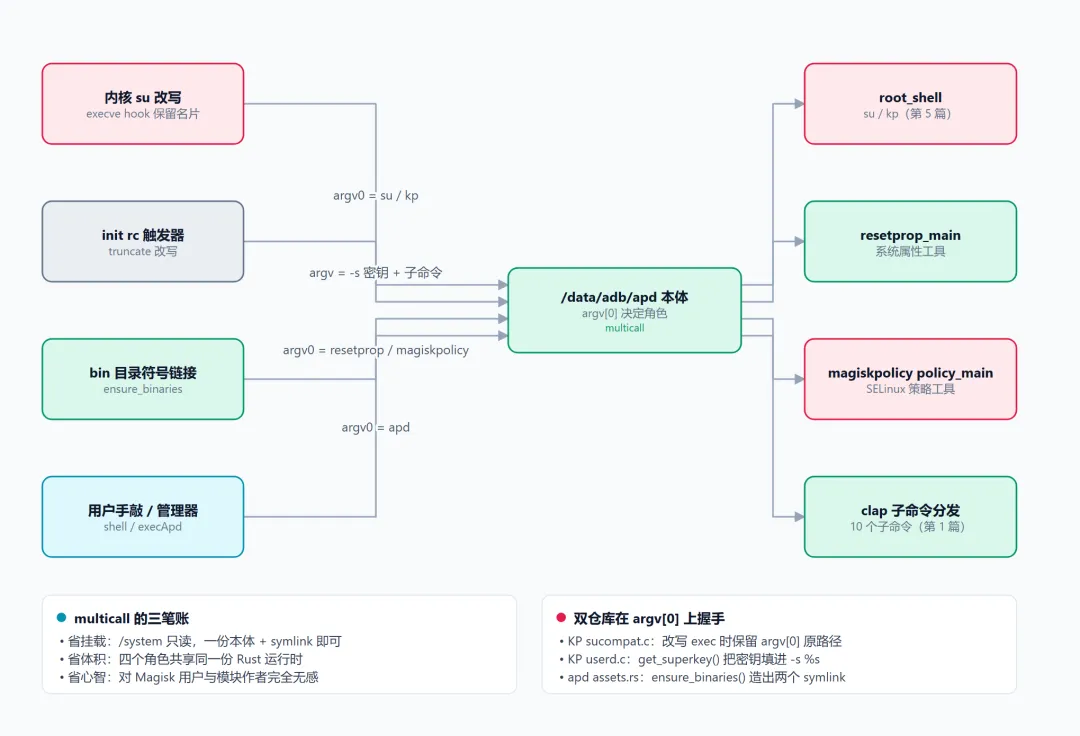
// the kernel executes su with argv[0] = "/system/bin/kp" or "/system/bin/su" or "su" or "kp" and replace it with us let arg0 = std::env::args().next().unwrap_or_default(); if arg0.ends_with("kp") || arg0.ends_with("su") { return crate::apd::root_shell(); } if arg0.ends_with("resetprop") { let all_args: Vec<String> = std::env::args().collect(); crate::resetprop::resetprop_main(&all_args) } if arg0.ends_with("magiskpolicy") { let all_args: Vec<String> = std::env::args().collect(); crate::sepolicy::policy_main(&all_args) }这是 Unix 世界一个古老而优雅的传统:multicall(多合一调用)——一个二进制根据"自己被叫什么名字"决定扮演什么角色。busybox 是这个套路的祖师爷(一个二进制通过上百个 symlink 变出 ls、cp、sh),Magisk 也这么干(magisk/magiskinit/su)。apd 一人分饰四角:
/data/adb/apd post-fs-data | .../apd | |
/system/bin/su/system/bin/kp | su/kp 结尾 | apd::root_shell) |
/data/adb/ap/bin/resetprop | resetprop 结尾 | |
/data/adb/ap/bin/magiskpolicy | magiskpolicy 结尾 |
先看最传奇的第一行:内核执行 su 时,argv[0] 是什么?这要翻到 KernelPatch 侧——源码明确行为(KP:kernel/patch/common/sucompat.c:295-309):内核把 su 的 exec 改写指向 /data/adb/apd 时,会特意把 argv[0] 写回 su 路径本身(set_user_arg_ptr(0, ...) 把第 0 个参数设为原 su 路径)。也就是说内核在递名片的时候,故意把"我是 su"这行字保留了——不然 apd 永远不知道自己是被当成 su 叫起来的。两个仓库在这一行代码上握手,这就是双仓库对读的乐趣。
再看一个细节,仔细的读者可能已经发现了:后面两个 if没有 return!resetprop_main(&all_args) 的返回值直接裸露在 if 块里,按理说执行完会"漏"到下面的 Args::parse() 去吧?
不会。秘密在这两个函数的签名(APatch:apd/src/resetprop.rs:105、sepolicy.rs:69):
pub fn resetprop_main(args: &[String]) -> ! { ... std::process::exit(0);}返回类型是 !——Rust 的 never 类型,表示"这个函数永远不会正常返回"(内部一定 process::exit)。! 可以兼容任何期待其他类型的位置,所以编译器毫无怨言。这是 multicall 实现的惯用手法:变身即永别,进了 resetprop 的角色就不会再回到 dispatcher。
那 resetprop 和 magiskpolicy 的"分身"是怎么造出来的?
magic 在 assets.rs(APatch:apd/src/assets.rs:12-29):
pub fn ensure_binaries() -> Result<()> { utils::ensure_binary(BUSYBOX_PATH)?; let resetprop_link = RESETPROP_PATH; // /data/adb/ap/bin/resetprop let _ = std::fs::remove_file(resetprop_link); std::os::unix::fs::symlink("/data/adb/apd", resetprop_link)?; let magiskpolicy_link = MAGISKPOLICY_PATH; // /data/adb/ap/bin/magiskpolicy ... std::os::unix::fs::symlink("/data/adb/apd", magiskpolicy_link)?; Ok(())}两个分身都是指向 apd 本体的 symlink,开机时由 post-fs-data 阶段的 ensure_binaries()(event.rs:161,上一篇见过)创建。而模块脚本的执行环境里,PATH 被追加进了 /data/adb/ap/bin(module.rs 的 get_common_script_envs)——于是模块作者照 Magisk 的老习惯写下 resetprop persist.x.y 1 时,shell 沿 PATH 找到 symlink、exec apd、argv[0] 命中 resetprop、进入角色。脚本作者完全不需要知道 APatch 的存在,这就是兼容层的本质:不改世界,只改名字的解析方式。
04 第二幕:clap 接管与 SuperKey 自证
如果 argv[0] 不命中任何角色,apd 就做回自己——CLI。接下来两行(cli.rs:227-233):
let cli = Args::parse(); log::info!("command: {:?}", cli.command); if let Some(ref _superkey) = cli.superkey { supercall::privilege_apd_profile(&cli.superkey); }Args 的定义在文件开头(cli.rs:11-23),只有两个字段:
#[derive(Parser, Debug)]struct Args { #[arg(short, long, value_name = "KEY", help = "Super key for authentication root")] superkey: Option<String>, #[command(subcommand)] command: Commands,}这里有个双仓库对读才能看清的呼应:#[arg(short, long)] 表示这个参数同时接受 -s 和 --superkey。还记得上一篇 KernelPatch 注入的 rc 模板吗?
exec -- truncate su -Z u:r:magisk:s0 exec /data/adb/apd -s %s post-fs-data里面的 -s %s——init 给 apd 传密钥用的正是这个短参数。内核侧的 get_superkey() 把密钥填进模板(KP:userd.c:1779),apd 侧的 #[arg(short)] 把它收进来。一条 SuperKey,从内核镜像出发,途经 rc 文本,最后落进 Rust 的 Option<String>,全程无一处巧合,全是对齐的约定。
然后是自证身份。privilege_apd_profile(APatch:apd/src/supercall.rs:263-276)值得整段精读:
pub fn privilege_apd_profile(superkey: &Option<String>) { let key = convert_superkey(superkey); let all_allow_ctx = "u:r:magisk:s0"; let profile = SuProfile { uid: process::id().try_into().expect("PID conversion failed"), to_uid: 0, scontext: convert_string_to_u8_array(all_allow_ctx), }; if let Some(ref key) = key { let result = sc_su(key, &profile); info!("[privilege_apd_profile] result = {}", result); }}三个观察点:
1. 它构造了一个 SuProfile——这个结构我们在第 1 篇提过,C 和 Rust 各有一份逐字节对齐的定义(APatch:app/src/main/cpp/uapi/scdefs.h:71-76:uid_t uid; uid_t to_uid; char scontext[0x60])。这里to_uid: 0(目标是 root)、scontext是u:r:magisk:s0(Magisk 同款特权上下文)。2. 通过 sc_su发出 syscall 45(命令号SUPERCALL_SU 0x1010)。内核侧的处理(KP:kernel/patch/common/supercall.c:135-143)拿到 profile 后直接commit_su(profile->to_uid, profile->scontext)——把当前进程提权为 root 并打上 magisk 上下文。3. 没有 superkey 就整个跳过: convert_superkey(supercall.rs:198-200)把None原样传递,if let Some不命中,sc_su根本不会发出。apd 不会因为没密钥而报错退出,只是不刷脸。
这里出现一个值得停下来想想的问题:上一篇我们说过,内核在改写 truncate exec 的时候就已经 commit_su 过一次了(KP:supercmd.c:419,而且 rc 模板还带了 -Z u:r:magisk:s0)。apd 跑起来时已经是 root + magisk 上下文,为什么还要再发一次 sc_su?
源码明确行为是:两条路径都真实存在。作者推测:这是一次"双保险 + 入口统一"——init/rc 路径上有内核代劳,但 apd 也可能从别处被拉起(比如管理器通过 root shell 执行 execApd,见第 15 篇),统一在入口处刷一次脸,让后续代码不必关心自己是怎么被启动的。另外还有个小彩蛋:SuProfile.uid 字段填的是进程 PID(supercall.rs:268),但对照内核实现,SUPERCALL_SU 只消费 to_uid 和 scontext,uid 字段根本没被读——像是为 SUPERCALL_SU_TASK(跨进程提权版)预留的复用结构。读源码时遇到这种"填了没人用"的字段,记录下来就好,别急着解释。
05 第三幕:一张 match 分发全图
接下来就是上一篇见过的分发点(cli.rs:235-380)。这次我们看全景——顶层 Commands 一共 10 个(cli.rs:26-86):
post-fs-data | event::on_post_data_fs | ||
services | event::on_services | ||
boot-completed | event::on_boot_completed | ||
uid-listener | event::start_uid_listener | ||
soft-reboot | event::soft_reboot | ||
late-load | late_load::runmagica::run | ||
insmod | insmod::insmod | ||
module | |||
resetprop | resetprop_main | ||
sepolicy | sepolicy::execute |
这行表本身就是一个发现:apd 的全部业务,就是这一张分发表加上每个格子背后的世界。module 命令底下还嵌套了一层子命令树(Install/Uninstall/UndoUninstall/Enable/Disable/Action/Lua/List/Config,cli.rs:88-143),第 9-13 篇会逐个进。
值得注意的还有三个细节:
细节一:clap 的 kebab-case 是整个命名体系的隐形胶水。 clap 默认把枚举变体名转成 kebab-case:PostFsData → post-fs-data、BootCompleted → boot-completed、UidListener → uid-listener。于是三层字符串严丝合缝:KernelPatch rc 模板里写的 post-fs-data(KP:userd.c:118)→ 命令行参数 → event.rs 里的阶段字符串。上一篇提到的 cli.rs:39 注释写成 "boot-complete" 却没出 bug,正是因为注释不参与编译——真正起作用的变体名 BootCompleted 转出来就是 boot-completed。
细节二:日志 tag 是 APatchD(cli.rs:197-208,android_logger 初始化)。以后在设备上抓 logcat,logcat -s APatchD 就能单独看到 apd 的全部输出——这是排查问题最常用的入口。
细节三:分发末尾的统一收尾(cli.rs:382-385):
if let Err(e) = &result { log::error!("Error: {:?}", e); } result所有命令的错误都只记一行日志然后把 Result 抛回 main,进程以非零码退出。这个退出码甚至被内核侧"引用"了——KP:sucompat.c:520-523 的注释原话:"otherwise /system/bin/truncate is executed literally and every apd bootstrap command exits with status 1"。一个仓库的注释在讨论另一个仓库的退出码,双仓库项目里这种"隔空对话"就是最好的路标。
06 核心认知纠正:apd 是守护进程吗?
现在可以正面回答第 02 节的第二个问题了。源码明确行为:一次正常的 Android 运行中,apd 相关的进程清单是这样的:
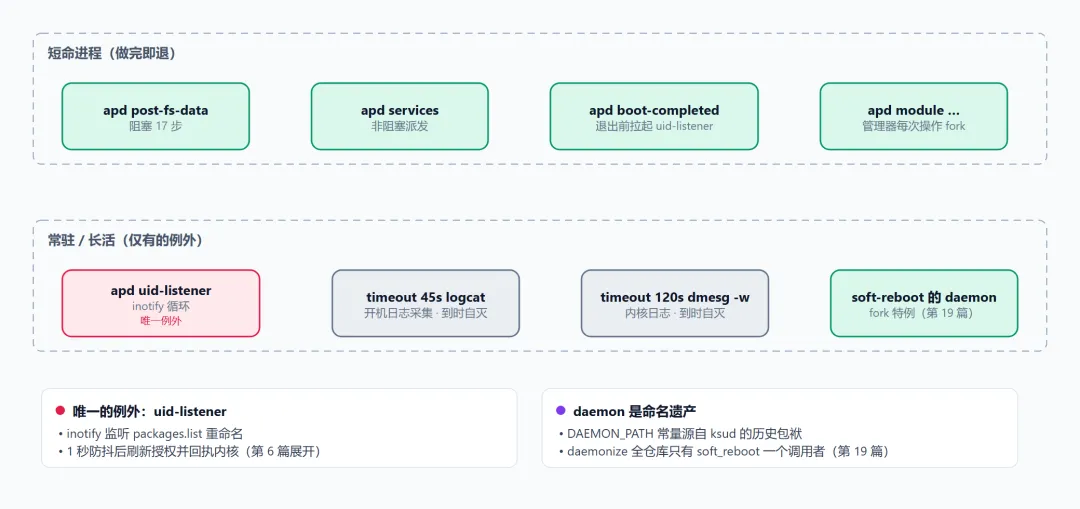
短命进程(做完即退): apd post-fs-data → 开机跑一次,进程退出(event.rs:43-214) apd services → 开机跑一次,非阻塞派发后退出(event.rs:248) apd boot-completed → 开机跑一次,退出前拉起 uid-listener(event.rs:277-284) apd module ... → 管理器每次操作都 fork 一个(第 15 篇) apd su → argv[0] 变身,shell 退出即结束(apd.rs:51)常驻进程(仅有的例外): apd uid-listener → inotify 循环,唯一的长驻者(event.rs:286-346) timeout 45s logcat 等 → 开机初期的日志采集,到时自灭(event.rs:105-126) soft-reboot 的 daemon → fork 出来的特例(utils.rs:143-187,第 19 篇)所以答案是:apd 不是传统意义上的常驻守护进程,它是"一组短命事件处理器 + 一个例外常驻者"。它的"daemon"气质来自启动方式(被内核/ init 在无人交互时拉起)而不是生命周期(活一下就死)。
daemonize(utils.rs:143-187)全仓库只有一个调用者——soft_reboot(event.rs:357),而且实现得很克制:fork 之后父进程等子进程结束再退出,子进程 setsid 摆脱控制终端、switch_cgroups、把 0/1/2 三个文件描述符全部重定向到 /dev/null。为什么软重启必须这么做?event.rs:354-356 的注释说得很直白:stop 会拆掉包括启动它的 app/shell 在内的整个框架进程树,不先脱离,start 就永远执行不到。这段我们留到第 19 篇展开。
顺带修正一个容易先入为主的印象:defs.rs:10 里确实有 DAEMON_PATH "/data/adb/apd" 这样的常量名,但如你所见,常量名里的 "daemon" 是命名遗产(apd 源自 KernelSU 的 ksud,它的历史包袱),不是架构承诺。
07 抢先 60 秒:root_shell 的大门
argv[0] 命中 su/kp 时进入的 root_shell()(apd.rs:51),本篇只看一眼门牌,第 5 篇再进屋。门上刻着两句话:
pub fn root_shell() -> Result<()> { // we are root now, this was set in kernel!"我们现在已经是 root 了——这是内核设好的。" 这行注释一句话划清了职责边界:提权发生在内核(commit_su,上上节讲过),apd 的 su 角色只负责"以 root 身份把 shell 交给用户"——解析 Magisk 兼容参数(-c/-Z/-g/-G/-p/-M,用的是 getopts 而不是 clap,因为要兼容 su 的传统参数风格)、准备 PTY 和 cgroup,然后 exec。这里埋一个好问题给第 5 篇:既然提权在内核就完成了,root_shell 里那段 set_identity(apd.rs:31-43)把 uid 又设了一遍,是设给谁的?
08 为什么这样设计?multicall 的三笔账
最后把 multicall 的"为什么"算清楚,它其实同时在省三样东西:
1. 省挂载: /system是只读分区,你不可能往里放新二进制。所有自有工具必须住在/data/adb。如果 su、resetprop、magiskpolicy 是三个独立二进制,就得维护三份安装、更新和 SELinux 标签逻辑;一个本体加几个 symlink(内核侧 su 改写 + 用户侧ensure_binaries),安装逻辑只有一份。2. 省体积:Rust 静态编译的二进制不小(这个项目的 release 配置是 strip + fat LTO + panic abort,apd/Cargo.toml),四个功能四个二进制就是四倍基础体积。单二进制 multicall 让四个角色共享同一份运行时。3. 省心智:对模块作者和从 Magisk 迁移的用户来说, resetprop、magiskpolicy、su的用法一点没变——名字没变,用法没变,变的只是名字背后指向谁。好的兼容层让被兼容者无感。
而它的成本也恰好呼应上一篇的结论:跨进程协议只能是字符串。argv[0] 是字符串,rc 是文本,密钥是命令行参数——multicall 体系里,字符串就是接口。
09 本篇源码地图
在上一篇地图上新增:
apd/src/main.rs | |
apd/src/cli.rs | |
apd/src/apd.rs | root_shell |
apd/src/supercall.rs | privilege_apd_profileconvert_superkey / SuProfile |
apd/src/assets.rs | ensure_binaries |
apd/src/utils.rs | daemonizeis_safe_mode |
apd/build.rs | version.properties 生成 VERSION_CODE,从 app/src/main/cpp/version 生成 kp_version.rs(apd --version 显示的就是它) |
KP:sucompat.c | |
KP:userd.c:1779 | get_superkey()-s %s |
10 总结与思考题
这一篇我们解开了三个谜:apd 是一个 multicall 二进制,凭 argv[0] 在 su / resetprop / magiskpolicy / 事件处理器四个角色间切换,分身靠 symlink、内核侧保留名片;它不是常驻守护进程,而是"短命事件处理器 + uid-listener 这个唯一例外";SuperKey 的作用是向内核刷脸自证(sc_su → commit_su),没有密钥时这一步整个跳过——apd 不报错,因为很多调用路径上,内核早就替它把权限给好了。
留三道思考题,前提都已在源码中核实:
1. cli.rs:218-225的 resetprop/magiskpolicy 分支没有return,为什么不会"漏"到Args::parse()?(提示:两个*_main函数的返回类型,本文第 03 节出现过。)2. privilege_apd_profile构造的SuProfile里uid字段填了进程 PID(supercall.rs:268),但内核的call_su(KP:supercall.c:135-143)只读取to_uid和scontext——这个字段在哪条命令里才会真正被消费?去scdefs.h里找带TASK的那个命令号,再看它内核侧怎么用。3. 如果手动以 root 身份执行 apd post-fs-data但不带-s,privilege_apd_profile会被跳过——那这个进程还有 root 权限吗?sepolicy 写入还能成功吗?(提示:分清"提权"和"刷脸"两件事,想想你自己是用什么身份执行的。)
下一篇我们进入本专栏的通信中枢:《APatch 源码笔记(三):没有 ioctl、没有 netlink——supercall 通信机制解剖》。sc_su 背后的 syscall 45 到底是怎么被"征用"的?ver_and_cmd 那个位编码里的 0x1158 是什么?为什么我可以说内核其实根本不校验它?struct su_profile 的 0x60 字节里还藏着什么?我们从 supercall.rs 的第一个函数出发,一头扎进 KernelPatch 的 supercall.c。