ARTICLE · 1010252
同样是 AI 生成办公文档,为什么表格、文稿和演示要用三种不同的中间格式
过去两个月我们陆续做了三个功能:AI 生成 Excel、AI 生成 Word、AI 生成 PPT。
从产品描述上看,这三件事像是同一件事的三个变体——用户给一段需求或一堆素材,模型生成内容,前端渲染,导出成对应的 Office 文件。第一版方案确实是这么设计的:定一套通用的文档 JSON,三种类型共用。
写到第二个功能的时候这套设计就塌了。
最后落地的三个功能,中间格式、生成方式、校验策略完全不同。这篇想认真聊聊为什么会分叉,以及在"让模型产出可用的结构化文档"这件事上,有哪些取舍是绕不过去的。
一、第一个岔路口:结构精确,还是内容完整
先看表格。
一张 Excel 里,每个单元格的位置、数据类型、公式引用的行号,都必须精确。列定义写了 4 列,某一行给了 3 个值,整张表从那一行开始全部错位。合计行的 =SUM(B3:B14) 里的 14 算错一位,用户下载后打开看到的就是一个错误的总计——而且他多半不会发现。
所以表格只能用严格的 JSON DSL:
{”name”: ”销售明细”,”columns”: [{ ”header”: ”月份”, ”width”: 12, ”type”: ”text” },{ ”header”: ”销售额”, ”width”: 16, ”type”: ”currency” }],”rows”: [[”1月”, 1250000], [”2月”, 1380000]],”totalRow”: [”合计”, ”=SUM(B3:B4)”],”freezeHeader”: true}
有了明确的 schema,就可以在服务端写校验器,把结构性错误挡在返回给用户之前:工作表最多 5 个、每张表 220 列、1500 行、每行长度必须等于列数、type 只能是 text/number/percent/currency/date、条件格式的列号不能越界。校验不过就把具体的错误信息回喂给模型重试——不是笼统地说"格式不对",而是"第 2 个工作表(销售明细) 第 7 行有 3 个单元格,与 4 列不匹配,每行长度必须等于列数"。模型看到这种信息,第二次基本就能改对。
代价是:JSON 不能流式渲染。
一份 JSON 流到一半不是合法 JSON,你无法把它解析出来给用户看。所以表格是非流式的——点下生成,用户要对着一个转圈等 1~2 分钟,中间什么也看不到。
然后是文稿。
我们一开始想把 Word 也塞进类似的 JSON 结构:段落数组、每段带样式、表格单独一个节点。真写起来才发现两个问题:
第一,正文是长文本,塞进 JSON 字段意味着模型要处理大量转义。一篇两千字的工作总结里有引号、换行、书名号、百分号,模型只要有一个引号没转义,json.Unmarshal 直接失败,整篇作废。而这篇文章的内容其实是完全可用的——它只是格式壳子坏了。
第二,一篇文稿写两千字要一两分钟。表格用户还能忍受等待,因为表格是"要么全对要么全错"的东西;但文稿不是,写到一半的文稿仍然有价值。让用户对着白屏等两分钟,和让他十几秒后就看到标题和第一章逐字出现,是两种完全不同的体验。
所以文稿改用 Markdown 承载,存库时只包一层薄 JSON:
{ ”fileName”: ”2024年度工作总结”, ”markdown”: ”# ...\n\n## 一、...” }
这个决定的逻辑是:表格追求结构精确,文稿追求内容完整,两者的取舍方向本来就相反。表格宁可让用户等,也不能给一张错位的表;文稿宁可中途断掉只拿到前半篇,也不该因为一个引号丢掉整篇。
二、演示卡在中间,最后选了"让形状说话"
做到 PPT 的时候,麻烦来了:它两边都不像。
像表格的地方:每一页有明确的结构。这一页是要点页还是表格页、有几栏、栏标题是什么,这些是结构信息,不是自由文本。导出的时候每个元素要摆在具体的英寸坐标上,HTML 那套流式布局帮不上忙。
像文稿的地方:整份稿子是长文本,十几二十页,生成同样要一两分钟,同样应该边生成边看。
如果按表格的思路定一套 JSON DSL,就会得到这样的东西:
{ ”layout”: ”two-column”, ”title”: ”现状与目标”,”columns”: [{ ”title”: ”现状”, ”bullets”: [”转化率 11%”] }] }
问题在 layout 这个字段。它是一个模型必须自己声明、而且很容易声明错的元信息。模型完全可能写了两栏的内容,却标成 "layout": "bullets";或者标了 "two-column" 却只写了一栏。这类错误校验器很难判——你没法只看 JSON 就断定作者的意图。
最后的方案是:内容用 Markdown,版式不让模型声明,由前端按内容形状推断。
# 封面标题## 副标题--- ← 唯一的分页符## 一、全年回顾 ← 标题下没正文 = 章节过渡页---### 获客成本下降 31% ← 标题下写什么,就出什么版式- 全年新增线索 12,400 条- 单条成本从 420 元降到 290 元> 数据截至 12 月 25 日 ← 演讲备注,写进 pptx 备注栏
规则很简单:标题级别决定页型(封面 / ## 章节页 / ### 内容页),正文形状决定版式(- 列表出要点页,1. 有序列表出步骤页,两个以上 #### 小标题出分栏对比页,GFM 表格出表格页)。
这么做的直接好处是,模型不再有"写对了内容但标错了类型"的失败模式——它写出什么形状,就是什么版式,两者不可能不一致。提示词里那张"写成什么形状出什么页"的对照表,同时就是解析器的规格说明。
代价也有,而且很实在:
模型写歪了形状,版式就歪了。 比如它想做对比却只写了一个 ####。我们的处理是把这种单栏页摊回普通要点页——因为如果按"有####就是分栏页"来判,只有一栏的页面会渲染成空白,而且用户一编辑内容就丢了。这类兜底规则最后写了不少。推断规则必须和提示词同步改。改了一边忘了另一边,模型写的和解析器认的就对不上。这是用约定换掉显式字段之后必然要付的维护成本。
三、两个不那么显眼但很花时间的问题
1. 同一个统计口径,在 Go 和 JS 里算出了不同的结果
文稿页的工具栏显示"共 N 字",历史列表里的摘要也显示"N 字"。前者是前端算的,后者是服务端存文档时算的——同一套规则写了两遍。
上线前发现某些文稿两边对不上:工具栏 16 字,列表里 14 字。
原因是 \s。Go 的 RE2 里\s只匹配 ASCII 的[\t\n\f\r ],而 JS 的\s是 Unicode 感知的,还包括全角空格 U+3000、不换行空格 NBSP、零宽不换行空格等等。而中文文稿恰恰高频出现这些字符:首行缩进习惯用全角空格,从网页和 Word 里粘过来的文本大量带 NBSP。前端把它们当空白剥掉了,Go 当成正文字符算进了字数。
解法是把空白字符集显式列举,不再依赖两种语言各自的 \s 定义:
const wsChars = `\s\x{000b}\x{00a0}\x{1680}\x{2000}-\x{200a}` +`\x{2028}\x{2029}\x{202f}\x{205f}\x{3000}\x{feff}`
做 PPT 的时候把这条教训直接前置了:分页符和标题行的正则两边都只用 [ \t ],一个字符一个字符列清楚,不写 \s。最后拿 9 组样例(全角空格、CRLF、表格分隔行、缩进分页符、空标题行、单栏、三栏)在两种语言里跑对照,页数和章节数逐例一致。
任何"前后端各实现一遍"的统计逻辑,都值得写这么一组对照样例。它比代码 review 有效得多——这个 bug 两边的代码单看都是对的。
2. 预览和导出必须是同一套坐标
PPT 要做到"屏幕上看到的就是下载后的样子",绕不开一件事:预览和导出得共用一套尺寸。
我们的做法是让预览画布固定 1280×720 像素——这正好是导出用的 13.333×7.5 英寸乘以 96dpi。于是两边可以逐项对应:导出里写 x: 0.85(英寸),CSS 里就写 left: 81.6px;导出里写 fontSize: 26(磅),CSS 里就写 font-size: 34.7px(26 × 4/3)。外层用 transform: scale() 缩到容器实际宽度,缩略图栏和主编辑区因此可以共用同一个渲染组件,只是缩放倍率不同。
这套结构还顺手解决了一个问题:contenteditable 的编辑区和最终 PPT 的文本框是同一个位置,用户点哪儿改哪儿,改完不需要脑补"下载后会变成什么样"。
顺带一个值得一提的坑:根节点的版式类名我们本来是拼 ds-${layout} 生成的,而版式名里有 table 和 steps——正好撞上表格容器和步骤容器自己的 .ds-table、.ds-steps 类。根节点被套上了 width: 100%,而它的父元素是绝对定位没有宽度,于是宽度归零,表格页和步骤页在预览里整页空白。改成 ds-l- 前缀的独立命名空间就好了。这种 bug 单看 CSS 和单看模板都看不出来。
四、"只整理不编造"是怎么落地的
三个功能都做了两个入口:按需求生成和按素材整理。它们不是同一个场景的两种参数,而是两套独立的提示词,连温度都不同(生成 0.6,整理 0.3)。
原因是这两件事的正确行为正好相反:
按需求生成时,用户手上没有数据,模型该按业务常识补充示例内容——写工作总结就该给出"同比增长 23%"这样的量级示例,否则交出去的是一份全是 XX 的骨架,没有参考价值。 按素材整理时,用户已经有会议记录、有一篇总结、有一份方案文档,模型补的任何一个数字都会让用户在汇报现场讲错话。
所以整理类场景的提示词第一约束一律是"绝对不编造",并且明确写了违反即视为完全失败:每个事实、数字、金额、日期、人名、决议都必须能在素材里找到出处;素材没交代的写"XX"占位;素材里模糊的表述保留模糊;出现矛盾的两种都保留并指出矛盾。文稿和表格会在末尾生成"待确认事项",PPT 则是宁可一页上只有两条要点,也不为了版面好看而补数据。
需要说清楚的是:这是提示词约束,不是硬保证。结构错误可以靠校验器兜住,"有没有编造"没法用程序判定——校验器不知道哪个数字是素材里来的。这条约束能把违规率压得很低,但它依赖模型的指令遵循能力,不是零。所以产品上我们把"待确认事项"做成了显式的一节,而不是藏在正文里。
五、边界
几条已知的限制,都是设计取舍的直接结果:
表格不能流式,长表要等。这是选 JSON DSL 的代价,短期内没有好办法。相关的还有一个决定:这个场景我们关掉了深度思考——表格本身输出量就大,思考链会让输出再翻一倍,实测单次调用超过 5 分钟,用户等不到结果。结构正确性交给服务端校验器和前端归一化兜底,比开思考链划算。
网页里的公式求值器只是预览用的子集。下载到的 .xlsx 里存的是真公式,由 Excel/WPS 自己重算;网页上为了让你看到"1,250,000"而不是一串 =SUM(B3:B14),我们自己写了个极简求值器,只覆盖四则运算、单元格和区域引用、跨表引用和常见聚合函数。遇到不支持的写法直接抛错,回退成显示公式原文——宁可显示公式,也不显示一个算错的数。
版式推断有上限。目前支持要点页、步骤页、分栏对比(最多三栏)、表格页、章节页、封面和结束页。更复杂的版式——图文混排、时间轴、数据卡片——现在的形状规则表达不了。这是规则式推断相对显式声明的固有劣势。
文件在浏览器本地合成,受浏览器内存限制。三种导出(exceljs / docx / pptxgenjs)都是在用户浏览器里跑的,服务端只返回内容不碰文件。好处是数据不落第三方、排版规格和预览完全一致;代价是超大文档会撞上浏览器的内存上限。所以表格限了 500 行、PPT 的表格页限了 6 列 10 行。
编辑器是轻量级的,不是 Office。文稿的富文本编辑覆盖标题层级、加粗、列表、引用、表格增删行列;PPT 能改标题要点、增删页、调页序、换版式配色、写演讲备注。但精细排版——调字号、拖动文本框、插图——不做,那是下载之后在 Office 里该干的事。
六、几点回头看的判断
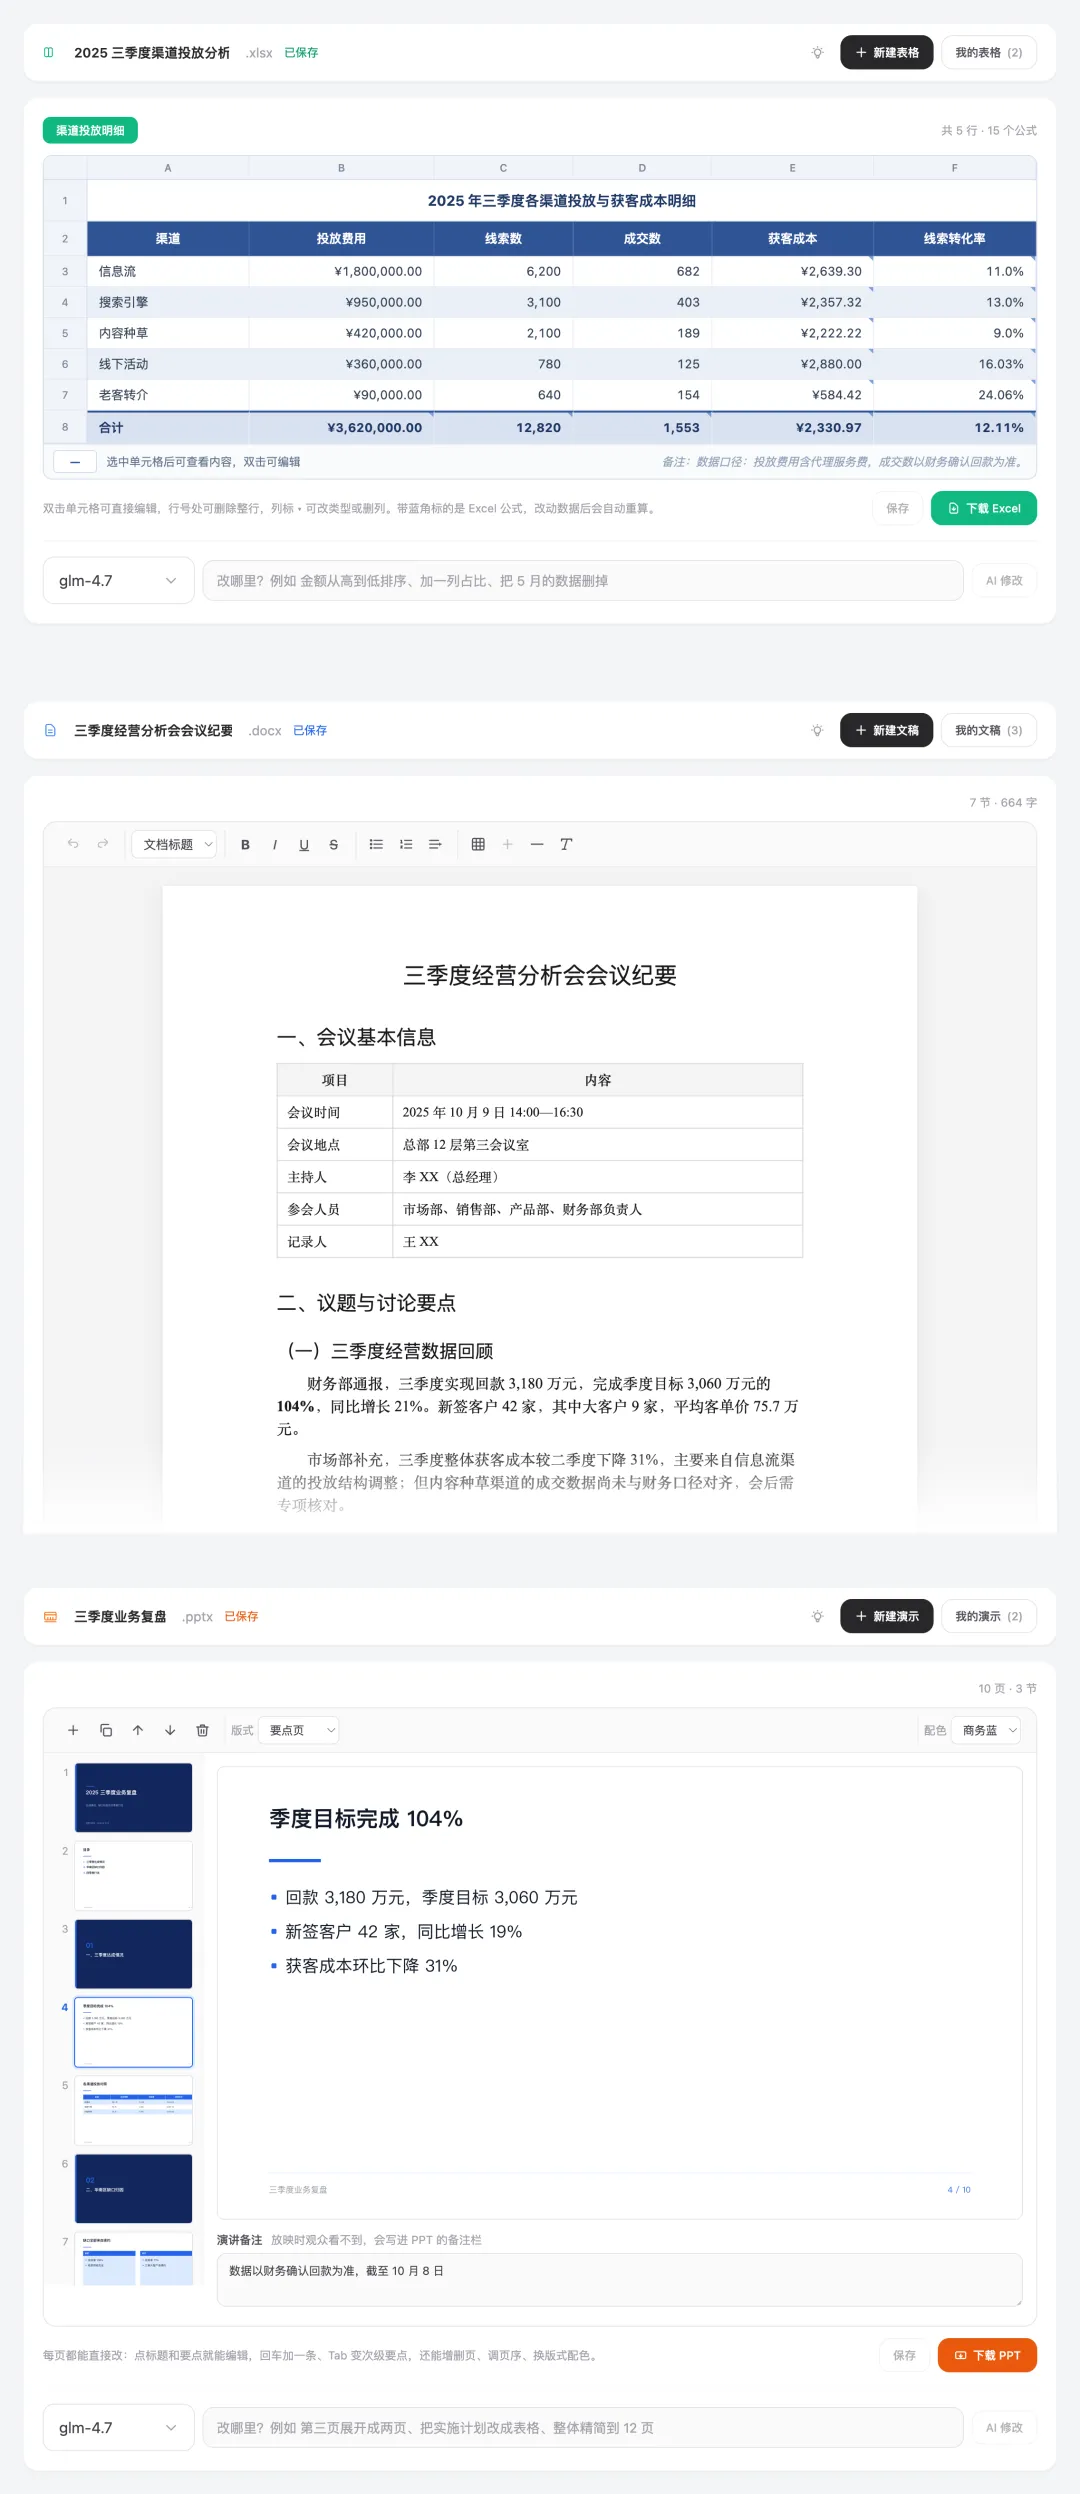
通用抽象是个陷阱。一开始想用一套文档 JSON 覆盖三种类型,看起来很干净。实际上表格和文稿在"结构精确 vs 内容完整"这个维度上的取舍方向是相反的,强行统一的结果是两边都不好用。**三个功能真正该共用的是存储层、配额、历史记录、素材导入这些外围能力,而不是内容的数据结构。**最后 offices 表确实是一张表、一套 CRUD 接口,用 type 字段区分——共用到这一层就够了。
能靠形状表达的,就别让模型声明。每多一个模型必须自己填对的元信息字段,就多一个失败模式,而且是校验器难以判定的那种失败模式。PPT 的版式推断本质上是把"模型声明 + 校验"换成了"模型写内容 + 规则推断",维护成本转移到了规则同步上,但错误率明显更低。
流式不只是体验优化,它改变了失败的代价。非流式场景里,生成失败就是白等两分钟、一无所有;流式场景里,用户看着内容长出来,觉得方向不对可以随时停,已经生成的部分照样留下可用。这个差别在长内容上非常明显,值得为它调整数据格式的选择。
校验器的价值在于错误信息的具体程度。只说"格式不对"的校验器基本没用,模型第二次还是错。把"第 2 个工作表第 7 行有 3 个单元格,与 4 列不匹配"这种信息回喂给它,一次就能改对。我们把重试次数从默认的 3 次降到 2 次,也是因为有了具体的错误信息,第二次改不对的情况极少,与其再试一次不如尽早失败。
这三个功能都在福兮的 AI 办公里(forxi.cn/ai),免费,浏览器打开就能用,生成的是标准 .xlsx / .docx / .pptx,用 Office、WPS 打开可以继续编辑。如果你也在做类似的东西,上面那些取舍和踩过的坑,希望能省掉你一点时间。