ARTICLE · 1011374
LLM Wiki:让你的文档堆,自己长成一个 Wiki
篇幅大约 9 分钟
每个人的硬盘里都有那么一个文件夹,名字可能叫「资料」「待读」或者「干货」。
里面躺着几篇没读完的论文、十几份技术白皮书、一堆 PDF 说明书、几十个 Markdown 笔记,还有从浏览器里另存下来的网页,文件名后面还带着 (1)。
真要用的时候,你明明记得自己存过,就是想不起在哪个文件里。搜文件名搜不到,最后转头去问 ChatGPT。
存下来的东西,最后只剩硬盘占用。
这事真正的难点在存进来之后:写摘要、建索引、把相关的文档互相挂上链接、发现新资料和旧结论打架。这堆活单调琐碎,一直没人愿意干。
今天要聊的这个项目,就是冲着这堆活来的。
😤 你现在的方案,每次都在从零开始
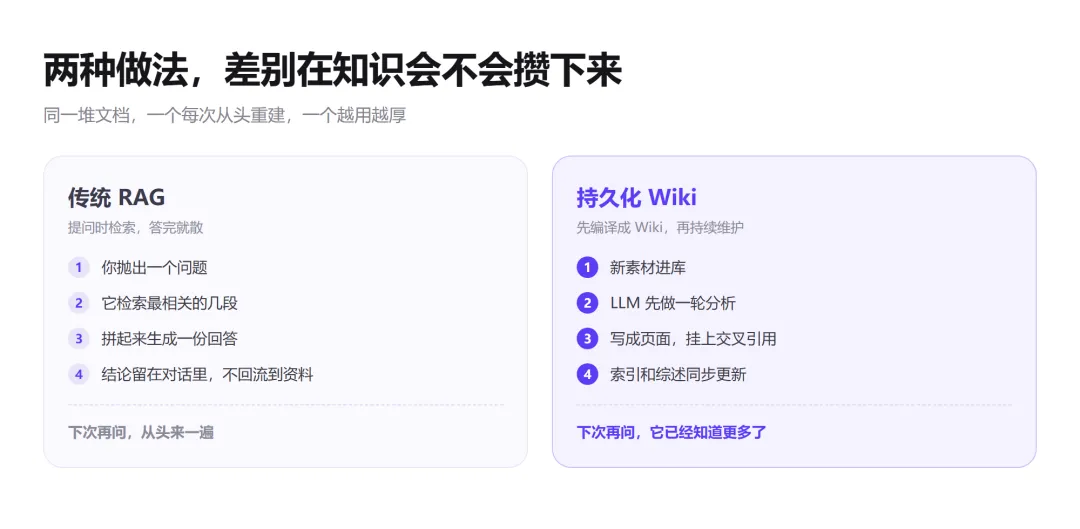
先说眼下最主流的做法:RAG。
你要是用过 NotebookLM、ChatGPT 的文件上传,或者自己搭过 Dify、RAGFlow 那一套,逻辑基本一样。你把一堆文件喂进去,提问的时候它去检索最相关的几段,拼起来回答你。
这条路能跑通,但它有个代价:它每次都在重新发现你文档里的知识。
举个具体的例子。你想问一个需要综合五份文档才能答上来的问题,那它每次都把那五份重新找一遍、重新读一遍、重新拼一遍。你昨天问过的问题、它昨天想明白的结论,今天一点都不剩。
知识没有被攒下来,只是被反复地路过。
💡 2026 年 4 月,Karpathy 发了一个想法
今年 4 月 4 日,Andrej Karpathy 在 GitHub 上发了一个 gist,文件名叫 llm-wiki.md。他自己说得很明白:这是一份抽象的想法文档,不是能直接跑的代码,建议你把它丢给自己的 AI Agent,让你俩一起把它落地。
里面的核心主张是这样的:与其在提问时从原始文档里检索,不如让 LLM 增量地构建并维护一个持久化的 Wiki。这个 Wiki 夹在你和原始素材之间,作为一层中间产物。
他用了两个词来描述这个 Wiki 的性质,我觉得很到位:persistent, compounding artifact(持久存在、会不断累积的产物)。
差别在哪?交叉引用已经建好了,新旧矛盾已经被标出来了,综述里已经包含了你看过的全部内容。你每加一份资料、每问一个问题,这个东西都会变得更厚一点。
他还给了一个特别传神的比喻:
Obsidian 是 IDE,LLM 是程序员,Wiki 是代码库。
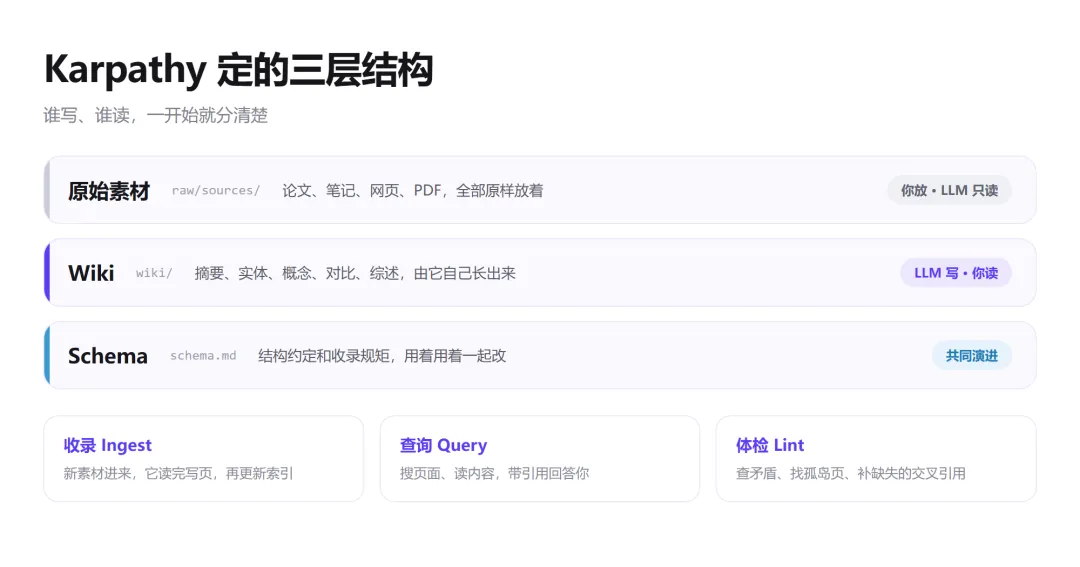
结构上他定了三层:原始素材放最底下,只读、不可改;Wiki 由 LLM 全权负责读写;最上面一层是 schema,用来告诉 LLM 这个库该怎么组织、遵循什么规矩。
操作上定了三个动作:收录、查询、体检。
最有意思的是他对「为什么这事能成」的解释。他说,维护知识库真正累人的部分在于记账。更新交叉引用、让摘要保持最新、记下新数据跟旧结论哪里冲突,这些活单调、琐碎、量还大。人放弃一个 Wiki 的原因基本都一样:维护成本涨得比它带来的价值快。
而 LLM 不会嫌烦,不会忘记更新某个链接,一口气能改 15 个文件。维护成本被压到接近零,这个库才有可能一直活下去。
🚀 4 天之后,有人把它做成了能直接用的桌面应用
想法是好想法,但 gist 是给人看、给 Agent 读的,你自己动手落地还是得折腾。
4 月 8 日,也就是那份 gist 发布 4 天后,一个叫 nash_su 的开发者建了这个仓库:nashsu/llm_wiki。
作者是 nash_su(Yong Su),前 OpenCSG 联合创始人,也是 IterCast / LinuxCast 的创始人,他之前的项目 FreeAskInternet 拿过 8.7k Star。
所以这个项目看得出是认真奔着「一个能天天开的桌面软件」去的。
🧠 它干活的方式:先想清楚,再动笔
原文的流程是 LLM 边读边写,一步完成。这个项目把它拆成了两次 LLM 调用:
第一次只做分析,不写任何页面。提取关键实体、概念、论点,对比已有 Wiki 内容,找出跟旧知识的冲突和张力,顺便给出 Wiki 结构的建议。
第二次才动笔生成,产出素材摘要页、实体页、概念页,更新索引和日志,再把需要人来判断的条目单独列出来。
分两步的好处是,写之前它已经知道这份新资料跟库里其他东西的关系了,而不是写到一半才发现撞车。
另外几个细节挺实用:
- SHA256 增量缓存
:文件在收录前先算哈希,没改过的文件直接跳过。你不会为了重跑一遍把 token 白烧一轮。 - 收录队列持久化
:串行处理,队列写盘,App 崩了重开还在,失败任务自动重试最多 3 次。 - 整目录导入
:递归导入并保留目录结构,文件夹路径本身会当作分类线索喂给 LLM。你把文件放在 papers/energy/下面,它就知道这批东西该归到哪类。 - 来源可追溯
:每个生成的页面里都带一个 sources: []字段,指回贡献了内容的原始文件。哪句话是从哪份 PDF 里来的,能查。
生成的目录长这样,前面两层是你放的,后面全是它自己长的:
my-wiki/
├── purpose.md # 这个库为什么存在
├── schema.md # 结构和规矩
├── raw/sources/ # 你丢进去的原始文档(只读)
└── wiki/
├── index.md # 内容目录
├── log.md # 操作日志
├── overview.md # 全局综述
├── entities/ # 人物、组织、产品
├── concepts/ # 理论、方法、技术
├── sources/ # 素材摘要
├── synthesis/ # 跨素材分析
└── comparisons/ # 对比页
🕸️ 两件原始构想里没有的事
如果只是把 Karpathy 的想法工程化,那这个项目的价值也就是「省事」。它真正超出原始构想的部分在下面两处。
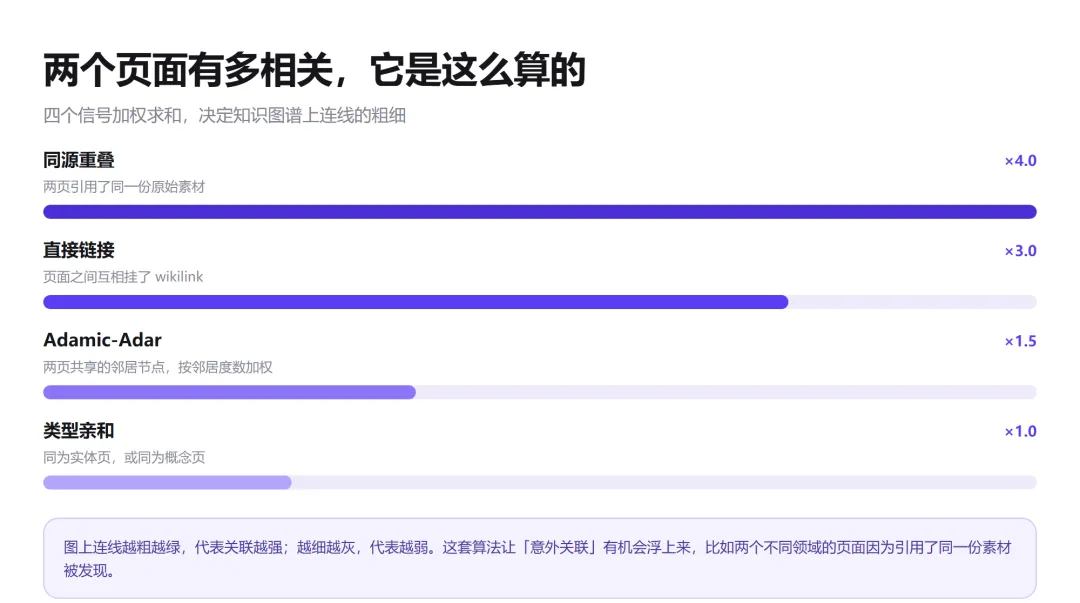
第一是知识图谱。
页面之间不只是 [[wikilink]] 单向相连,它建了一套四信号的相关性模型:
在图上,节点大小按链接数开方缩放,连线粗细和颜色代表相关度强弱。鼠标悬停时邻居保持高亮,非邻居淡出。
第二是自动发现知识缺口。
它用 Louvain 算法做社区发现,让页面自己抱团,跟你预设的分类无关。每个团会给一个凝聚力分数,低于 0.15 的会被标出来提醒你:这块内容内部链接太稀,还没长结实。
更有意思的是三种缺口的自动识别:
- 孤立页面
(连接数 ≤ 1),你自己都忘了还存过这个 - 松散社区
(凝聚力 < 0.15 且至少 3 个页面),看着像一片知识区,其实内部没串起来 - 桥接节点
(连着 3 个以上社区),少数几个把多块知识缝在一起的关键页面
点开任何一个缺口,可以直接触发 Deep Research。它会读 overview.md 和 purpose.md 生成针对性的搜索主题,走 Tavily、SerpApi 或 SearXNG 去网上找,找到的结果再自动收进库里。
这条路径是我觉得最像「活的」的地方:它不光整理你已有的东西,还会告诉你缺什么,然后自己去找。
🔌 它不打算把你锁住
这一点值得单独说,因为 AI 笔记类工具踩坑最多的就是这里。
数据是你的纯 Markdown。 整个 Wiki 就是一个目录下的 .md 文件,加上 YAML frontmatter。项目还能自动生成 .obsidian/ 配置目录,也就是说这个目录你直接拿 Obsidian 当 vault 打开就能用,图谱视图、双链、插件全都照常。哪天你不想用这个 App 了,文件还在那,一个都不会少。
它自带 MCP Server 和本地 HTTP API。 服务跑在 127.0.0.1:19828,只监听本机,带 token 校验。Claude Code、Codex 这类 Agent 可以接进来查你的库。官方还准备了一个现成的 skill,一条命令装进 Claude Code:
npx skills add https://github.com/nashsu/llm_wiki_skill.git --skill llm-wiki
装完之后,你在 Claude Code 里直接说「我的知识库里关于 XX 写了什么」,它会去调本地那个正在跑的 App,返回答案并给出页面路径,方便你回 App 里核对。默认只读。
这个设计的价值在于,你攒下来的这份 Wiki 由此变成了一台外部大脑,随时能接进 Claude Code、Codex 这些工具里干活。
⚙️ 想试的话,从哪下手
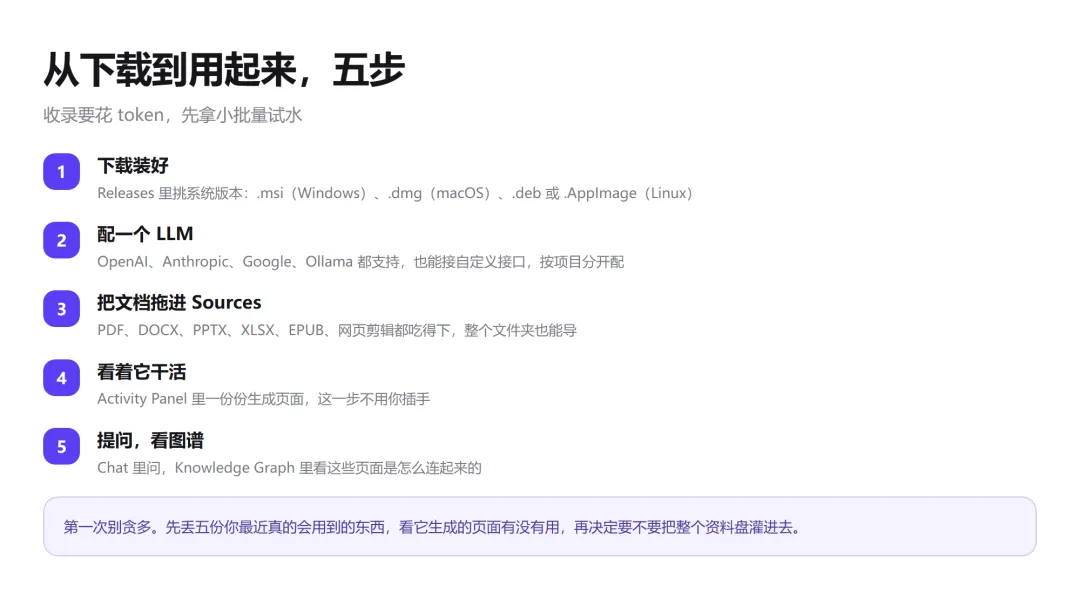
最省事的是下安装包,去 Releases 页面按系统挑:
macOS: .dmg(Apple Silicon 和 Intel 都有)Windows: .msiLinux: .deb或.AppImage
想从源码构建的话,前置要求是 Node.js 20+、Rust 1.88+ 和 protoc:
git clone https://github.com/nashsu/llm_wiki.git
cd llm_wiki
npm install
npm --prefix mcp-server ci && npm run mcp:build
npm run tauri dev # 开发模式
npm run tauri build # 生产构建
装好之后的流程大概是:
建项目,从 Research / Reading / Personal Growth / Business / General 里挑一个模板 进 Settings 配 LLM,支持 OpenAI、Anthropic、Google、Ollama 和自定义接口 去 Sources 把 PDF、DOCX、EPUB、网页剪辑拖进去 看 Activity Panel 里它一份份生成页面 用 Chat 提问,用 Knowledge Graph 看关联 偶尔跑一次 Lint,让它自查矛盾和孤岛
📊 横向看一圈,同类工具怎么选
这类工具最近冒出来不少,我顺手把三个常被拿来比的也核了一遍数据(2026-09-14 查):
给个直接的判断:
个人整理文档、想要一个能长期攒下来的库,选 LLM Wiki 团队要统一知识库,还得接飞书、GitLab、Notion 并且管权限,看 WeKnora(部署要 Docker,个人用偏重) 你想让 AI 跑十几个小时产出一份调研报告,那是 Hyperresearch 的活 你要做的是可复现的实验而不是文档整理,看 OpenResearch 已经在用 Obsidian、不想贡献一个新的数据孤岛,LLM Wiki 能直接兼容
⚠️ 几个提前知道的事
收录是要花 token 的。 工具本身免费,但你得自己有 LLM 的 API key。一次性灌几百份文档,账单不会小。好在有 SHA256 增量缓存,不会重复烧。
复杂版面 PDF 建议配 MinerU。 内置的 pdf-extract 处理普通 PDF 够用,扫描件或者双栏论文那种复杂排版,可以选配 MinerU Cloud 或本地模式,本地模式不上传文件。
版本还在 0.6.x。 从 4 月到现在五个月更到 v0.6.11,迭代节奏挺快,功能还在长。指望它像成熟商业软件那样稳,现在还早。
GPL-3.0 是有传染性的。 自己用完全没问题,想拿它的代码改一改做成闭源产品,就得先想清楚协议的事。
向量检索默认是关的。 这是可选项,开了之后准确率会更好(官方 README 给的数据是召回率从 58.2% 提到 71.4%),但要额外配 embedding 接口。默认的「关键词检索 + 图谱扩展」路径已经能用。
🎯 最后说一句
这个项目最打动我的地方,是它把维护知识库这件事的成本,真正降到了接近零。
Karpathy 那份文档里说得很清楚:人放弃一个 Wiki,是因为记账的活涨得比价值快。LLM 恰好最擅长的就是这种活。
所以你可能不需要现在就去建一个知识库。你可以先做一件小事:
把那个吃灰的「资料」文件夹,挑出五份你最近真的会用到的东西,丢进去跑一遍。
五份就够。你会很快知道它生成的页面有没有用,也知道自己到底需不需要这么一个东西。
你要是已经试过类似的方案,或者觉得这条路走不通,评论区聊聊,我挺想知道别人是怎么处理自己那堆文档的。
📚 参考资料
LLM Wiki 仓库:https://github.com/nashsu/llm_wiki Karpathy 的原始 gist(llm-wiki.md):https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f LLM Wiki 的 Agent Skill:https://github.com/nashsu/llm_wiki_skill 腾讯 WeKnora:https://github.com/Tencent/WeKnora Hyperresearch:https://github.com/jordan-gibbs/hyperresearch OpenResearch:https://github.com/alphaXiv/OpenResearch
XFactor实验室 · 用不确定,做出确定的东西