ARTICLE · 1018992
我做了个不破坏版式的 PDF 翻译器,内测期间免费,邀请你一起共创
你上一次真正读完一份外文资料,是什么时候?
不是用翻译软件"囫囵吞枣"看个大概,而是真吃透了细节、敢照着它动手、敢把里面的数据引用进自己方案的那种"读完"。
上个月做 PDF 解析这块功能,关键实现全藏在一篇 40 页的英文论文里。第二天一早要给客户看 demo,我只能连夜啃。为了省时间,我随手找了个在线 PDF 翻译工具,等了五分钟,满怀期待打开下载好的文件,结果血压直接飙到 180:
公式成了"外星文"。 LaTeX 源码直接糊在正文里,符号散成一堆方块和问号。我知道那是个核心公式,但我根本不知道它在算什么。
表格玩起了"连连看"。 一整张完整的对比实验表,被粗暴拆成一列一列的孤立数字。0.923、0.871 排在那儿,哪行是基线模型、哪个是召回率,全靠肉眼猜。
双栏排版疯狂"串台"。 左栏的半句话直接接上了右栏的半句话——"我们在 ImageNet 上进行了"后面紧跟着"结果表明本方法显著优于",中间最关键的实验过程人间蒸发。
最让人崩溃的是什么?是翻译完之后,你根本不敢信它。
你不得不把原版 PDF 开在旁边,像玩"大家来找茬"一样,一句一句对比它翻错了没有。我算了一下,花在"给机翻结果纠错"上的时间,比直接硬啃生肉还多。
还有一类文档,你连扔进翻译器的勇气都没有:项目还没公开的实验数据、公司的技术白皮书、跟客户签的保密合同。因为绝大多数在线翻译,都要求你把文件传到他们的服务器上。
我被这事卡了不止一次,最后干脆自己写了一个。自己用了几个月,现在拿出来给同样有这个麻烦的人用——内测期,工具本身完全免费。
一、它是什么
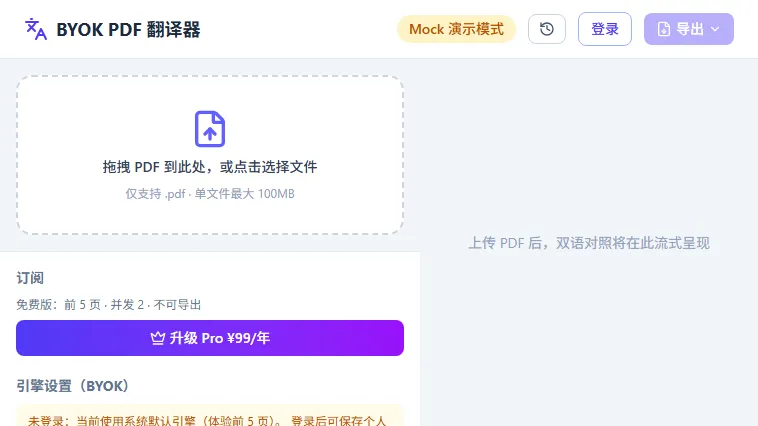
一句话:一个尽量不破坏排版的 PDF 翻译工具。
上传英文 PDF,左边原文、右边译文,一段一段对照着往下读。译完一块出一块,不用等整篇慢慢跑完。
它跟别的翻译工具最大的区别只有一条:公式、表格、代码块这些东西,它不动。
二、它能替你解决哪些麻烦
1.双栏论文串行
"我们在 ImageNet 上进行了"后面紧跟着"结果表明本方法显著优于"——中间的实验过程人间蒸发。这是双栏 PDF 最常见的死法。
它会先做版面分析,认出哪块属于左栏、哪块属于右栏,再按正确的阅读顺序重排。
2.公式和表格碎掉
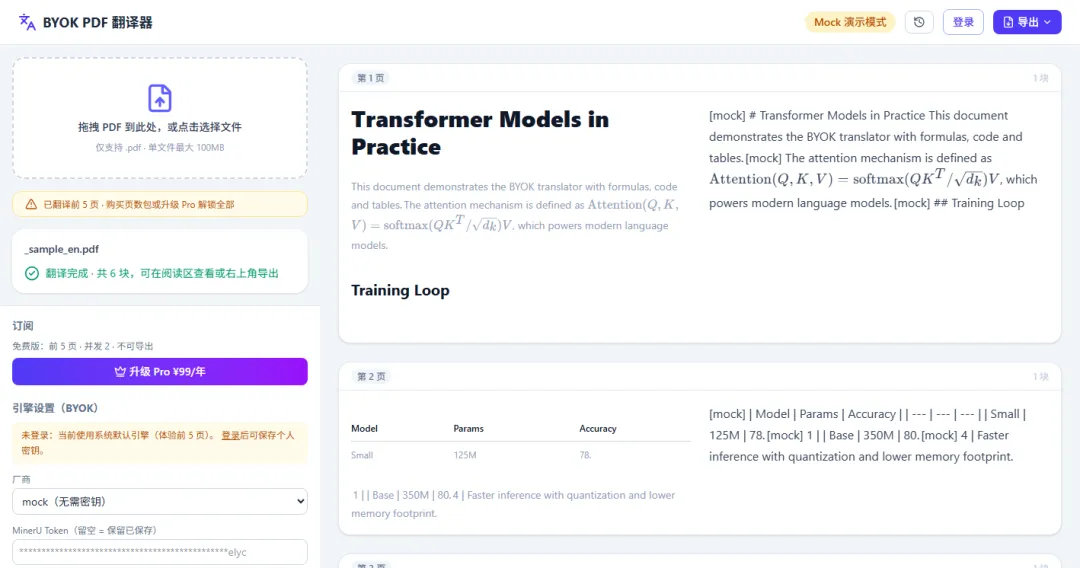
图里 Attention(Q,K,V) = softmax(...) 那段公式是原样保留的,不是翻译出来的——它压根没被送进模型。表格同理,结构完整,不是散成一串孤零零的数字。
3.术语前后不一
同一篇文档里,Agent 前面翻译成"代理"、中间叫"智能体"、结尾变成"特工",你怀疑自己看了三篇不同的文章。
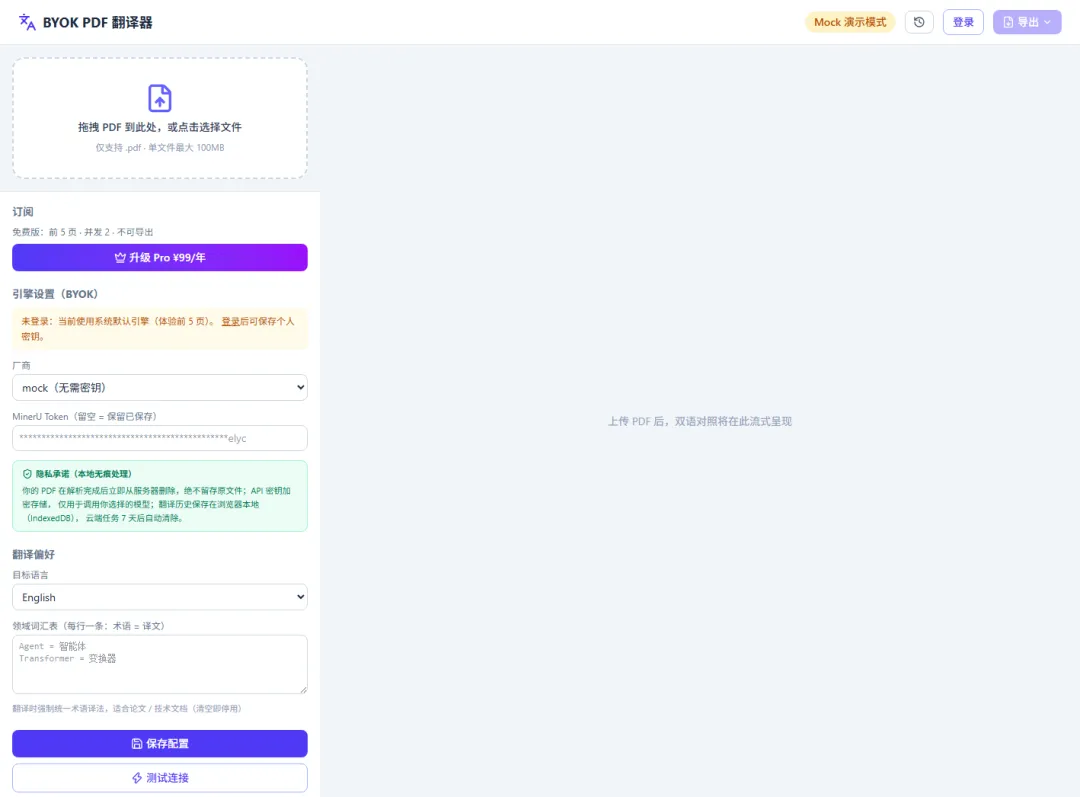
设置里可以填术语表:Agent = 智能体、Transformer = 变换器,一行一条,全篇强制统一。
4.不敢往外传的文档
项目还没公开的数据、公司的技术白皮书、跟客户签的保密合同——大部分在线翻译都要你把文件上传到他们的服务器。
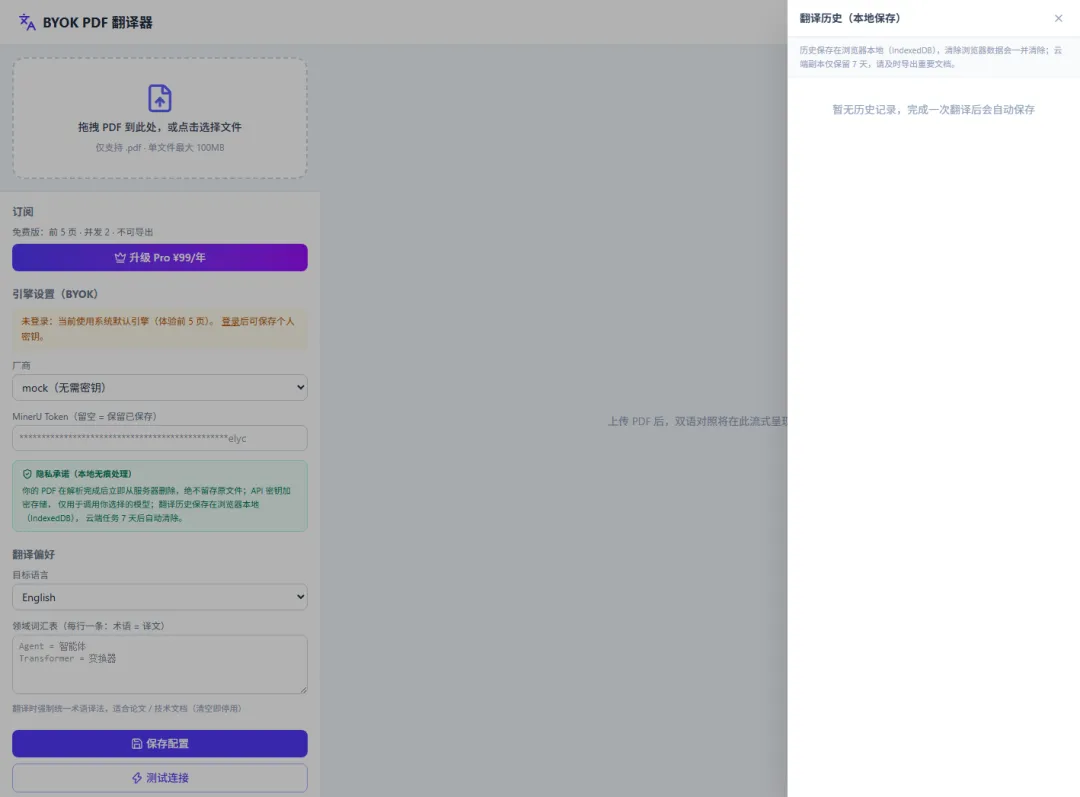
这个工具的做法是:文件解析完立刻从服务器物理删除,不留存;翻译历史存在你自己的浏览器本地,连我都看不到你在读什么。
三、邀请你一起共创
内测的意思就是它还不完善。我知道它翻某些文档还是会出问题,但我一个人能撞到的文档类型实在太有限。
所以如果你手上有这几类"硬骨头",真心欢迎拿来砸它:
1. 密密麻麻的生化、医学表格
2. 满屏推导公式的数学或算法教材
3. 扫描版的老论文(没有文本层的那种)
4. 中英混排、带大段代码的技术手册
砸坏了请在评论区告诉我是什么文档 + 坏在哪儿,或者直接截图发到后台。我按真实文档一版一版修解析逻辑。
最后说一句:这个东西最初只是我自己读论文用的。如果能让同样被外文资料卡住的人少熬一个晚上,它就值了。
你现在手上最难啃的那份 PDF 是什么样的?评论区聊聊。