ARTICLE · 1034257
蛋白版RLHF来了:AI开始根据实验结果“自我进化”
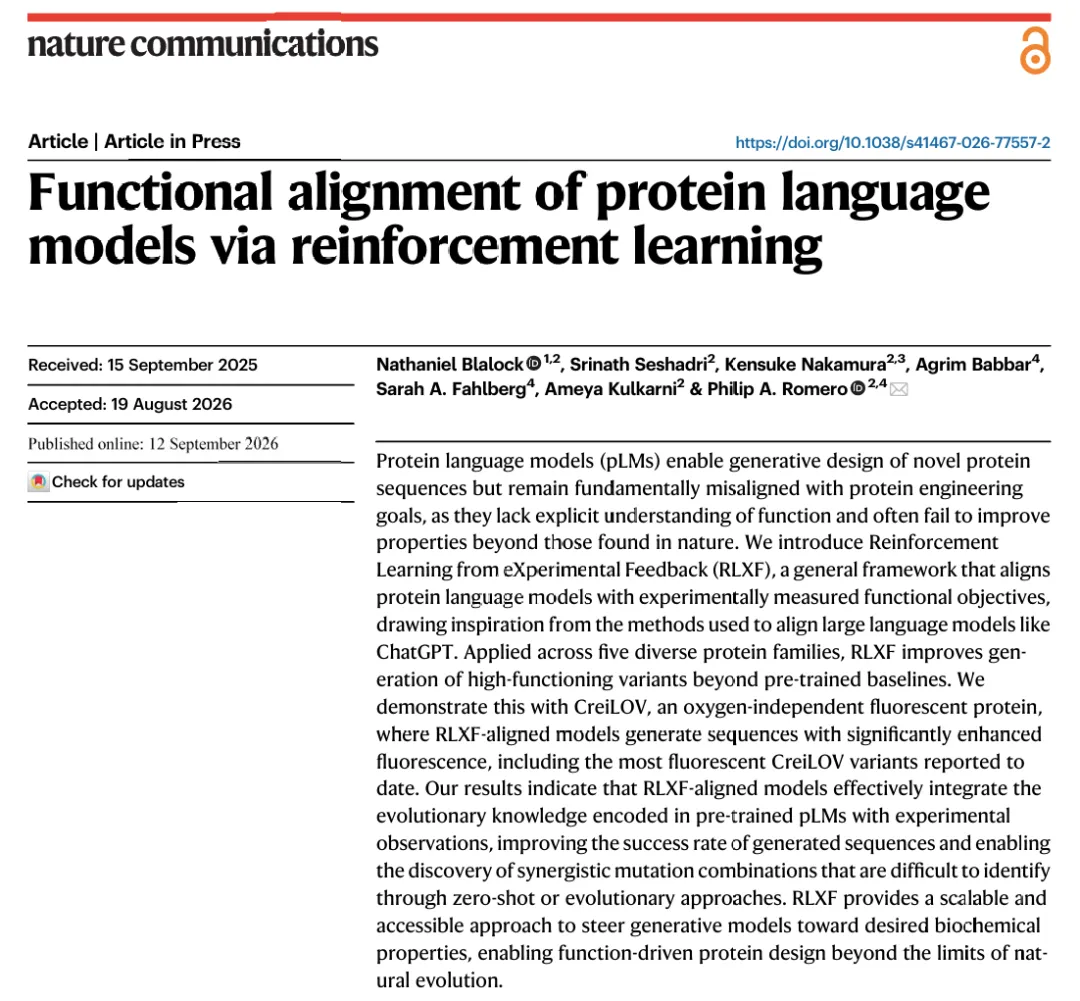
蛋白语言模型现在已经可以生成大量全新蛋白序列,但有一个根本问题:
它们学的是“自然界里什么蛋白最像真的”,不一定学的是“什么蛋白对人类工程目标最好用”。
2026年,Nature Communications 发表研究:
Functional alignment of protein language models via reinforcement learning
作者提出:
RLXF
Reinforcement Learning from eXperimental Feedback
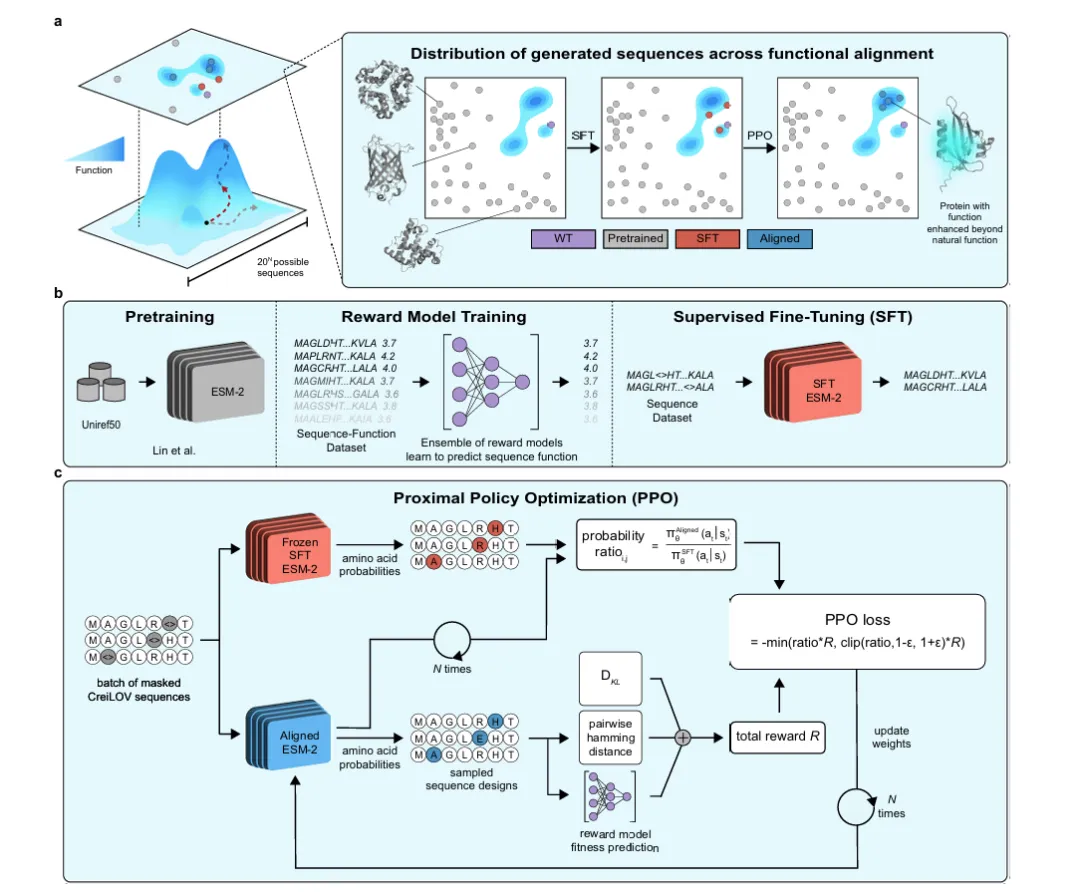
它的核心思路和ChatGPT的RLHF非常像:用实验功能数据作为反馈信号,把预训练蛋白语言模型从“模仿自然蛋白”重新对齐到“优化目标功能”。
Pretrained ESM-2 → Reward Model → SFT → PPO → 生成高功能蛋白。
01 为什么预训练蛋白语言模型还不够?
ESM-2等蛋白语言模型主要从天然蛋白序列中学习进化规律。
这意味着它们很擅长判断:
“什么序列像自然界会存在的蛋白?”
但蛋白工程真正想问的是:
“什么序列能比自然蛋白更亮、更稳、更能结合、更耐热?”
天然进化并不会主动优化这些人工目标,因此预训练模型经常倾向保留进化保守序列,而不是主动探索高功能突变。
RLXF就是为了解决这个错位。
02 它几乎就是蛋白版RLHF
RLXF分成两个阶段:
第一步:SFT
先训练一个Reward Model,根据已有实验数据预测序列功能,再找出高评分序列,让ESM-2先“学会什么样的突变可能更好”。
第二步:PPO
模型自己生成序列,Reward Model给分,再用强化学习不断调整生成概率。
最终模型会越来越偏向:
“高功能 + 多样性 + 不偏离原始蛋白知识太远”
而不是只追求“像天然蛋白”。
03 五类蛋白上都能把模型往“更好功能”方向推
作者把RLXF应用到5种不同蛋白:
Pab1、Bgl3、Ube4b、avGFP、GB1
覆盖RNA结合、酶活、泛素化、荧光和IgG结合等不同功能。
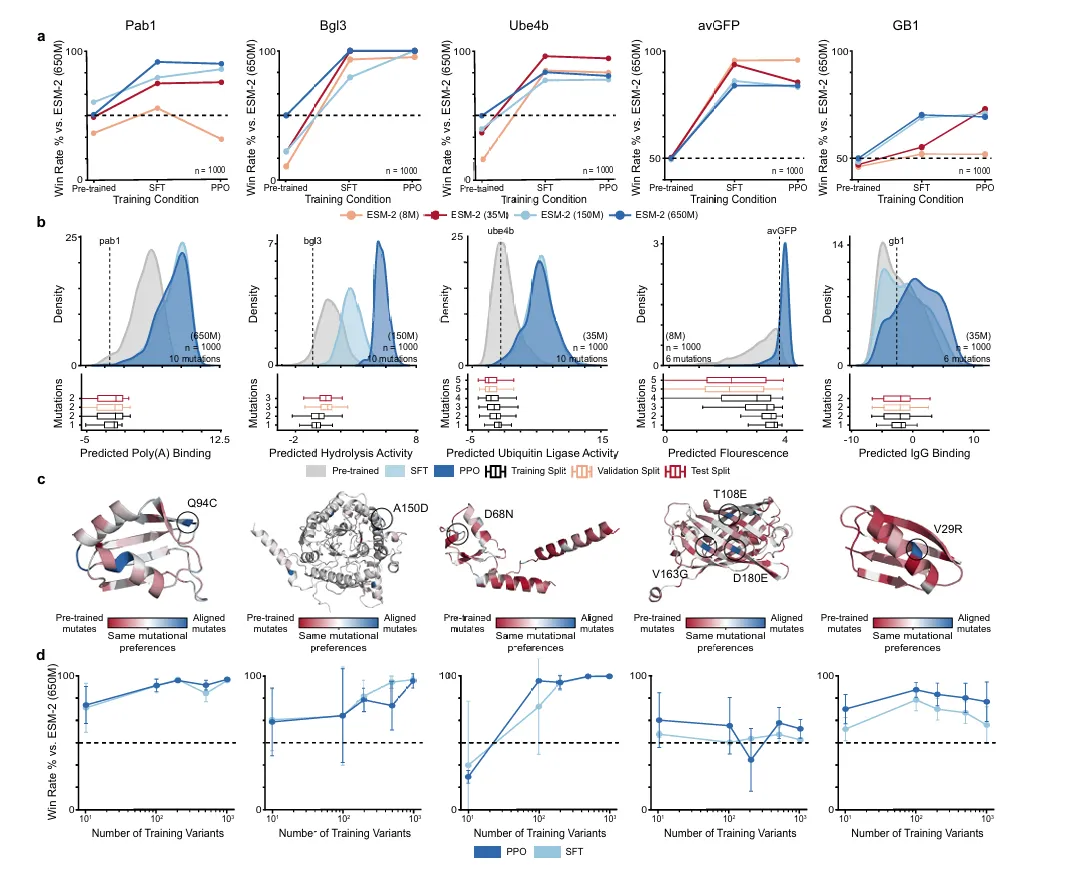
结果显示,不同规模的ESM-2经过RLXF以后,生成高功能序列的win rate普遍提高,而且很多时候SFT已经带来很大提升,PPO再进一步优化。
更重要的是,RLXF开始主动选择一些:
“进化上不常见,但实验功能更好”的突变。
例如GB1中,RLXF偏好V29R,结构上可能形成新的盐桥;avGFP中则富集V163G、D180E、T108G等已知有利于亮度和稳定性的突变。
展示不同蛋白体系中,预训练模型、SFT和PPO生成结果的差异。
04 只有10–100条实验数据,也可能开始有用
真实蛋白工程最大的问题之一,就是数据少。
作者专门测试了low-N场景。
结果显示,在部分蛋白家族中,即使Reward Model只用:
10–100条实验序列
RLXF也能把生成结果推向更高预测功能。
当然,这有一个前提:
预训练模型本身对这个蛋白家族要有比较可靠的进化先验。
如果某个蛋白家族在自然序列数据库里覆盖很差,RLXF也会更难优化。
05 真正的实验高潮:把CreiLOV变得更亮
作者随后选择了:
CreiLOV
一种不依赖氧气的荧光蛋白。
它特别适合低氧环境,比如:
肠道、肿瘤微环境、高密度发酵体系
但天然CreiLOV比GFP暗很多。
问题是:
“更亮”并不是CreiLOV自然进化的目标。
所以预训练ESM-2反而倾向保留天然C43,而不是选择已知能够增强荧光的C43A。
RLXF加入实验荧光数据以后,这个偏好被彻底改变。
模型开始主动选择:
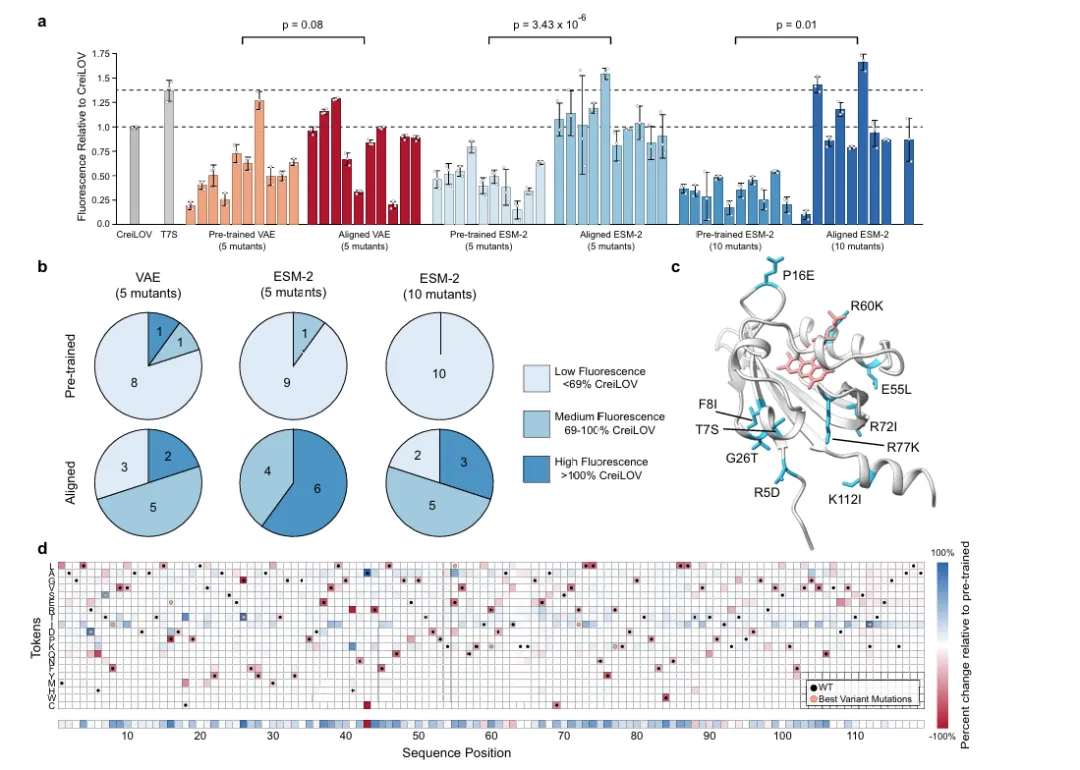
C43A、R5D、T7S、G26T、K112I
等与高荧光相关的突变。
06 实验真的亮了,而且超过此前最亮版本
作者最终测试了60个设计序列。
结果非常直接:
RLXF生成的序列明显比预训练模型生成的更亮。
其中RLXF-aligned ESM-2的5突变版本中:
6/10亮度超过原始CreiLOV。
更重要的是:
3个设计超过此前已知最亮的CreiLOV-T7S。
最佳的10突变版本相较CreiLOV-T7S:
荧光进一步提高约1.2倍。
直接展示RLXF设计蛋白的真实荧光提升,以及最佳10突变结构。
07 最有意思的一点:AI学到了“突变组合”,不是简单叠加
作者还做了一个很关键的对照:
如果直接把单突变实验中排名最好的5个或10个突变简单叠加,
反而得到不工作的蛋白。
而RLXF生成的高功能序列却能工作。
这说明:
蛋白工程不是“把最好突变加在一起”这么简单。
真正重要的是:
epistasis,上位性和突变间协同作用。
RLXF的优势之一,就是有机会学习:
“这个突变单独看一般,但和另外几个突变组合以后,整体功能会更强。”
这恰恰是传统单点筛选最难发现的部分。
08 但强化学习有一个非常现实的风险
RLXF的核心是Reward Model。
所以:
Reward Model学错,RLXF就会非常认真地朝错误方向优化。
文中Pab1就是一个很好的例子。
Reward Model训练数据里Q94C被认为是高功能突变,因此RLXF也强烈偏好Q94C。
但原始DMS研究后来发现:
Q94C其实是实验假阳性。
于是AI把这个错误也学了进去。
这也是强化学习最重要的一句话:
You get what you optimize for.
你优化什么,模型就会拼命学什么。
所以实验数据质量,很可能比模型规模本身更重要。
写在最后
这篇论文真正改变的不是:
“又出现一种蛋白生成模型。”
而是蛋白AI的训练逻辑。
过去:
Evolution → Train AI → Generate protein
模型主要学习自然进化留下来的序列。
RLXF则变成:
Evolutionary knowledge
Experimental feedback Reinforcement learning→ Human-defined protein function
也就是说,AI蛋白设计开始从:
“模仿自然界”
进一步走向:
“根据实验结果主动超越自然界”。
未来如果把这个流程接入自动化实验平台,就可能形成:
AI生成 → 自动实验 → 得到反馈 → Reward Model更新 → 强化学习 → 再生成
一个真正闭环的:
Self-driving protein engineering
作者也明确提出,RLXF未来可以进一步整合溶解性、免疫原性、结构能量等多目标Reward,用于自动化蛋白工程。
论文:Functional alignment of protein language models via reinforcement learning
Nature Communications, 2026,Article in Press。
代码和训练后的CreiLOV RLXF-ESM2模型均已公开。
往期好文推荐

往期课程推荐