ARTICLE · 1039570
卸载到 DRAM 更快,卸载到 SSD 更贵:DeepSeek Engram 实测
周五把 SemiAnalysis 那篇 Engram 的新文章翻了两遍。开头一句是英伟达把 Rubin Ultra 的 HBM 从原定的 1024GB 砍到 200GB 上下,跟着一句是"模型结构会在约束里继续创新"。DeepSeek 今年 1 月发的 Engram,方向正好落在同一侧。
这篇文章里最值钱的部分是 SemiAnalysis 自己搭的那套卸载实验。他们把 Engram 的查找表分别放在 HBM、host DRAM、本地 SSD 三个位置跑了一遍,结果一个比一个反直觉。搬到 DRAM 比留在 HBM 快,搬到 SSD 比 DRAM 贵。
先把 Engram 说清楚,再说这三个位置。
Engram 把静态检索变成一次查表
DeepSeek 和北大在 2026 年 1 月发的论文叫《Conditional Memory via Scalable Lookup》,代码开源在 deepseek-ai/Engram。机制不复杂:输入 token 先做 2-gram 到 n-gram 的滑窗切分,每一段用哈希函数算出一组索引,再去一张极大的 embedding 表里取行,取回来的向量和隐藏状态融合。取哪几行只由 token ID 决定,跟 hidden state 无关。
Engram 对付的是 Transformer 的一个老毛病。识别"戴安娜,威尔士王妃"这样一个实体,模型要烧掉六层以上的注意力和前馈去逐步组合特征,答案却一直躺在表里。论文给的原语是 O(1) 查询。
论文里有个我记住的结论:稀疏参数预算的分配是 U 型的。全给 MoE 不行,全给 Engram 更不行,最优区间在 MoE 拿 75%-80%、Engram 拿 20%-25%。10B 规模上的具体数字是验证损失从 1.7248(100% MoE)降到 1.7109(ρ≈80%),差 0.0139。
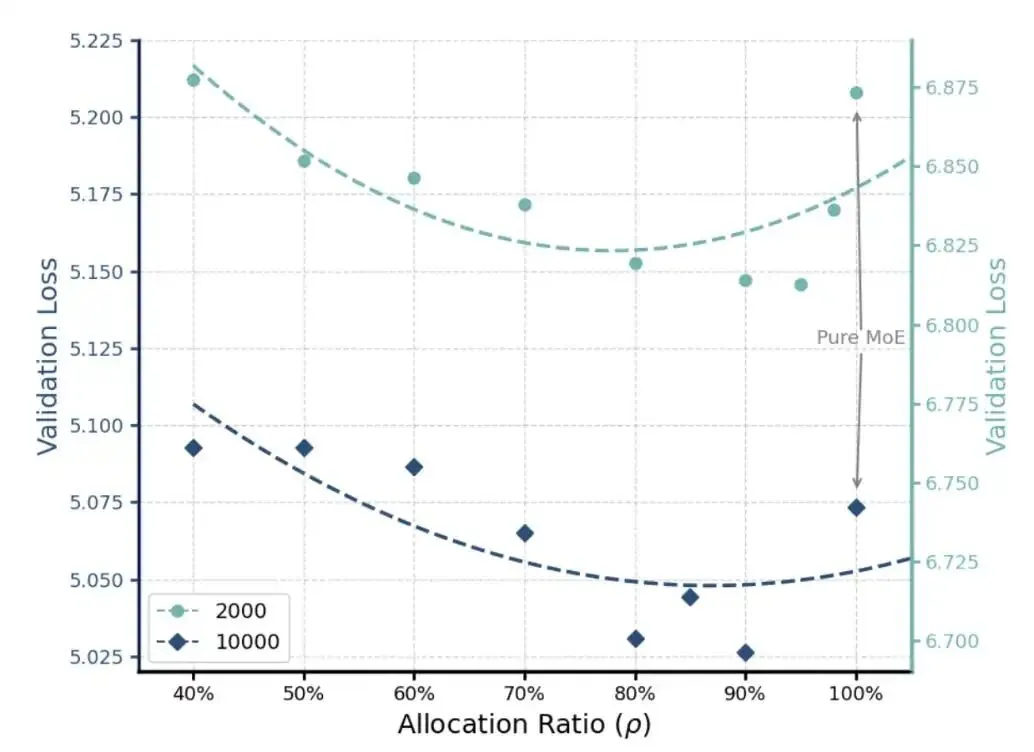
SemiAnalysis 做了论文没做的事。DeepSeek 没有放出论文里那两个训练好的 Engram 模型,他们就用开源代码和超参在 fineweb-edu 上自己跑了一遍,每次约 6E18 FLOPs,复现出了同一条 U 型曲线。
能卸载的前提,是地址在算之前就确定
卸载的难处来自时序:什么时候才能知道要取什么。
MoE 的路由要等 hidden state 算出来才知道激活哪些专家,对应的专家权重没法提前从 CPU 内存搬上来。业界搞了这么多年 MoE offloading,卡的就是这一步的不可预测性。
Engram 绕开了这一步。地址只依赖 token ID,运行时在浅层还在算的时候,就能按 token 序列把后面要用的表行从 host DRAM 预取上来,不用搬整块权重矩阵。这属于模型结构层面的协同设计。
DRAM 卸载:把 HBM 让给 KV cache
先说这张表有多大。SemiAnalysis 给 DeepSeek-V4.1-Flash 配的那套推理配置里,Engram 表约占 189 GiB 主机内存。他们把这块内存换成 DRAM 上的映射文件,再测服务性能。
数据的可信度值得交代一句:InferenceX 这套基准被谷歌云、微软 Azure、甲骨文、Meta 等主要算力买方复现或支持过,vLLM、LMCache、SGLang、PyTorch、Hugging Face 这些框架侧,以及 OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi 等实验室也公开背书。数字不是单方自报。
SemiAnalysis 的实测里,HBM 卸载和 DRAM 卸载用的是同一个 GPU kernel 做选行和反量化,区别只在读的是显存还是 pinned 主机内存(UVA),两边都支持完整的 decode graph。
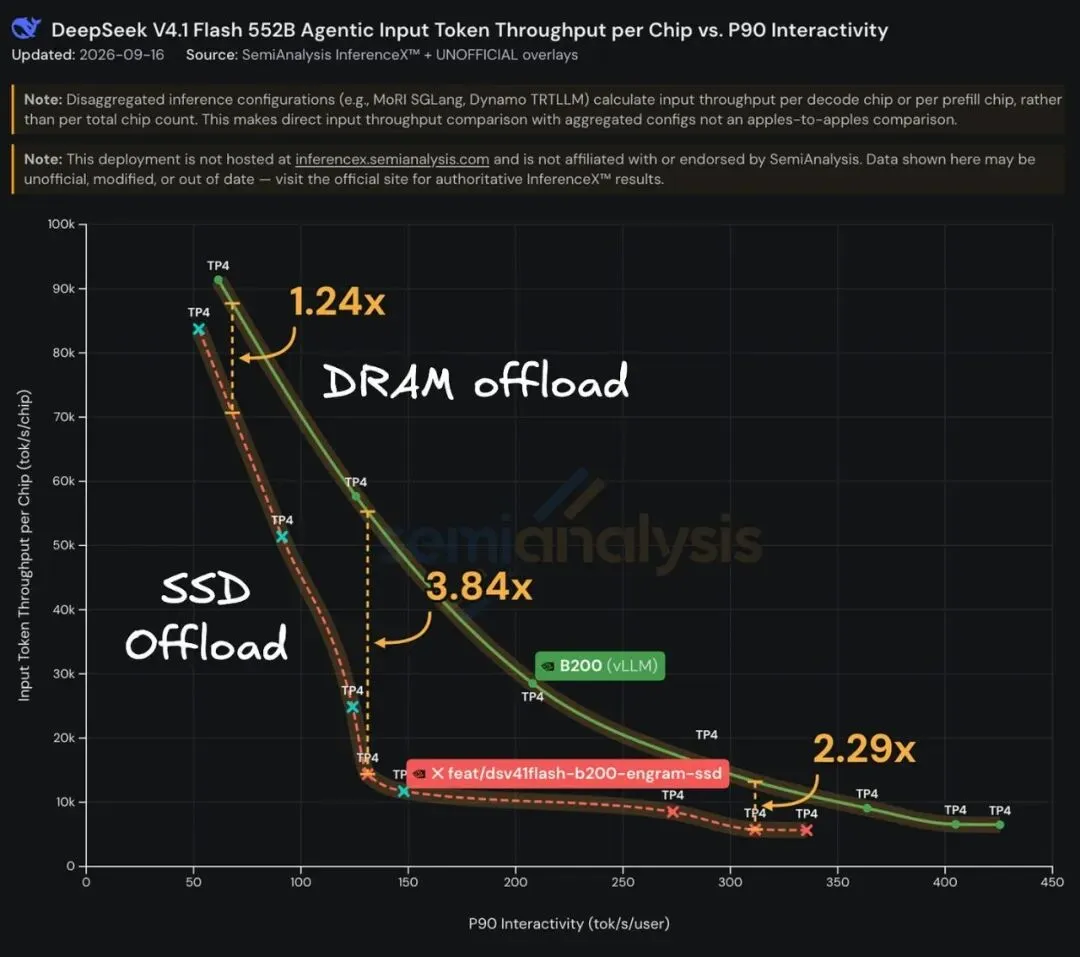
把表塞回 HBM,只让稀疏查表那一步变快,解码计算和卡间通信一点没变。收益很小,代价是吃掉本该留给 KV cache 的显存。反过来把表卸到 DRAM,每副本可以用更少的 HBM 卡来降通信开销。在 B300 上开 Engram 卸载,他们从 TP4 切到 TP2,pareto 曲线最高改善 1.6 倍。
在 B300 和 week-0 的软件栈上,他们把表搬回 HBM 试了一次,结果没有改善,落在运行间波动范围里。DRAM 卸载路径上的 async 和 overlap 优化已经把这点差距吃掉了。
同一个模型质量下 HBM 需求更低,HBM 带宽就比 HBM 容量重要得多。这个判断我在两周前写 4-hi HBM 那篇时写过一次,这次是同一结论的另一条证据链:那篇讲的是每栈带宽怎么算,这篇讲的是容量怎么被模型结构省下来。
分界线在哪
这篇文章里的卸载,能用的和不能用的大致这么分。
能卸载的:Engram 表这类地址确定、访问局部、每个 token 只取几十行的静态查表。DeepSeek-V4.1-Flash 在两层 Engram 各请求 24 行,全模型每个 token 位置约 12.4 KiB,四卡拆开后每卡 3.1 KiB。这个量级 DRAM 扛得住。
不能卸载的:MoE 专家权重,以及任何要等 hidden state 才能定地址的参数。
还有一种做法看着可行,实际不行:靠 gate 分数挑热点行。gate 分高的行不一定是缓存最热的行,gate 分低的行也不一定能省掉读取,因为算 gate 本身就得先把对应的 key 取回来,取回来那一步已经把融合 kernel 的收益吃掉了。
SSD 卸载:便宜存储没换来便宜推理
最反直觉的是 SSD 那组。他们在 B200 上做了个未优化的 vLLM fork,把 Engram 表放进本地 SSD 上的 mmap 文件。文件后端的好处是 OS 可以在别的进程要内存时回收表页,已经在内存里缓存的页也不用再读盘。他们没打开 GDS。
问题出在表行到达 GPU 的路径上。未优化的实现要把 row ID 拷到 CPU、去重、把请求的行聚进 pinned buffer、再拷回 GPU 反量化,这一串跑在 GPU 执行图的段与段之间。原生 UVA 直接在 GPU 上完成选行和反量化,省掉整个 CPU 往返。热的文件缓存能消掉物理读盘,但协作、聚行、传输这三步还在。所以一个已经缓存在 RAM 里的文件,性能仍然可能不如一张 pinned DRAM 表。
数字很干脆。B200 上,DRAM 在总 token/$ 和 P90 交互性两个维度都压住 SSD。在 125 tokens/s/user 附近,DRAM 是每 1 美元 1.21 亿 token,SSD 是 5200 万。每一个观察到的 SSD 点,都能找到一个 DRAM 备选给出更高的 P90 交互性和更多的 token/$。
SemiAnalysis 那句话可以直接抄进采购逻辑:便宜的存储不会自动变成便宜的推理服务。把 Engram 挪到 SSD,四块贵 GPU 和整台服务器都还在原地。回收出来的 RAM 只有在能换成更便宜的配置、或者多接一份有用容量时才值钱,而当前这条未优化的路径两样都给不了。
表里到底存了什么
SemiAnalysis 还做了一件论文里看不到的事:扫 DeepSeek-V4.1-Flash 的 gate 分数,看它到底在为哪些 n-gram 开记忆。扫出来的是人名、代码片段、关系性短语,以及大量模板文本。这批例子的挑选标准是有趣程度,不是 gate 强度,所以只能当线索看。
他们在这一节抽出的判断值得记:学到的记忆在优化训练目标,不在判断哪些事实值得存。许可证文本、参考文献片段、API 脚手架、网页导航栏都能给模型提供预测捷径,额外表容量的值不值,取决于数据预处理阶段留下了什么。
Engram 不是一张可以拔掉的字典
我原本以为 Engram 就是挂在 MoE 旁边的一个可插拔查表模块,论文里的消融把这个想法否掉了。
原论文的推理时消融数据:事实知识类 benchmark 只保住 29%-44% 的原性能,阅读理解保住 81%-93%。SemiAnalysis 自己的消融是另一个方向:抑制 Engram 让所有评估领域的 token 似然都变差,百科文本和几个代码语料最明显,但 GSM8K 的准确率落在运行间波动范围内,去掉没有影响。
CRUXEval 那组 teacher-forced 实验更干脆。去掉 Engram,答案损失从 0.2848 涨到 0.3093 bits/token。强行让被消融的模型沿用 Engram 打开时的专家选择,结果更差,0.3375。记忆特征和专家路由互相咬合,"记忆存事实、专家做推理"这种干净分工在这类架构里不存在。
还有一个工程上的发现:prefill 阶段保留 Engram 比 decode 阶段保留能带来更多正确答案。他们的解释是 prefill 传给 decode worker 的 KV cache 语义更丰富,能补掉一部分性能损失。
Day 0 的支持速度,还是英伟达说了算
文章里有一节跟卸载无关,但值得记。
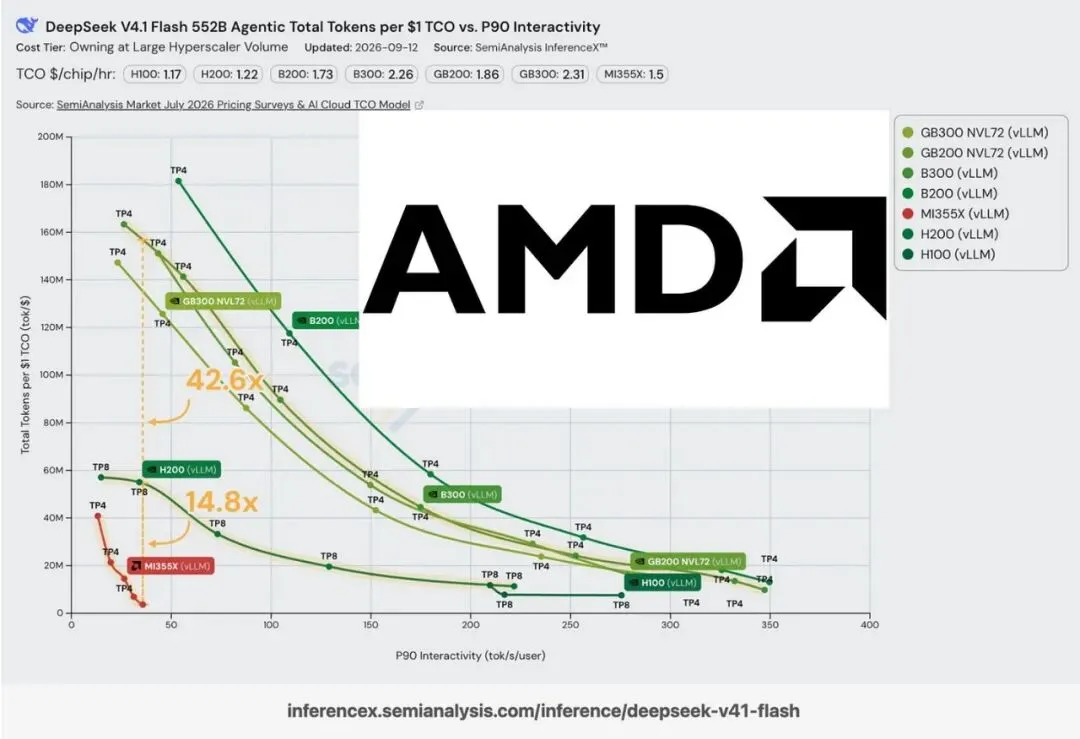
DeepSeek-V4.1-Flash 在 9 月 10 日发布当天,英伟达的 vLLM 在 H100、H200、B200、B300、GB200、GB300 六个 SKU 上开箱可用,零问题。AMD 的 vLLM 当天跑不起来,他们官方文档指向的 vllm/vllm-openai-rocm:deepseekv41-flash-0909 镜像,从发布第 0 小时到第 23 小时都没公开。AMD 自己的口号是 SPEED IS THE MOAT。
等这个 day 0 镜像公开后,每美元性能最多比 H200 差 14.8 倍、比 B200/B300 差 42 倍。到发布后第 7 天,MI355X 的每美元性能仍比 B200 差 2-4 倍,这已经按它更低的 TCO 归一化过。AMD 确实在进步,差距也还在。
我的判断
我关注这条线,是因为它把"模型结构创新"和"硬件采购"这两件平时分开聊的事接上了。Rubin Ultra 缩容不是一次孤立事件,它是 HBM4 供应吃紧的结果;而 Engram 这类结构让同质量的模型需要更少的 HBM 容量,同时更看重 HBM 带宽。
对做推理服务的人来说,这里有个可以直接用的动作:下次评估内存选型,先问模型结构的地址是不是确定的。确定的话,主机 DRAM 这一层还有得挖,不必为容量买最贵的 HBM SKU;不确定的话,省下的钱会以另一种形式还回去。
对看存储和内存厂商的人来说,结论没那么悲观,也没那么顺。SemiAnalysis 在结尾推演了一句"如果中国继续做更激进的模型结构创新,0Hi HBM 堆栈也不是不可能"。这是推演,不是预测。它里面更实的部分是:模型结构开始主动适配内存层级了,硬件不再是自己往上堆容量、软件被动跟随。这对 HBM 厂商是压力,对主机内存和本地存储是新的问号。