ARTICLE · 1041312
OpenAI顶尖科学家坦白:AI现在像极了高级搬砖工,“研究品味”差得离谱!但下两代将超越人类
你能想象吗?
把一位顶级科学家当年耗费数年心血、一举轰动全球的博士毕业课题直接扔给今天最强的大模型,然后对它下达一条指令:
“去做出世界上最好的德州扑克 AI”
结果会发生什么?
结果大失所望:模型只是在原地打了几个转,吐出几段平庸的代码,彻底抓瞎、交了白卷。
说出这个故事的人,正是把这道题亲手喂给 AI 的主考官,OpenAI 核心推理科学家、曾经打造出横扫人类顶尖牌手的超人扑克系统 Libratus 与 Pluribus 的传奇研究员 Noam Brown。
在科技媒体 The Information 近日的长篇深度访谈中,这位参与了 OpenAI o 系列推理模型研发的技术大牛,毫无保留地撕下了当前 AI 狂欢的遮羞布:
“现在的 AI 智能体,在‘研究品味’(Research Taste)上仍然差得离谱。”
但紧接着,他抛出了一句让全场空气瞬间凝固的话:
“如果再过一到两次模型发布,它们在品味上也比我更强,我一点都不会感到惊讶。”
从笨拙抓瞎到彻底超越,中间或许只隔着一到两个版本的时间。人类科学家最后的“灵魂护城河”,正在以不可思议的速度被逼到悬崖边缘。
每天狂烧7000美元,它却是个“没有灵魂”的超级打工人
要理解 Noam Brown 为什么会泼这盆冷水,必须先看看 OpenAI 内部刚刚发生的剧变。
就在几天前,OpenAI 官方发布了一篇名为《研发加速:OpenAI 内部视角》的重磅长文。
官方宣布:他们已经正式达成了 2026 年的核心战略目标,构建出“自动化 AI 研究实习生”!
OpenAI 内部的研发日常,早已变成了普通人难以想象的科幻流水线:
研究员们每天把大批编码智能体(Coding Agents)当成牛马一样并行派发; 内部前 10% 的高频用户,单人每天消耗的推理算力就超过了 7000 美元(约合 5 万元人民币); 换算成标准工时,整个 OpenAI 内部每消耗 1 个人类工作日,就有 3.1 个 AI 智能体工作日在通宵达旦地运转!
AI 写代码越来越快,跑实验越来越猛,处理杂事的能力无可挑剔。
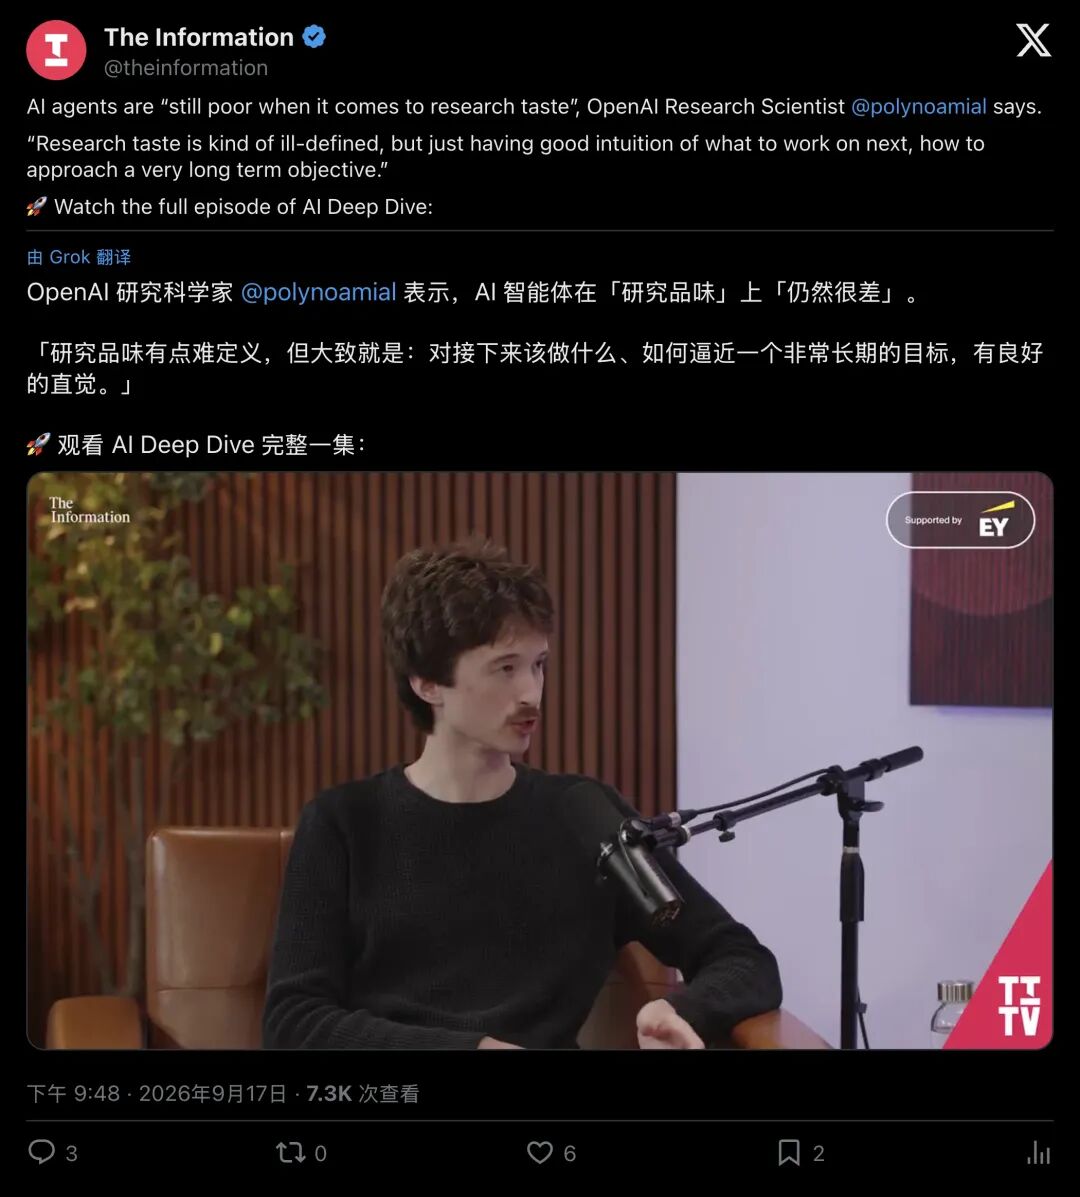
▲ The Information 披露 Noam Brown 谈智能体“研究品味”依然欠缺
然而,当研究机构 Epoch AI 把科研工作拆解为六个阶段(决定选题 Decide、设计实验 Design、编写代码 Build、运行测试 Run、分析结果 Analyze、撰写汇报 Communicate)时,一个无比尴尬的真相浮出了水面:
在最需要消耗算力的“写代码”和“跑实验”上,AI 疯狂输出;但在最决定命运的“决定选题(Decide)”上,AI 的产出占比几乎为零。
它就像一个手速快到飞起、精通所有编程语言的特级打工人。你给它一个明确的任务,它通宵不睡也能给你搞定;但如果你转过头问它:“喂,我们下一步该做什么?哪个方向能通向通用人工智能(AGI)?”
它立刻呆若木鸡
这就是 Noam Brown 所指的致命短板:它毫无“研究品味”。
到底什么是“研究品味”?为什么它比刷题难上一万倍?
在机器学习领域,“研究品味”(Research Taste)代表着一种极度昂贵的生存直觉。
顶尖研究者 Chris Olah 曾在一篇流传极广的笔记中写道:研究品味,本质上就是“在一片大雾中挑出好问题”的能力。
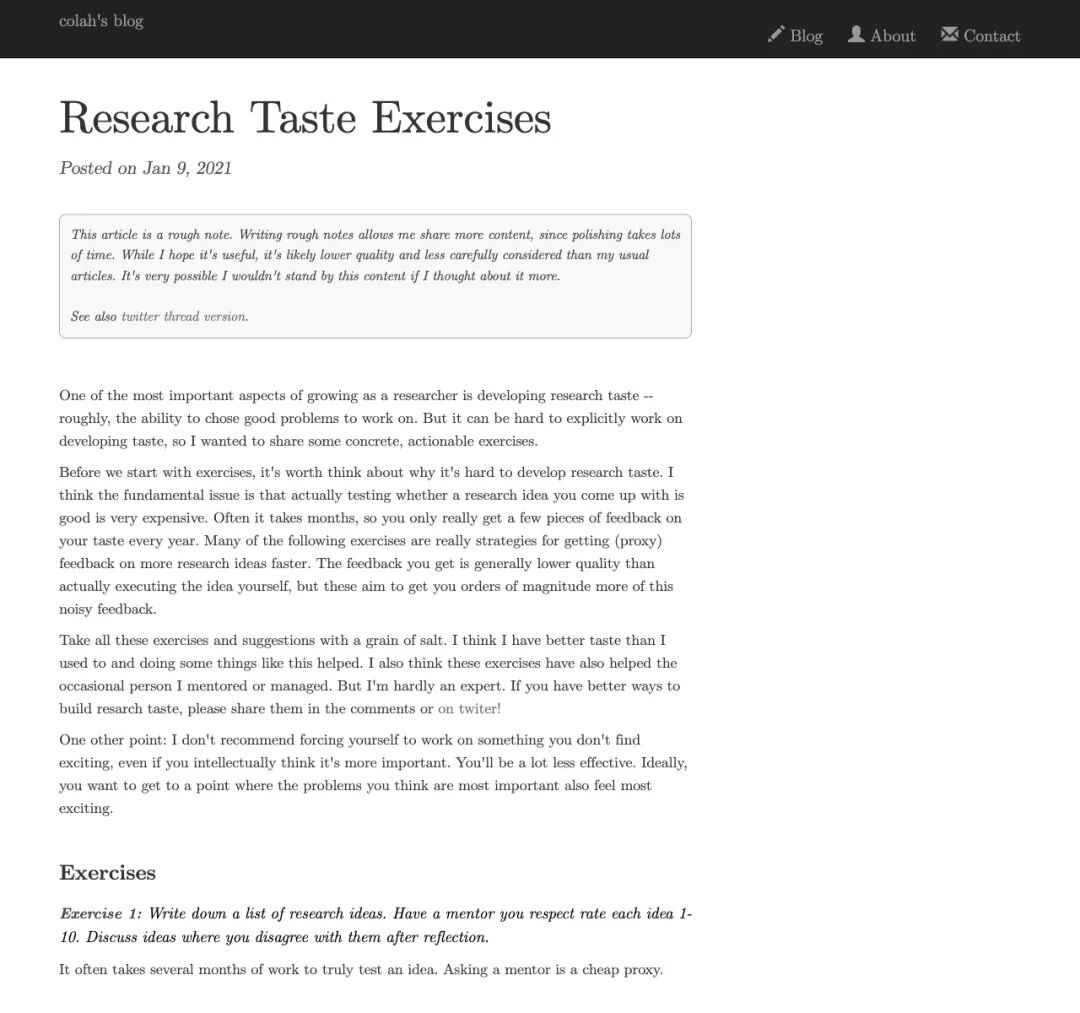
▲ Chris Olah 经典笔记《Research Taste Exercises》探讨如何培养科研品味
做题有标准答案,刷 LeetCode 满分很容易,给一段代码挑 Bug 也不难。因为这些任务的反馈周期是以秒计算的,对就是对,错就是错。
但前沿科学探索面对的是一片荒原:
眼前有一万条路,每一条看起来都充满希望,每一条深入下去都要烧掉几百万元的显卡算力与人类数月的时间; 哪一条是死胡同?哪一条能通往诺贝尔奖? 实验数据里突然出现了一个怪异的尖峰,这到底是一个划时代的全新物理现象,还是服务器温度过高导致的数值溢出? 当一个方向连跑三周都没有进展,你到底应该咬碎牙齿继续死磕,还是果断止损掉头就跑?
这种在极度缺乏反馈、满眼都是迷雾的开放世界里,凭着敏锐直觉做出正确决断的能力,就是品味。
Noam Brown 是德州扑克 AI 的开山鼻祖。在不完美信息的扑克博弈里,你永远不知道对手底牌是什么,搜索树无穷无尽,每一步都必须在概率与直觉的钢丝上跳舞。
可如今的 AI,擅长的是穷举和执行你给它一张详细的藏宝图,它挖得比谁都快;但如果你把它扔在一整座未开发的荒山面前,它连第一锹该插在哪里都不知道。
“在我日常的研究工作里,大约还有 10% 是 AI 很难替代的,”听众整理的笔记里写道,“而这剩下的 10%,绝大部分就是研究品味。”
硅谷巨头打响“品味保卫战”:把直觉降维成数学题
AI 真的永远学不会品味吗?
硅谷的顶尖实验室显然不信邪为了教会 AI“挑实验”,巨头们正在把这种看似神秘的直觉暴力拆解为工程模型。
前不久,Meta FAIR 实验室联合牛津大学、伦敦大学学院(UCL)砸出了一篇重量级论文,直接提出了一个新概念:AI 科研偏好模型(Research Preference Models, 简称 RPM)。
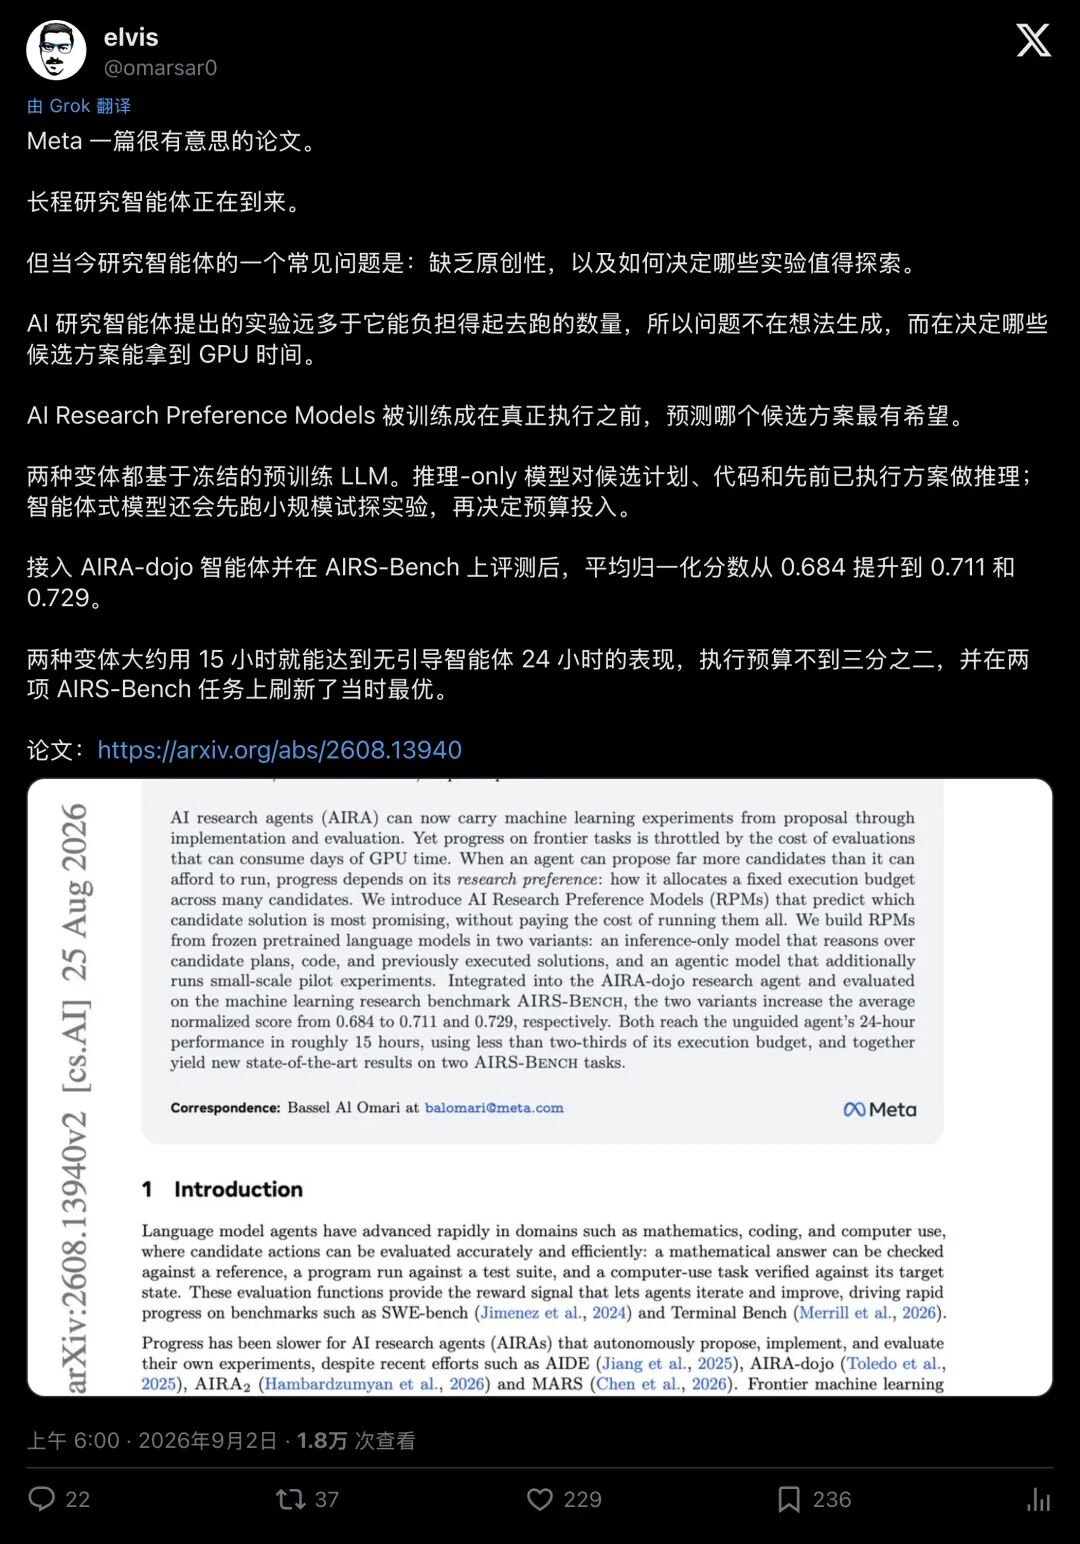
▲ Meta FAIR 等机构提出科研偏好模型,尝试让 AI 自主决定算力分配
Meta 的科学家们发现,今天的 AI 智能体面临的最大痛点,恰恰在于“点子提得太多,显卡根本不够用”。
AI 能在五分钟内提出 100 个看似合理的实验方案,但实验室的总预算只够跑其中的 3 个。以往,必须由资深人类教授坐下来,扫一眼方案,凭经验挑出最靠谱的那几个。
Meta 做的事情,就是训练一个专职的“AI 评审导师”:
一种版本只靠看代码、读计划和历史记录,预先给这 100 个方案打分; 另一种版本更聪明,先用极少的算力跑几个微型“探路实验”,再决定把大笔资金投给谁。
结果令人惊艳:在标准的科研智能体基准评测上,引入偏好模型后的 AI,仅用不到三分之二的算力预算,就跑赢了原本需要 24 小时的无引导智能体!
但这能代表具备了“品味”吗?
学术社区发起的另一项评测 TastyBench 给出了相当冰冷的回应。他们让最前沿的大模型去预测历史上的科学论文在未来会不会大火、引用量会不会暴增。
结果显示:AI 的预测准确率,基本等同于抛硬币瞎蒙。
排序几个候选代码方案,工程师可以用算法搞定;但要在人类认知的前沿判定“什么才是重要的问题”,AI 依然像个盲人。
终极悬念:一两代模型之后,递归自我改进降临?
然而,最让人汗毛倒竖的,正是 Noam Brown 那句轻描淡写却重逾千斤的预言。
“一两次模型发布之后,它们的品味可能比我还好。”
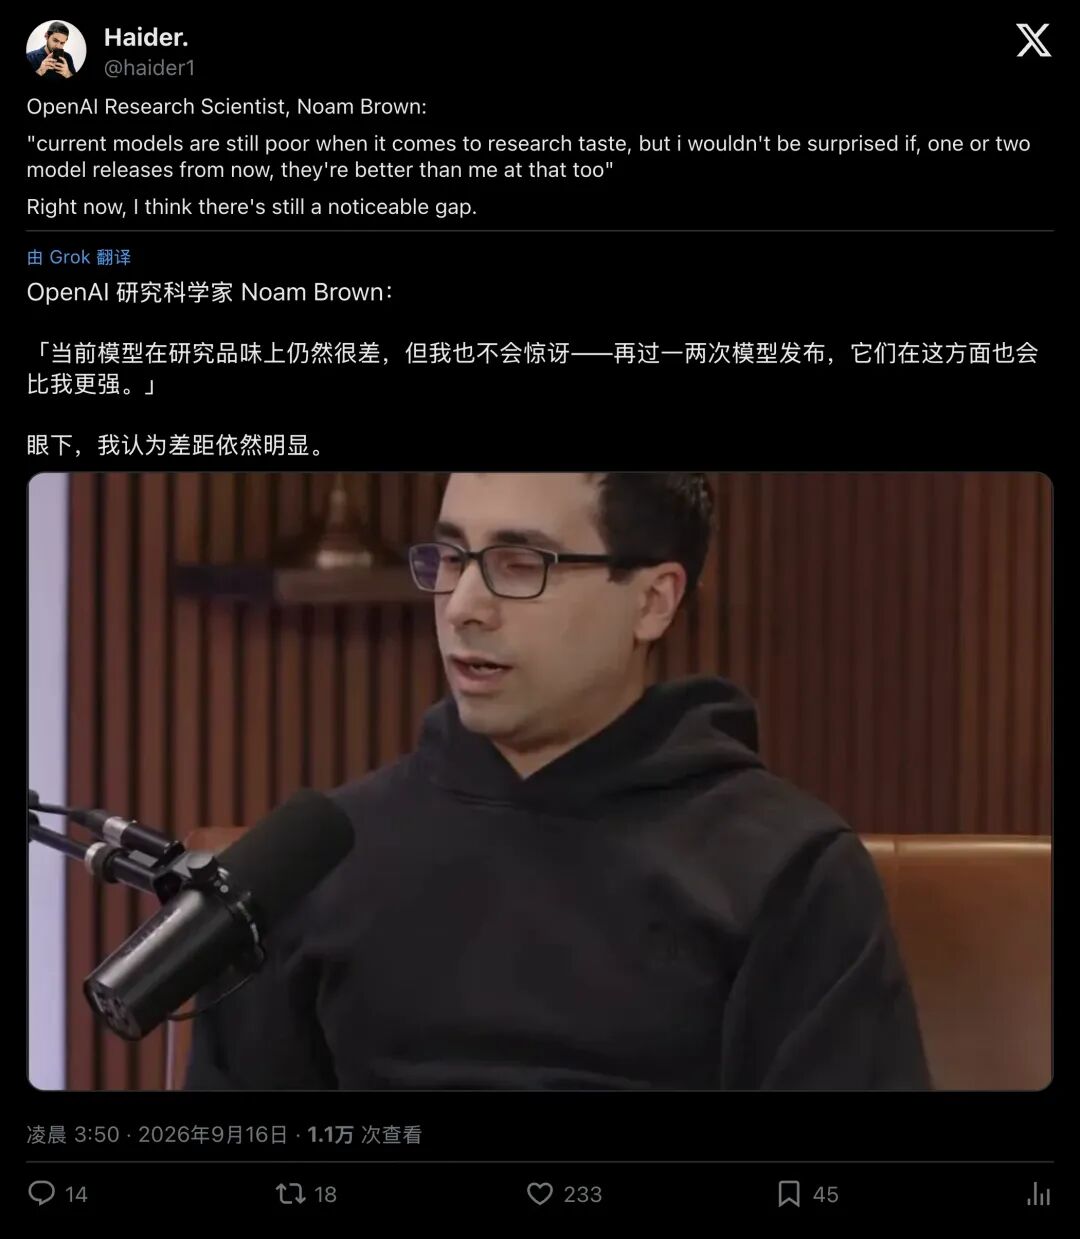
▲ 社区广泛传播的访谈切片:Noam Brown 预言 AI 研究品味将在短期内赶超人类
在科技圈,所有人都知道这句话的弦外之音是什么,
RSI(Recursive Self-Improvement,递归自我改进)。
当 AI 还只是个“无脑搬砖工”时,人类是整个闭环的舵手。人类定方向,AI 拧螺丝无论 AI 跑得多快,它都在人类的视线控制之内。
但如果有一天,AI 拥有了超越顶尖科学家的“研究品味”:
它知道当前算法的致命缺陷在哪里; 它能自己制定长达半年的研究路线; 它能自主挑选最值得烧算力的架构; - 它开始自己写代码,去训练下一个比自己更聪明的 AI。
▲ 安全研究社区对 Brown 发言的引申讨论:品味超越人类即意味着 RSI 临近
一旦科学发现的罗盘从人类手中交接给算法,智能进化的飞轮将彻底甩开人类的生理极限。
在访谈中,Brown 还提到了一个让他深感震撼的 “Feel-the-AGI”(感受到通用智能降临)时刻:
在最新的多智能体系统里,AI 们已经不再像过去的流水线那样死板地“上级下发任务、下级汇报结果”。它们开始像研究所里的真实同事一样,围坐在一起交谈、辩论、互通有无、自主分工。
而在社交网络上,围观这场访谈的从业者们留下了这样一条评论:
“当一个 AI 智能体能够坦诚地承认‘我也不知道下一步该做什么’的时候,我反而觉得它更值得信任了。”
尾声:最后的 10%
从 2025 年的规划,到 2026 年 9 月官宣达成“自动化 AI 研究实习生”,再到瞄准 2028 年的“全自动 AI 研究员”,OpenAI 的时间表正在一张一张兑现。
在过去的几百年里,“科学探索的品味”曾被视作人类智慧冠冕上最璀璨、最不可复制的一颗明珠。它是爱因斯坦的思想实验,是达尔文在群岛上的凝视,是无数先驱在漫长黑夜中不可言说的顿悟。
现在,顶尖的造神者告诉我们:这颗明珠,或许只剩下最后“一两个版本”的保鲜期。
当这最后的 10% 护城河被算力的大潮彻底抹平,科学这艘载着全人类前行的大船,它的舵手,将不再是我们。