ARTICLE · 1049800
论文一条龙AI助手!通过多智能体协作架构,将完整的研究流程自动化,开源 | gitcc.com
2026 年,AI 正在从"Copilot"变成"同事"
先看一组行业动向。2026 年的 AI 科研领域正在经历质变:DeepSeek 资深研究员与 AI Agent 合写了一篇 45 页论文,其中 99% 内容由 CodeAgent 完成;学术界把 AI 在科研中的辅助切成四个阶段——创造(选题、文献综述、实验)、写作(论文撰写)、验证(审稿返修)、传播(海报、PPT、视频),全链路都在被 AI 覆盖。
更前沿的是多智能体协作——2026 年 AAAI 上的 LiRA 采用多智能体工作流,专门的智能体分别负责内容大纲、章节写作、编辑和审稿,最终产出连贯的综述文章;GitHub 上也出现了 6.4k Stars 的论文自动化流水线,32 个不同分工的 AI Agent 协同,把选题到投稿拆成 10 个阶段。
今天聊的这个开源项目 Rafflesiaarnoldii(OpenLens AI),就是这条赛道上的一员——你给它一个数据集和一行研究问题,它自动帮你把文献综述、数据分析、实验设计、代码执行、LaTeX 论文全流程跑完。
源代码:https://www.gitcc.com/Lizhooh/ai-lunwen-zhushou
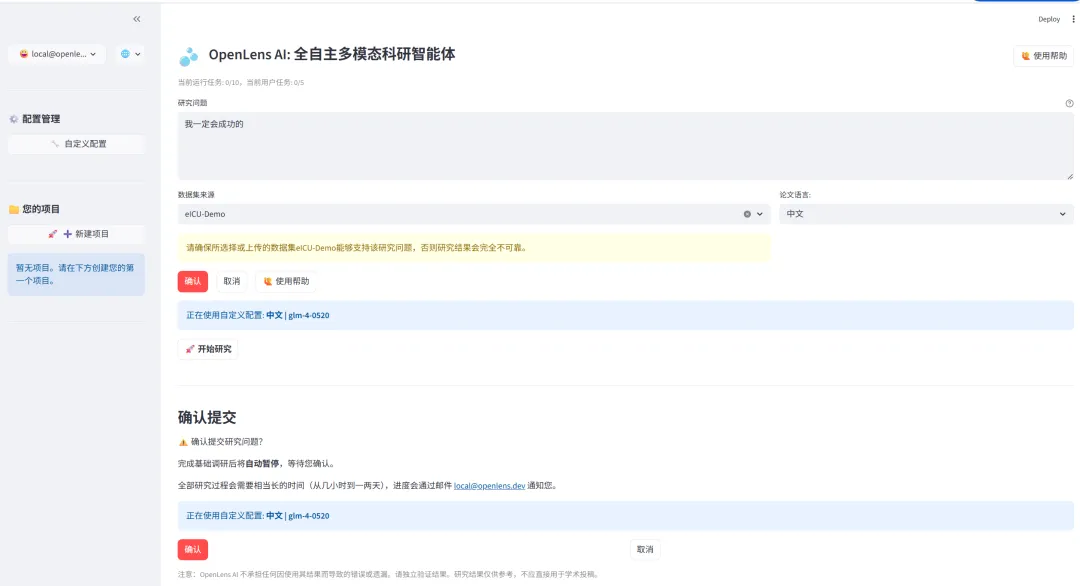
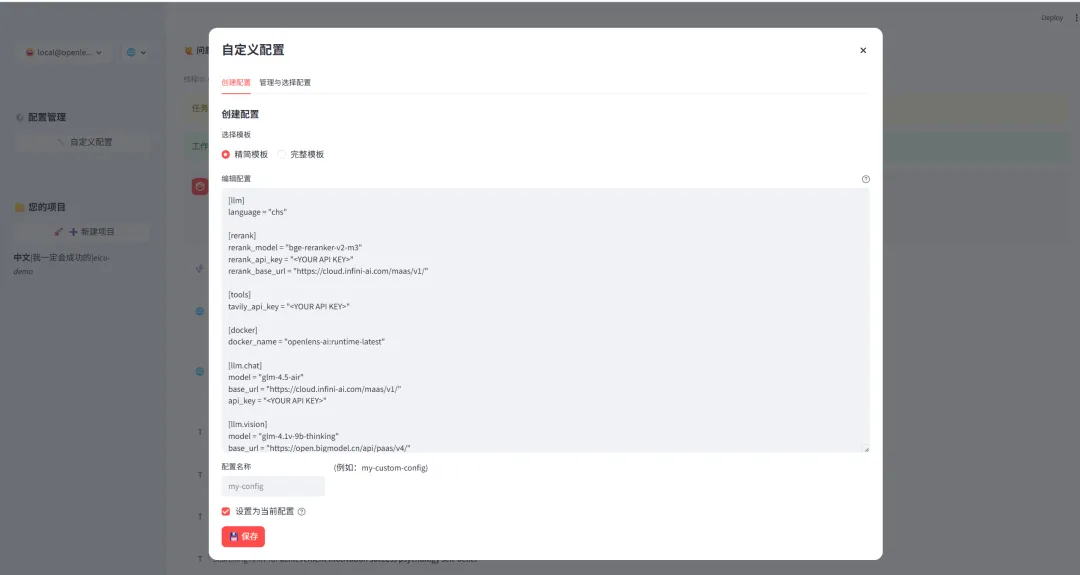
📋 这个项目是什么:多智能体科研自动化系统
这是一个完全自主的多模态智能体系统,研究人员只需提供:
• 数据集(CSV、JSON 等格式)📊 • 一行研究问题或假设 💡
系统自动完成:
• ✅ 自动文献综述:根据研究问题搜索和总结论文 • ✅ 数据分析:分析数据集并生成综合报告 • ✅ 实验设计:提出和验证实验方法 • ✅ 代码生成与执行:用 OpenHands 在隔离环境跑代码 • ✅ LaTeX 论文生成:自动写论文、排章节、管参考文献 • ✅ 交互式 Web 界面:基于 Streamlit 监控研究过程 • ✅ 视觉-语言反馈:VLM 生成图表和流程图 • ✅ 中文写作支持
💡 个人观点:它不是那种"输入题目一键出论文"的噱头工具,而是一个多智能体协作的科研流水线——文献综述员、数据分析师、编码员、LaTeX 作家、视觉 Agent 各干各的,像一个虚拟科研团队。
🔍 解决的痛点:做科研为什么这么累
痛点一:文献综述耗时长 📚手动翻阅相关论文、总结关键观点,读几十篇文献要几周。系统自动搜索 arXiv、medRxiv、Google Scholar、Tavily 等多个源,提取关键信息生成综述。
痛点二:数据分析门槛高 📊数据预处理、特征工程、统计分析需要专业技能。系统自动做数据探索、统计分析、特征工程、可视化,生成综合分析报告。
痛点三:实验设计难 🔬设计严谨的实验方案需要深厚领域知识。系统提出实验方案、设计数据集划分、建议验证方法,帮你把研究框架搭起来。
痛点四:写论文效率低 ✍️撰写规范研究论文工作量大,反复修改频繁。系统自动生成 LaTeX 论文、组织章节、排版公式、管理参考文献。
🛠️ 核心功能:十大智能体分工
技术栈一览:
| Python 3.11+ / Node.js | |
| LangGraph ≥0.2.6 + LangChain | |
| LiteLLM 统一接口 | |
| GLM-4V 等 Vision Models | |
| Streamlit + Streamlit-Autorefresh | |
| Docker + OpenHands | |
| LaTeX / html2image / CairoSVG | |
| BeautifulSoup4 / pypdf / pdf2image / NumPy | |
| Tavily Search API + BGE-Reranker + 向量搜索 |
⚠️ 使用感受和避坑指南
✅ 上手体验:
• Streamlit 开箱即用:不用自己写前端, streamlit run就能起 Web 界面,监控整个研究过程• 多智能体分工清晰:文献归 Literature Reviewer、代码归 Coder、论文归 LaTeX Writer,不是一个大模型硬扛所有活 • 代码在 Docker 沙箱跑:OpenHands 生成的代码在隔离容器执行,不会把你本地环境搞乱 • 中文写作友好:全面支持中文论文写作,对国内学生比纯英文工具友好
❌ 避坑点:
1. 要自己准备 API Key:LiteLLM 接 OpenAI 兼容接口,模型、Tavily 搜索、VLM 视觉模型都要自己配 Key,不是装好就能用 2. 跑起来要显卡/算力:数据分析、VLM 反馈、向量检索都吃模型调用,API 费用不低,跑一次完整流程要算成本 3. 数据集要自己清洗:它能分析 CSV/JSON,但脏数据、缺失值、异常值前期还是要你自己预处理好 4. LaTeX 排版要检查:自动生成的 LaTeX 可能有公式编号、参考文献格式问题,投稿前必须自己对着期刊模板改 5. 学术诚信红线:⚠️ AI 生成的内容必须由作者本人审核、改写、负责——直接拿 AI 生成的论文投稿属于学术不端,这是底线
🗣️ 吐槽和改进建议
可以吐槽的地方:
• 项目还在早期:基于 PowerPoint 的图表、长上下文模型支持都标了"规划中",不是全功能完成态 • 部署门槛不低:LangGraph + Docker + OpenHands + Streamlit + 向量库,一套装下来对非工程背景的研究者不友好 • 结果要人工把关:AI 写的文献综述可能有"幻觉引用",数据分析结论可能过拟合,不能直接当终稿用
💡 改进方向(个人观点):
• 文献综述可以加引用真实性校验——自动检查 AI 引用的论文是否真的存在、是否被正确引用,这是当前 AI 写论文最大的坑 • 实验设计可以预置常见学科模板(医学统计、机器学习、社会科学),用户选个模板就能跑,不用从零描述 • Streamlit 界面可以做得更像"科研工作台"——左边文献库、中间实验流程、右边论文大纲,现在偏工具集合
🎯 典型应用场景和适用人群
适用场景:
1. 医学与生物信息研究 🏥:临床数据分析、医学文献综述、医学影像分析、电子病历挖掘 2. 机器学习研究 🤖:算法基准测试、超参数优化、论文复现、模型对比实验 3. 统计与计量经济 📈:时间序列预测、因果推断、回归分析、社会科学数据分析 4. 通用数据驱动项目 💼:市场调研、运营分析、质量管理、业务智能项目
适合人群:
• 研究生/博士生 🎓:文献综述和数据分析占大量时间,用它提速,但结论必须自己把关 • 医学/统计研究者 🔬:有临床数据但缺编程能力,让 AI 帮跑分析流程 • 数据科学团队 📊:快速探索数据集、生成初步分析报告,作为科研起点而非终点 • AI 应用开发者 💻:学习 LangGraph 多智能体编排的参考项目,看完能搭自己的 Agent 系统
结语
2026 年的科研正在经历一场"Agent 化"革命——AI 不再只是帮你补全句子的 Copilot,而是能自己查文献、跑数据、写 LaTeX 的 Colleague。OpenLens AI 这套多智能体系统的价值,是把"文献综述→数据分析→实验设计→代码执行→论文撰写"这条研究链路串成了自动化流水线。但必须强调:AI 是助手不是作者,它能帮你提速 10 倍,研究假设的合理性、结论的正确性、论文的学术诚信,责任永远在研究者本人。用它提效可以,直接投稿不行。
源代码:
https://www.gitcc.com/Lizhooh/ai-lunwen-zhushou
完全开源!
关注我们
了解更多新资讯
