ARTICLE · 1052329
图片、音频、视频与PDF如何进入多模态大模型
导语
把一份扫描PDF拖进对话框,模型很快给出摘要,看起来像它直接“读懂了文件”。实际链路可能包含解码、抽帧、语音识别、OCR、视觉编码和文本生成。不同模态最终都要变成模型可计算的表示,因此GPU压力不只取决于文件大小。
01
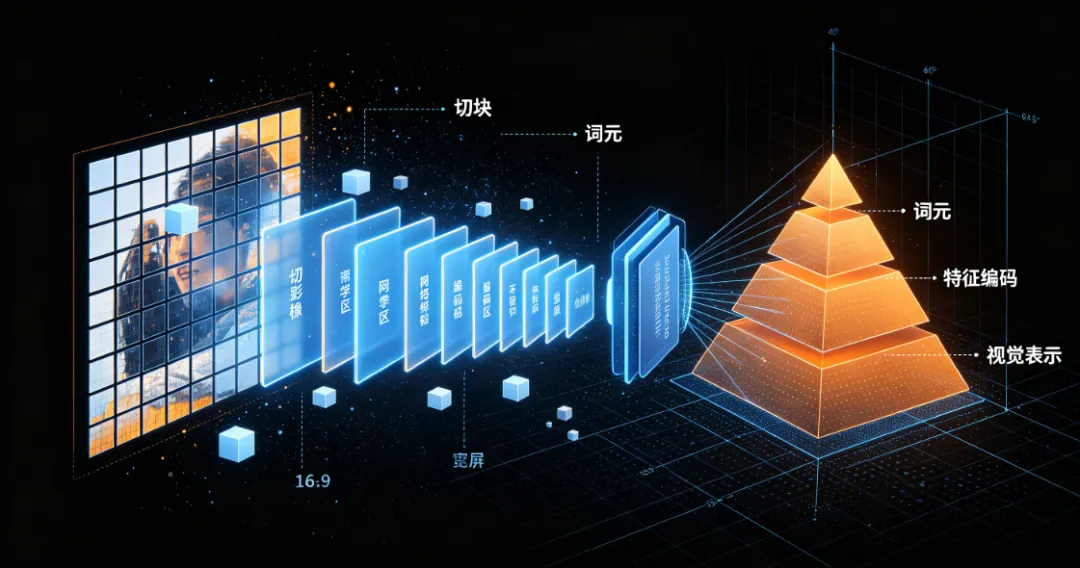
图片会被切块并编码成视觉表示
多模态模型依靠视觉编码器处理图片,将图片缩放、切分,转化为视觉Token,再和文本信息一起输入模型。图片分辨率、数量、长宽比都会影响计算量,不能只看文件大小判断资源消耗。
图片预处理可运行在CPU或GPU上。高分辨率识别、多图比对场景,会拉高响应延迟和显存占用。实际业务中要提前校验上传图片,压缩异常大图,防止拖垮整体服务。
02
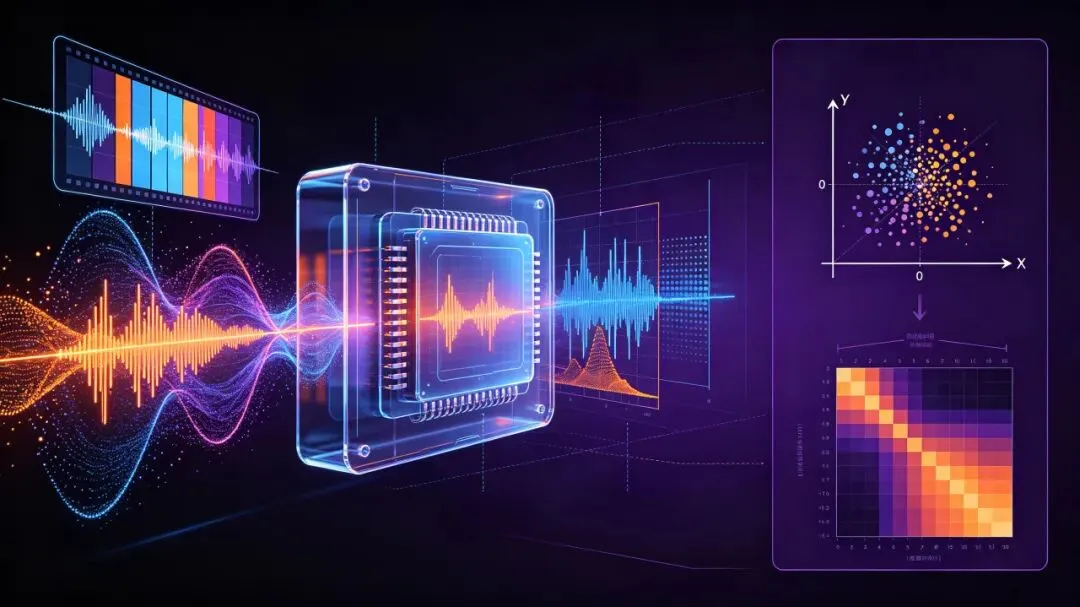
音频要在时间轴上提取特征
音频会把声音波形转为频谱特征,交由音频编码器处理。分为两种方式:一种先语音转文字,再交给大模型;另一种端到端模式直接处理音频Token。音频时长、采样率、噪声等会影响算力和识别准确率。
长会议录音除转写外,还需要区分说话人、标记时间,适合分段处理再合并结果;实时语音则追求低延迟。部署时除GPU,还要为解码、存储、网络预留CPU资源。
03
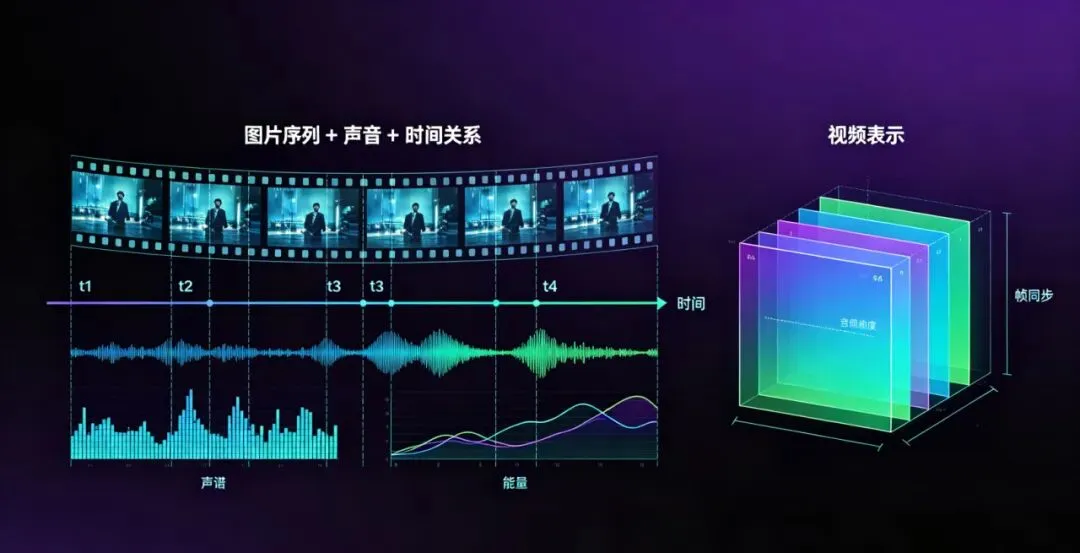
视频是图片序列加声音和时间关系
视频是大量图片帧叠加音频的组合,如果处理全部帧,算力开销会急剧上涨。实际系统一般间隔抽取关键帧,结合音频转写理解内容。抽帧太少容易漏掉关键画面,抽帧过多会消耗大量算力。
不同业务要求不一样:问答检索适合通用大模型;质检类高精度任务,需要专业视觉模型。要先明确业务的精度要求,再搭配采样策略与模型。
04
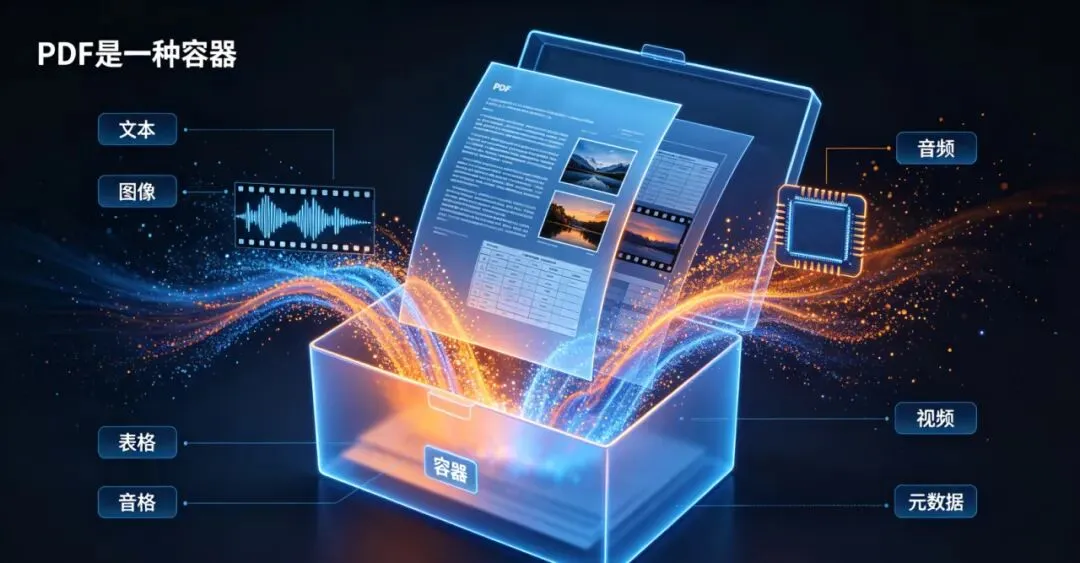
PDF是一种容器,不是一种单一模态
PDF里面可能包含文字、扫描图片、表格、公式。纯文字PDF可以直接提取文本;扫描版PDF需要OCR识别;表格、双栏文档还要还原阅读顺序。把PDF整页转成图片虽能保留排版,但会增加算力,小字号内容还容易识别出错。
处理PDF要先区分文件类型,组合文本解析、OCR、版面分析工具,保留页码方便溯源。即便模型输出通顺摘要,表格数字也可能出错,重要文档需要人工校验。
05
多模态服务为何更考验GPU与系统
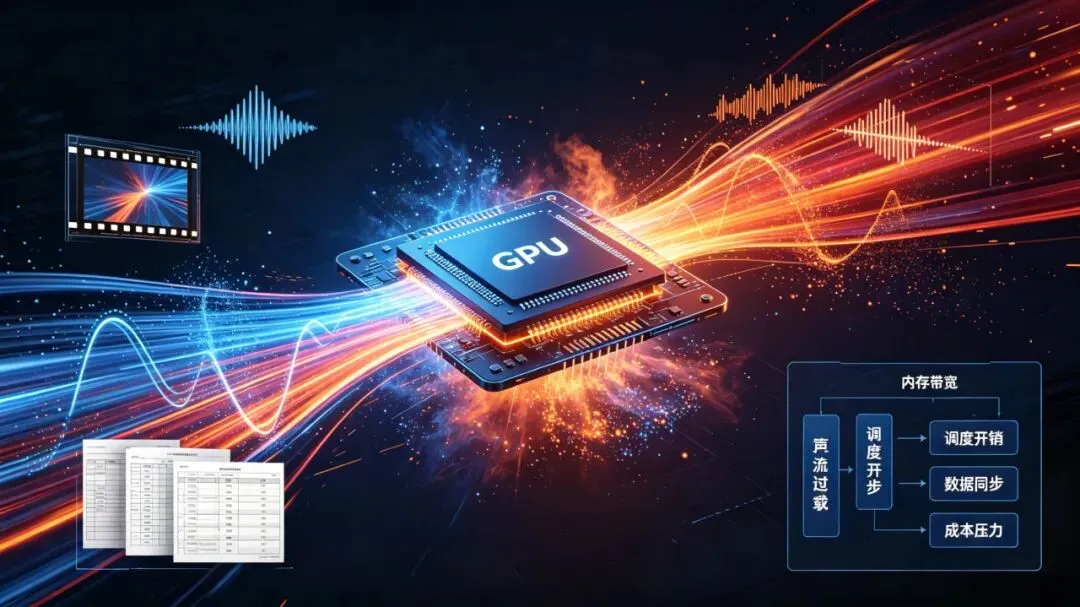
多模态服务除大模型本身,还要加载视觉、音频、OCR等辅助模型,占用更多显存。图像、音频Token会增大上下文缓存。编码器串行会拉长响应时间,并行处理则瞬时硬件占用飙升。
可以把预处理和内容生成拆分成独立队列,离线任务放在业务低峰期执行,同时做好文件校验,避免GPU资源浪费在无效文件上。
06
如何做多模态选型与验收
测试不能只用清晰理想样本,要覆盖真实复杂场景,评测识别准确率、响应速度、显存占用等多项指标。根据业务上限做压力测试,可通过压缩分辨率、分段处理降低成本,同时做好数据权限与安全管控。
遇到故障不要直接归咎于GPU性能不足,可以从质量、容量、延迟、稳定性、治理五个维度排查。上线前要留存离线测试,小流量灰度发布,预留回滚方案。采购方案要提供容量、体验、质量三类实测证据。同时设置输入限制,异常长任务转入离线处理,保护整体服务稳定。
选型不是一次性对比硬件参数,而是跟随业务数据持续迭代的工程流程。总而言之,各类媒体文件都需要经过预处理转为模型可识别的信息,做好预处理、输入管控和真实场景压测,才能合理配置硬件资源。
信息来源
1.PyTorch:图像与视频I/O:
https://docs.pytorch.org/vision/stable/io.html
2.Hugging Face:多模态聊天模板:
https://huggingface.co/docs/transformers/main/en/chat_templating_multimodal
3.vLLM:多模态输入:
https://docs.vllm.ai/en/latest/features/multimodal_inputs.html
4.SGLang:多模态语言模型:
https://docs.sglang.ai/backend/server_arguments.html
点击蓝字
关注我们
SUBSCRIBE
叁才云科
云计算专业服务提供商
云计算数据中心、边缘云计算加速、边缘云计算平台、智算中心等服务,旨在为客户呈献快速、安全、稳定的网络服务及充足计算存储资源。