ARTICLE · 1054548
AI创业的门槛,正在被国家一块一块拆掉
三年前,你跟一个普通创业者说“去做AI”,他大概率会回你一句:拿什么做?
算力按亿烧,数据按条买,场景靠命碰,融资靠脸熟。
这四件事凑齐了,才勉强拿到一张入场券。
凑不齐,连门都摸不着。
于是所有人形成一种共识:AI是巨头的牌桌,普通人最多在旁边递个水。
这个共识,正在被一份文件撕开一道口子。
2026年9月4日,工信部印发《人工智能中小企业创业支持计划(2026-2028年)》。多数人看到这条新闻的反应是“又一个政策”,然后划走。
但如果只看到“政策”两个字,你会错过一个关键信号:国家正在以工程化的方式,拆除AI创业的四道核心门槛。
不是喊口号,是拆门槛。这两者之间的差距,比大多数人想象的要大得多。
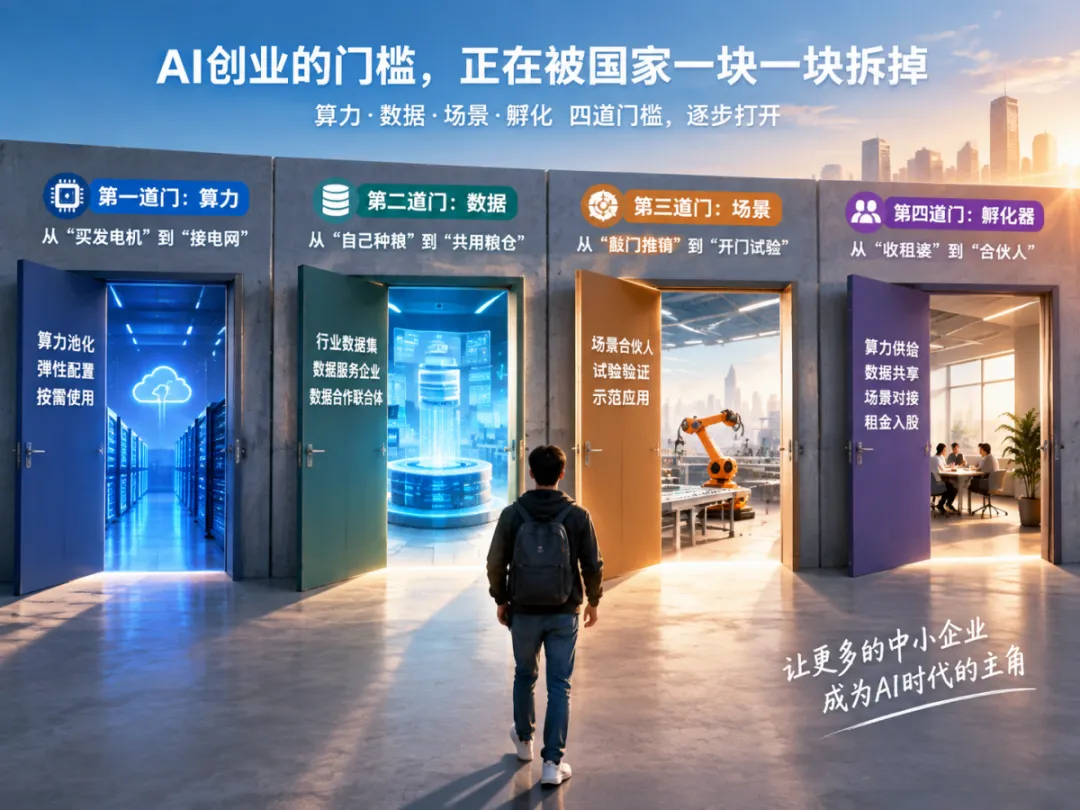
第一道门:算力,从“买发电机”到“接电网”
先讲一个反常识的事实。
过去十年,AI创业失败的第一原因,不是产品不行,不是市场不认,而是算力账单先到期了。
训练一个大模型,成本按亿计。这个数字大部分人没有概念。
换算一下:一个中型创业团队,全员一年工资加起来,可能还不够训练一次中等规模模型的电费。就算你不训模型,只是调用现成接口跑业务,根据新华网2026年6月的报道,中小企业的单日使用成本,也能轻松突破数百元。一个月下来,一两万。
还没赚钱,先亏两万。
赛迪智库和网商银行2026年6月的一份观察数据,把这条路的残酷写得明明白白:听说过AI工具的小微经营者,占97%。真正上手试过的,53%。能坚持日常使用的,只剩30%上下。
每往前走一步,就有一大批人被甩下去。甩下去的原因,排第一的不是能力不够,是账单太厚。
这份计划对算力的处理方式,核心就八个字:池化整合,弹性配置。翻译成商业语言——算力正在从“资产”变成“公用事业”。
打个比方。
你想开一家需要用电的厂子。过去的做法是,先花几十万买一台发电机。现在的做法是,电网拉到你门口,你接一根线,用多少付多少。发电机的时代,只有买得起发电机的人能开厂。电网的时代,只要你有手艺,就能开厂。
算力普惠的本质,是把AI创业的固定成本,变成可变成本。固定成本拼的是家底,可变成本拼的是本事。
这一字之差,决定了谁能上桌。
第二道门:数据,从“自己种粮”到“共用粮仓”
数据是AI的粮食。这个比喻已经被说烂了。但大多数人没往下想一步:粮食从地里长出来,到变成碗里的饭,中间要经过多少道工序?
要买地,要播种,要收割,要脱壳,要清洗,要蒸煮。
每一步都是成本。
数据也一样。拿到的原始数据是脏的、散的、没标签的。要清洗,要标注,要结构化。文本标注的市场价,一条0.1到0.5元。一个熟练标注师,一天撑死标1000条。
你要为一个垂直行业攒够上百万条能用的数据,得养一个中型团队干一两年。工资照发,数据还不一定能用。
中国信通院2026年3月的报告给了一个定性判断:中小企业用AI,整体仍处于规模化应用的初级阶段。什么叫初级阶段?就是大部分人连粮食都还没种出来。
这份计划的解法是:建行业数据集,培育数据服务企业,组建数据合作联合体。翻译过来——你不需要自己种粮了。大企业、平台、行业协会把粮食凑到一个公共粮仓里,你拿着碗去盛就行。至于洗菜切菜这些活,有专门的中央厨房帮你干。
这个变化的意义,被绝大多数解读忽略了。数据开放的本质,不是“给你省了多少钱”,而是“把数据从竞争壁垒变成了公共基础设施”。
过去的逻辑是:我有数据,你没有,所以我赢。以后的逻辑是:数据大家都有,谁能把数据用出花来,谁赢。
竞争的重心,从资源占有,转移到了应用能力。这对没有数据家底但有行业理解的小团队来说,是结构性的利好。
第三道门:场景,从“敲门推销”到“开门试验”
产品和订单之间,隔着一道最难跨的鸿沟。
你做了一个AI质检工具,精度比人工高,成本比人工低。然后呢?你去敲工厂的门。门卫拦你,采购推你,技术负责人怀疑你。就算有人愿意试,试错成本谁承担?出了事故谁负责?绝大多数创业团队,死在这道鸿沟里。
这份计划提出“场景合伙人”机制,引导链主企业开放试验验证、示范应用、规模化商用场景。链主企业,就是产业链上的龙头。场景合伙人,就是帮你对接需求的介绍人。
这个机制的核心,不是“给你一个客户”,而是“给你一个被验证的机会”。
有使用才有反馈,有反馈才有优化,有优化才有信任。信任这个东西,在B端市场里,比技术本身值钱。
更关键的是,链主企业开放场景,意味着它把自己的信用借给了你。
你进不去的那扇门,有人带你进去。你承担不起的试错成本,有人帮你分摊。
这道门拆掉之后,产品到订单之间的距离,从“九死一生”变成了“有人领路”。
第四道门:孵化器,从“收租婆”到“合伙人”
这一条,可能是整份计划里最容易被低估的变化。
过去的孵化器,本质上是二房东。给你一个工位,贴一张牌子,然后收租。所谓的孵化,是你自己孵化自己。你交着房租,独自面对所有风险。
这份计划明确提出,引导孵化载体将智能算力供给、行业数据共享、应用场景对接纳入核心服务,探索服务费、租金入股等灵活机制。
“租金入股”四个字,值得反复读。它的意思是:孵化器不收你现金,收你股份。你活下来,它才有回报。你死了,它跟着亏。
这是一个物种级别的变化。收租的孵化器,和入股的孵化器,风险偏好完全不同。收租的孵化器希望你按时交钱,入股的孵化器希望你活得更久。前者的利益和你的生存无关,后者的利益和你的成长绑定。
当一个孵化器开始用股份换租金,它就不再是房东,而是合伙人。你需要的从来不是一张桌子,是一个和你共担风险的人。
算力池化、数据共享、场景开放、孵化入股,这四件事有一个共同特征:把创业的固定成本,转移到公共基础设施上。把创业的固定风险,分散到生态伙伴身上。
这背后的逻辑,比“扶持中小企业”深得多。它指向一个根本性的判断:AI产业的下一步,不是靠少数巨头把模型越做越大,而是靠大量中小企业在垂直场景里把应用做深做透。
大模型是地基,行业应用是房子。地基再牢,没人盖房子,地就是一块空地。而盖房子这件事,巨头干不了。因为每个行业的房子,图纸都不一样。制造业的质检逻辑,和医疗业的诊断逻辑,和农业的病虫害识别逻辑,天差地别。
这些差异,只有深耕行业的人才能理解。
所以,拆门槛的目的,不是让每个人都去训大模型。是让懂行业的人,不用先成为算力专家、数据专家、融资专家,就能把自己对行业的理解,变成AI产品。
一个必须面对的真相:
政策拆的是外部门槛。有一道门槛,它拆不掉。
这份计划里有一句话:培育一批“小快轻准”的人工智能产品解决方案。小快轻准——小型、快速、轻量、精准。这四个字,既是机会,也是筛子。
机会在于,你不需要做一个大而全的平台。你只需要在一个足够窄的切口上,做到足够好。一个零部件AI质检团队,不需要懂整条产线,只需要把质检这一个环节做到极致。
筛子在于,“足够好”这三个字,比它看起来要重得多。集群共享、组织化对接,意味着你面对的不是一个客户,是一群客户。一个客户说你好,不算好。一群客户都说你好,才算好。
在一个集群里,你只需要做好你最擅长的那一部分。但前提是,那一部分,你得真的做得足够好、足够准。
外部门槛拆掉之后,内部门槛就暴露出来了。过去你可以说“我没钱没资源所以做不了”,以后这句话越来越站不住脚。
当算力可以借,数据可以共享,场景有人对接,孵化器和你共担风险,剩下的问题只有一个:你的手艺,到底行不行?
这才是这份计划真正提出的问题。