ARTICLE · 1054549
AI连续9代“近亲繁殖”后彻底痴呆!Nature重磅:哥特教堂全变成了彩色野兔
如果你把一段关于14世纪英国哥特式教堂建筑史的严谨学术资料,喂给一个刚训练好的AI,问它教堂塔楼是怎么建成的。
它的回答非常专业,逻辑缜密,甚至还能和你讨论中世纪石匠的假说。
但如果,你把这个AI写出的回答收集起来,拿去训练第二代AI;再把第二代AI的产物,喂给第三代……如此循环往复,只让AI吃自己的产出长大。
猜猜到了第9代,会发生什么?
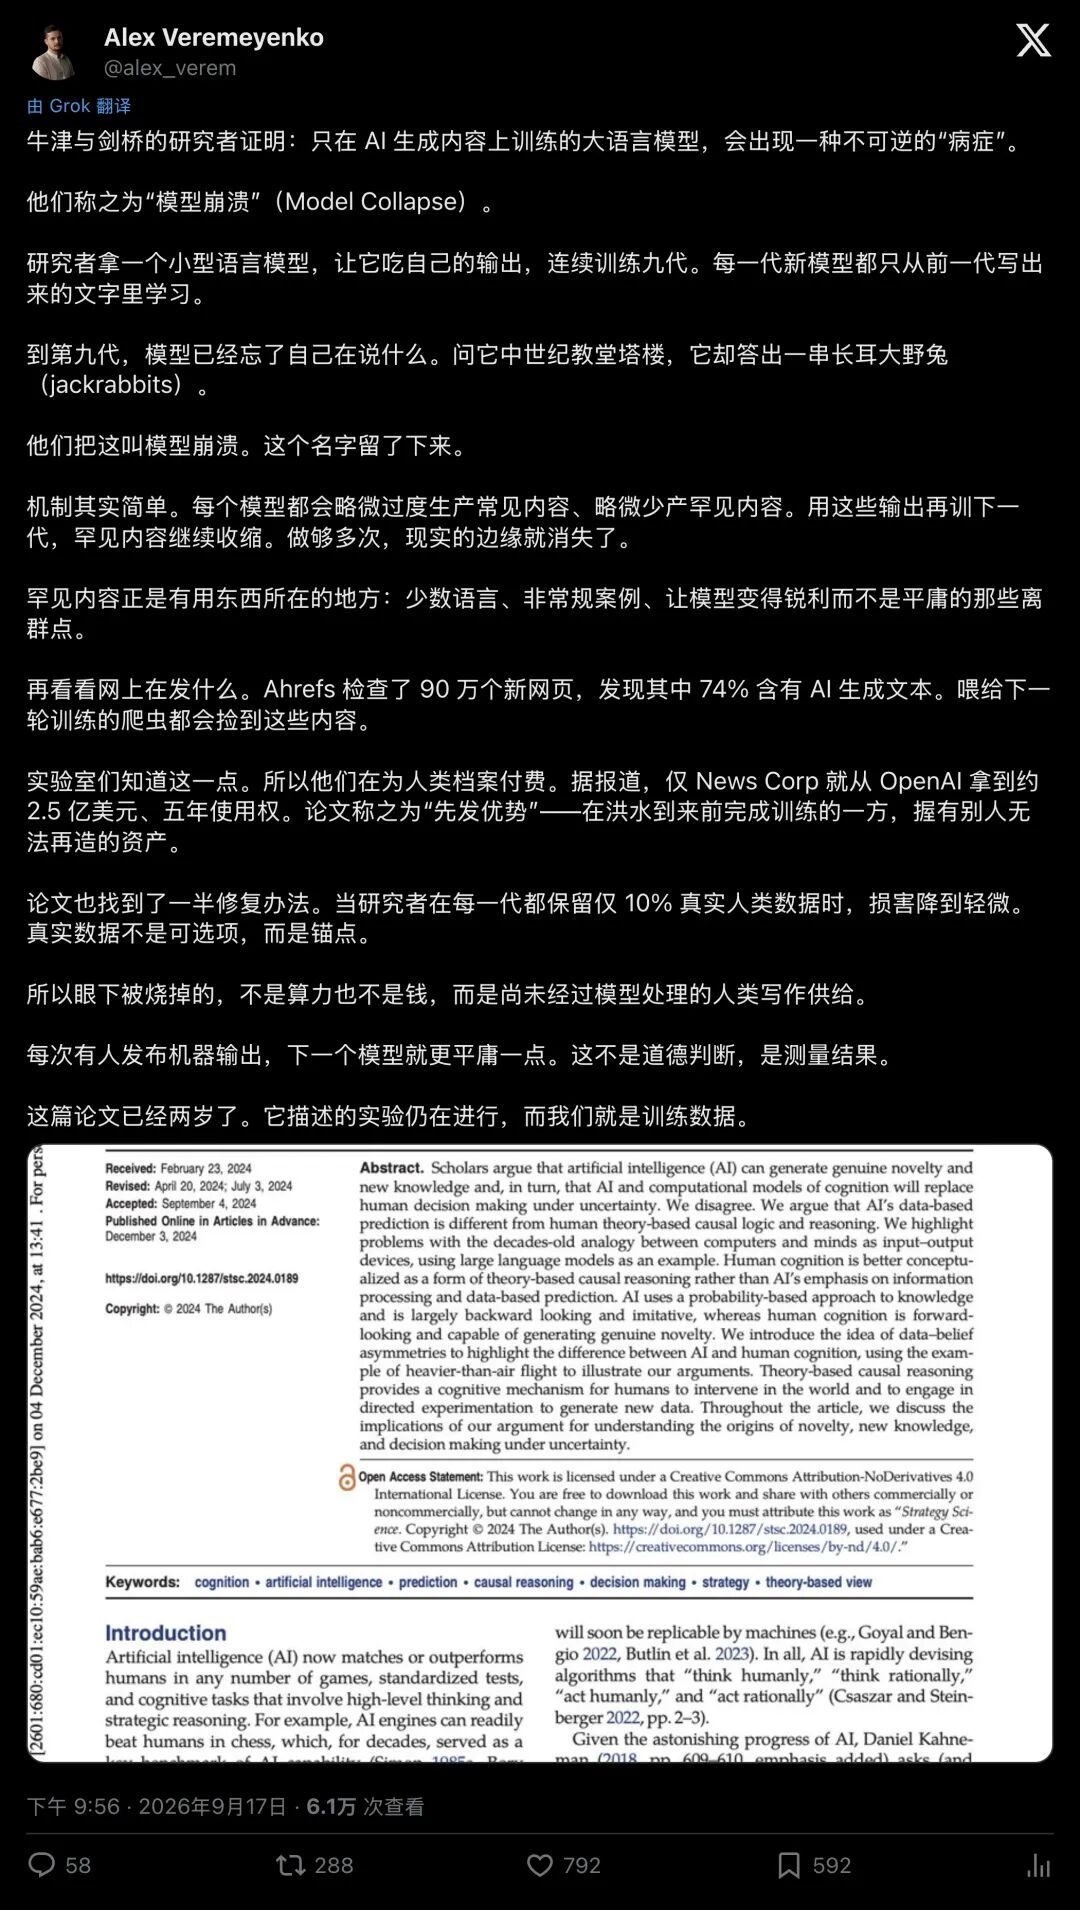
▲ 社交网络上针对“模型崩溃”的深度科普长帖,揭示了AI代际自噬的连锁反应
到了第9代,你再问它关于中世纪哥特式教堂塔楼的营造历史。
这位“AI后代”已经彻底疯了它不仅把建筑史忘得一干二净,还神志不清地当场给你背诵了一长串名单:
“……这里还是世界上某些最大规模的黑尾大野兔、白尾大野兔、蓝尾大野兔、红尾大野兔、黄尾大野兔种群的家园……”
面对这一串荒诞的野兔清单,很多人第一反应难免觉得荒唐。
这份记录来自牛津大学、剑桥大学、帝国理工和多伦多大学等顶尖学府的研究团队,发表在国际顶级科学期刊《Nature》正刊上,是实打实的严肃实验结果!
这项震撼硅谷的研究,给这种AI代际自噬导致的致命缺陷起了一个冷酷的名字:模型崩溃(Model Collapse)。
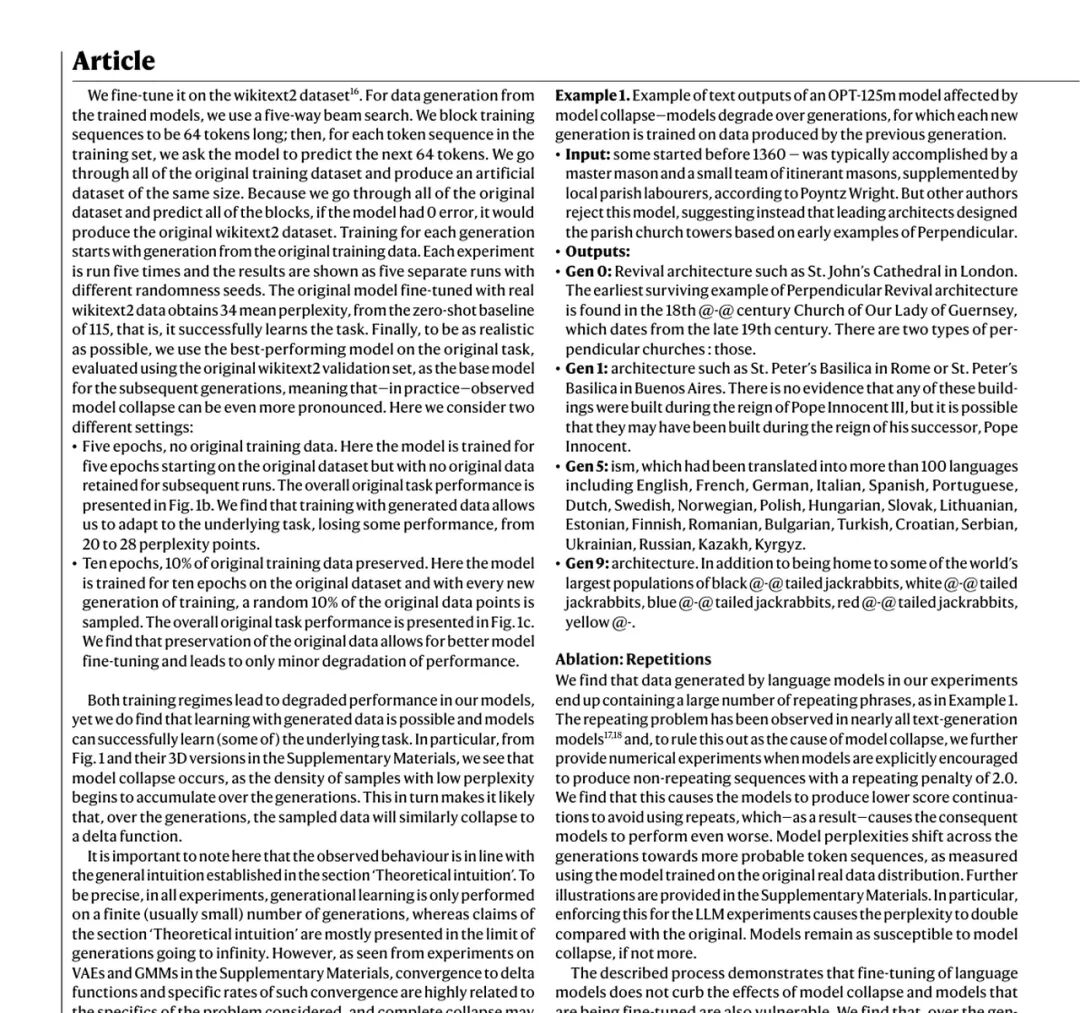
▲ Nature论文第4页裁切证据:在仅学习自身输出9代后,关于中世纪教堂的提问彻底退化成了彩色“jackrabbits(长耳大野兔)”的胡言乱语
第一幕:AI的“自噬诅咒”,为什么9代就会痴呆?
大语言模型(LLM)的本质,是一个超级庞大的概率预测器。
在人类浩瀚的书籍、网页、代码和对话中浸泡出来的AI,学会了人类语言中极其微妙的统计规律。但它有一个致命天性:极度偏爱常见事物,悄悄忽视罕见事物。
打个比方,如果人类语言库里,提到“狗”的概率是90%,提到“罕见病”的概率是0.01%,AI在生成文字时,就会稍微多说一点“狗”,少提一点“罕见病”。
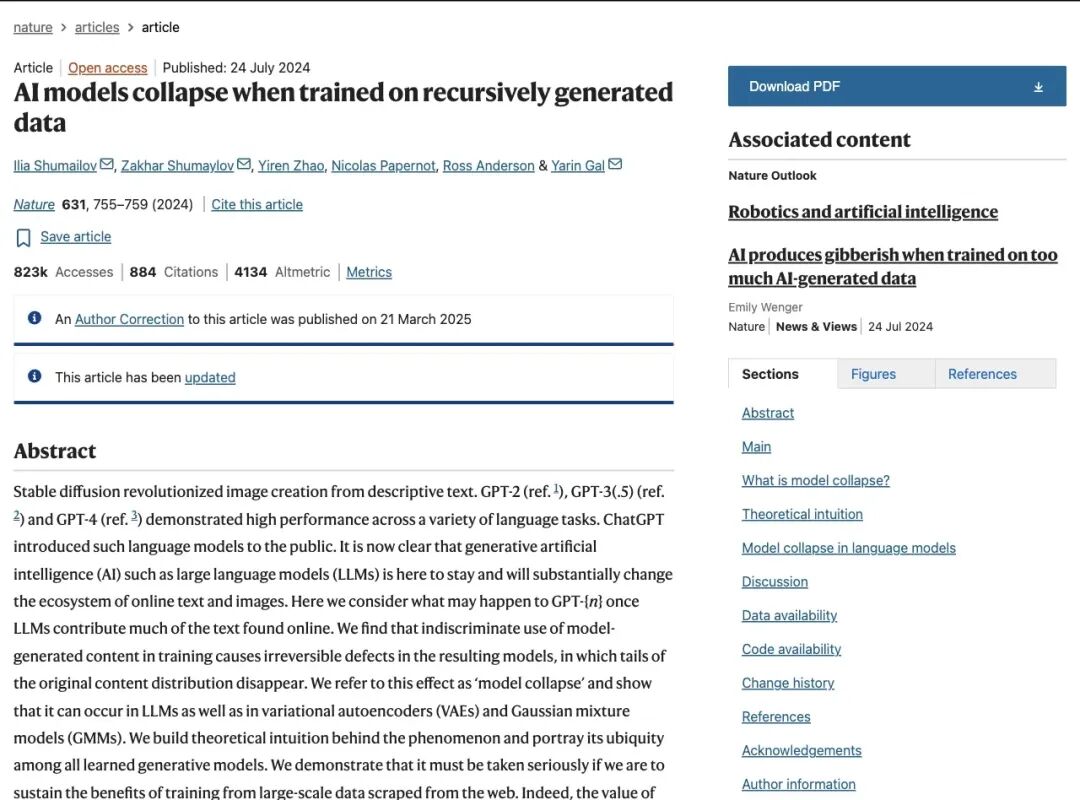
▲ Nature期刊正式发表的论文《AI models collapse when trained on recursively generated data》
如果下一代AI,只吃上一代AI吐出来的数据:
- 第一代
:稍微丢掉了一点点冷门知识和边缘表达。 - 第二代
:基于残缺的样本继续训练,罕见表达的生存空间被进一步腰斩。 - 第三代到第五代
:语言风格开始严重同质化,词汇量急剧萎缩,陷入“复读机”式的自言自语。 - 第九代
:数学上的误差像雪崩一样层层累加,原有的现实世界概率分布彻底粉碎,AI开始一本正经地胡说八道。
研究人员把这个退化过程分为两步:
- 早期崩溃(Early Collapse)
:分布的“尾巴”先被斩断。那些天才的灵光一闪、冷僻的专业知识、少数群体的语言,在这个阶段最先被系统性蒸发。 - 晚期崩溃(Late Collapse)
:模型彻底塌缩为一个方差极小的“单点”,现实世界的丰富多义性荡然无存。
用牛津大学第一作者 Ilia Shumailov 的话说:“AI就像坠入了一个无底深渊,在吞食自己排泄物的过程中,变得越来越无知,越来越重复。”
第二幕:复印机复印自己的复印件,现实的边缘被啃光了
很多非技术背景的朋友可能会好奇:现在的AI算力这么强,模型这么大,为什么就克服不了一个小小的自我循环?
牛津与剑桥的科学家在数学上把原因归结为三座无法逾越的大山:
- 统计近似误差
:数据样本永远是有限的。只要做重采样,小概率事件就必然会在某一轮中彻底丢失,并且一旦丢了就再也找不回来。 - 函数表达误差
:神经网络哪怕参数规模庞大,也终究存在表达上限。它会在原本有信息的地方分配零概率,在荒谬的地方给出非零概率。 - 优化算法偏差
:每一次训练求解,算法都在追求“全局损失最小”,这本身就是在用最平庸的均值,去抹杀最有个性的棱角。
这就像你拿一台顶级彩色复印机,去复印一张色彩斑斓的油画;再拿这张复印件去印下一张
每一次复印,对比度都会失真一点点,边缘都会模糊一丝丝。
哪怕单次肉眼难辨,只要复印几十次,最后出来的必然是一张脏兮兮的黑白废纸。
如果把视线转向图像生成领域,这种自我循环的退化过程展现出的视觉冲击更加触目惊心。
相关研究发现,如果让AI画图模型只学习AI自己生成的图片,只需要几轮迭代,原本精致逼真的人脸,就会逐步扭曲、融化、变形,最后变成如同克苏鲁怪物一般不可名状的肉团。
第三幕:现实互联网正在被“投毒”,纯血人类语料告急!
如果这仅仅停留在实验室里的理论推演,硅谷各大机构尚可从容观望。
严峻的现实在于:这场灾难性的自我循环,已经在我们眼皮底下的真实互联网中全面蔓延。
全球著名SEO与数据分析机构 Ahrefs 在分析了90万个新上线网页后,给出了一个触目惊心的数字:
高达 74.2% 的新网页,已经充斥着由AI生成或改写的内容!
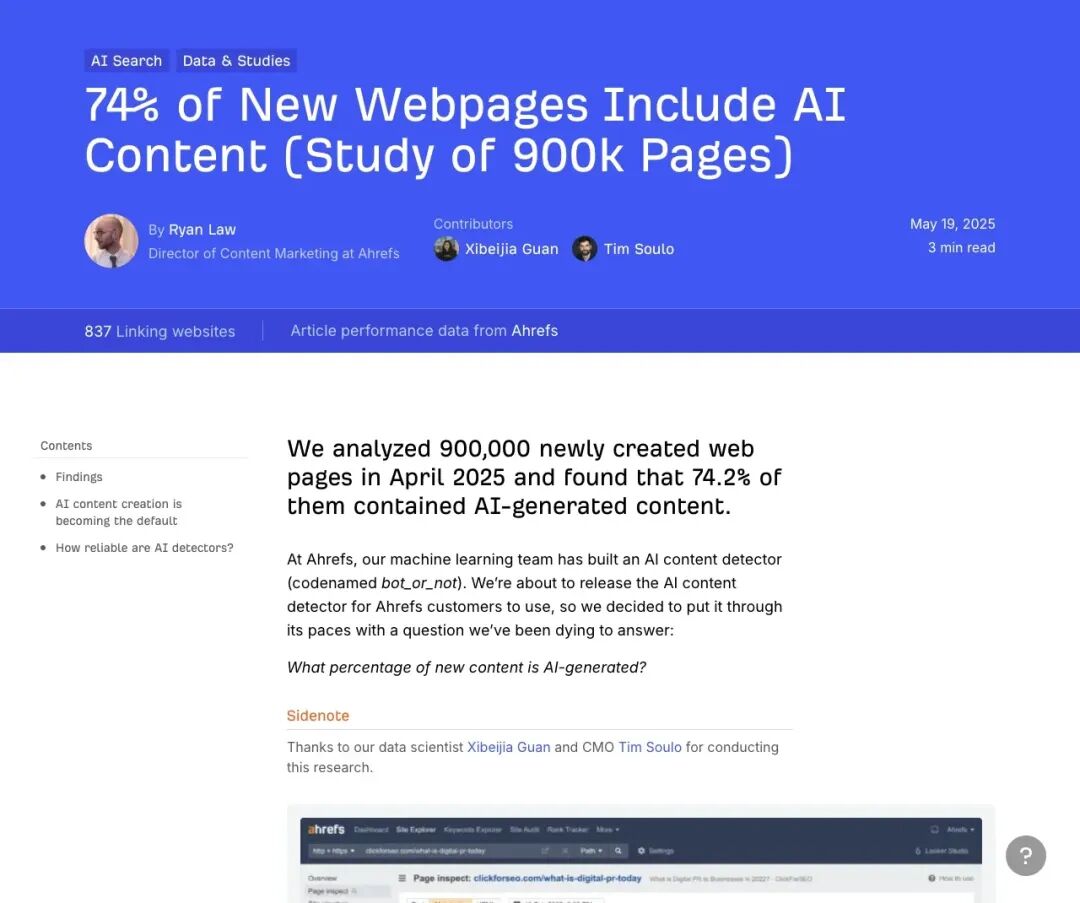
▲ Ahrefs的研究报告明确指出:74%的新网页中已经包含了AI生成的内容
纯正由人类手打的网页,只剩下了可怜的四分之一。
每天,数以亿计由大模型批量制造的“SEO垃圾文章”、“流水线营销号废话”、“无病呻吟的公文套话”,正以海啸般的速度倾倒进互联网的每一个角落。
而各大AI巨头的网络爬虫,还在日夜不停地抓取这些网页,把它们打包成下一代千亿基座大模型的训练语料。
下一代AI,正在毫无知觉地大口吃下上一代AI排泄出来的赛博垃圾!
这就是为什么硅谷现在出现了一个看似荒诞、实则残酷的抢购狂潮:
- OpenAI 豪掷据报道逾 2.5 亿美元
,只为了买下默多克旗下新闻集团(News Corp)未来五年的纯人类新闻档案。 - Reddit、金融时报、美联社、各大百年出版社
,突然成了科技巨头排队送钱的香饽饽。
Nature论文一针见血地指出,在这个时代,“先发优势(First Mover Advantage)”被彻底重写了。
谁在2022年AI内容大爆发之前,完成了对整个互联网人类知识库的抓取与清洗,谁手里就攥着无法被复制的“纯血人类遗产”。
在被AI稀释的世界里,未被模型咀嚼过的人类真实文字,成了赛博时代的“洁净水源”和“新鲜空气”。
第四幕:大反转!10%的人类数据,就是拯救AI的定海神针
AI真的注定要在这场数字化近亲繁殖中走向灭亡吗?
在论文的最深处,科学家们留出了极其关键的希望之窗。
在消融实验中,研究人员做了一个对比:在每一代训练中,只要掺入仅仅 10% 的真实人类历史数据作为锚点,大模型的困惑度和退化速度就会发生戏剧性的逆转,崩溃被几乎完全遏制,性能损伤微乎其微!
来自斯坦福大学等机构的学者们(Gerstgrasser 等)随后在预印本中进一步提出了重要修正:
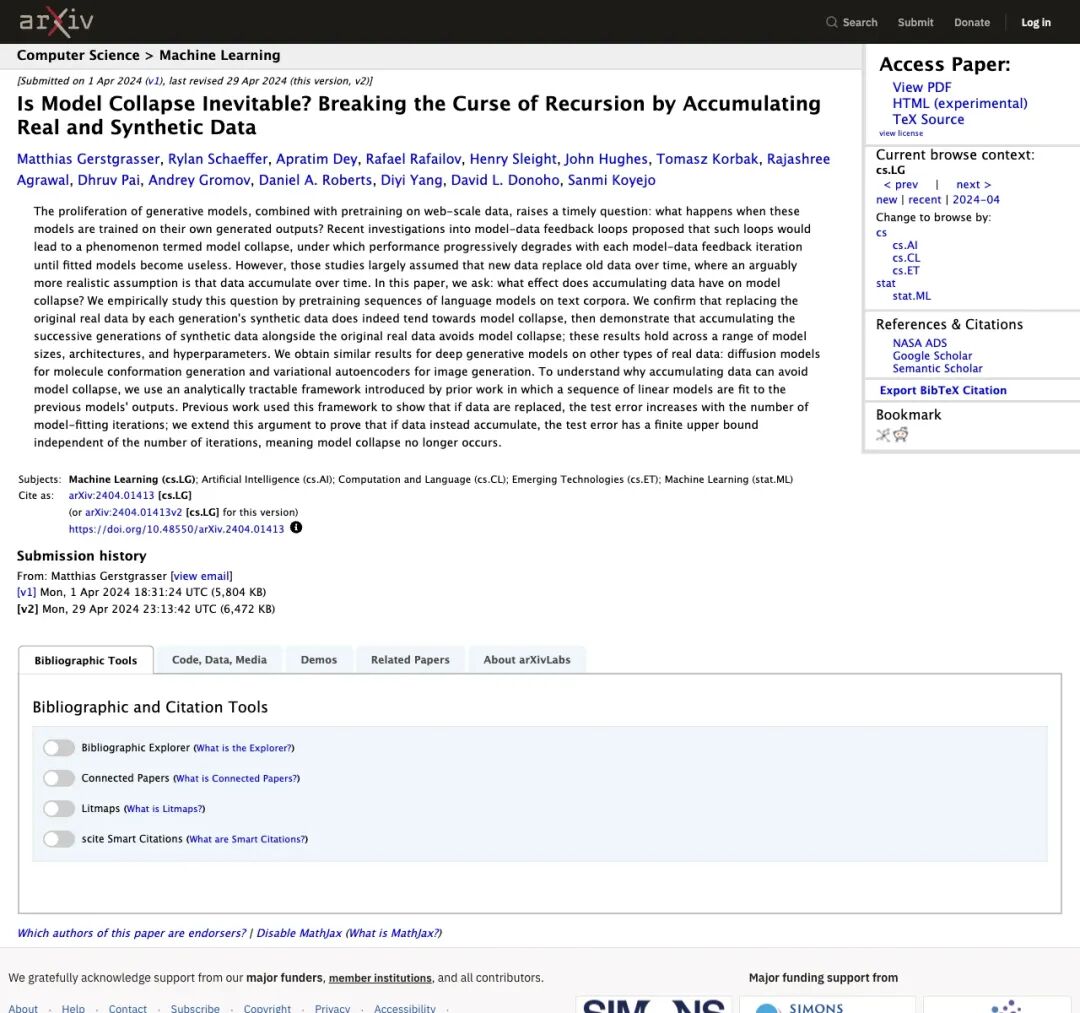
▲ 斯坦福等团队发表的《Is Model Collapse Inevitable?》,探讨了累积数据对打破循环的作用
他们指出,Nature论文展示的是最极端的“替换式(Replacement)”绝境,即每一代都把老数据扔光,只吃最新的纯AI产物。
但在真实的工业工程中,如果我们采用“累积式(Accumulation)”策略,永远不丢弃人类祖传的古老语料,把人类真实数据像地基一样永远夯在底层,配合严格的数据溯源(Provenance)和高质量合成过滤,数学上的测试误差就会被牢牢限制在一个安全上界之内。
真实的人类数据承担着核心基石的作用,是维系整个AI大厦稳固的重力锚!
尾声:人类写作的终极价值,正在被重新定义
这项发表在《Nature》上的研究,最终给全人类带来了一场极具讽刺意味的启示。
在过去两年里,无数人都在焦虑:既然AI几秒钟就能写出一篇辞藻华丽的报告、一篇结构完整的散文,人类伏案写作、字斟句酌的意义究竟何在?
Nature给出了最硬核的数学答案:
AI擅长的是“平均”,而人类擅长的是“偏离”。
那些人类在痛苦、困惑、狂喜中写下的真实感受;那些带着方言俚语的非标准表达;那些在深夜敲下的冷门思考与偏激洞见……在过去的工业化视角里,它们是效率低下的“噪点”。
但在算法的代际自噬面前,正是这些跳脱出平均数之外的“噪点”,保住了真实世界的丰富度与生命力,构成了对抗熵增的唯一解药。
互联网不需要更多四平八稳、挑不出毛病却空洞乏味的“AI生成的垃圾”。
每一个真人写下的每一句带体温的文字,都在不知不觉中,拯救着下一次技术革命的智商底线。