ARTICLE · 1054556
AI吃自己吐的数据9代后彻底疯癫!Nature重磅:大模型“近亲繁殖”正在毁掉互联网
如果你现在去问一个AI,让它描写一座14世纪的英国中世纪教堂塔楼,它会告诉你什么?
在正常情况下,它会引经据典,从哥特式飞扶壁聊到1360年的石匠工艺。
但如果这个AI,是由上一代AI写出来的文章训练出来的;而上一代,又是吃上上一代产出的数据长大的……连续这样“代际繁殖”到第9代,诡异的事情发生了。
面对同一个关于教堂建筑的提问,第9代AI突然陷入了一种无法理解的谵妄。它完全忘记了教堂、石头和建筑师,而是在屏幕上疯狂输出一串令人毛骨悚然的胡话:
“……这里还是世界上最大规模的黑尾、白尾、蓝尾、红尾、黄尾长耳大野兔(jackrabbits)种群的家园……”
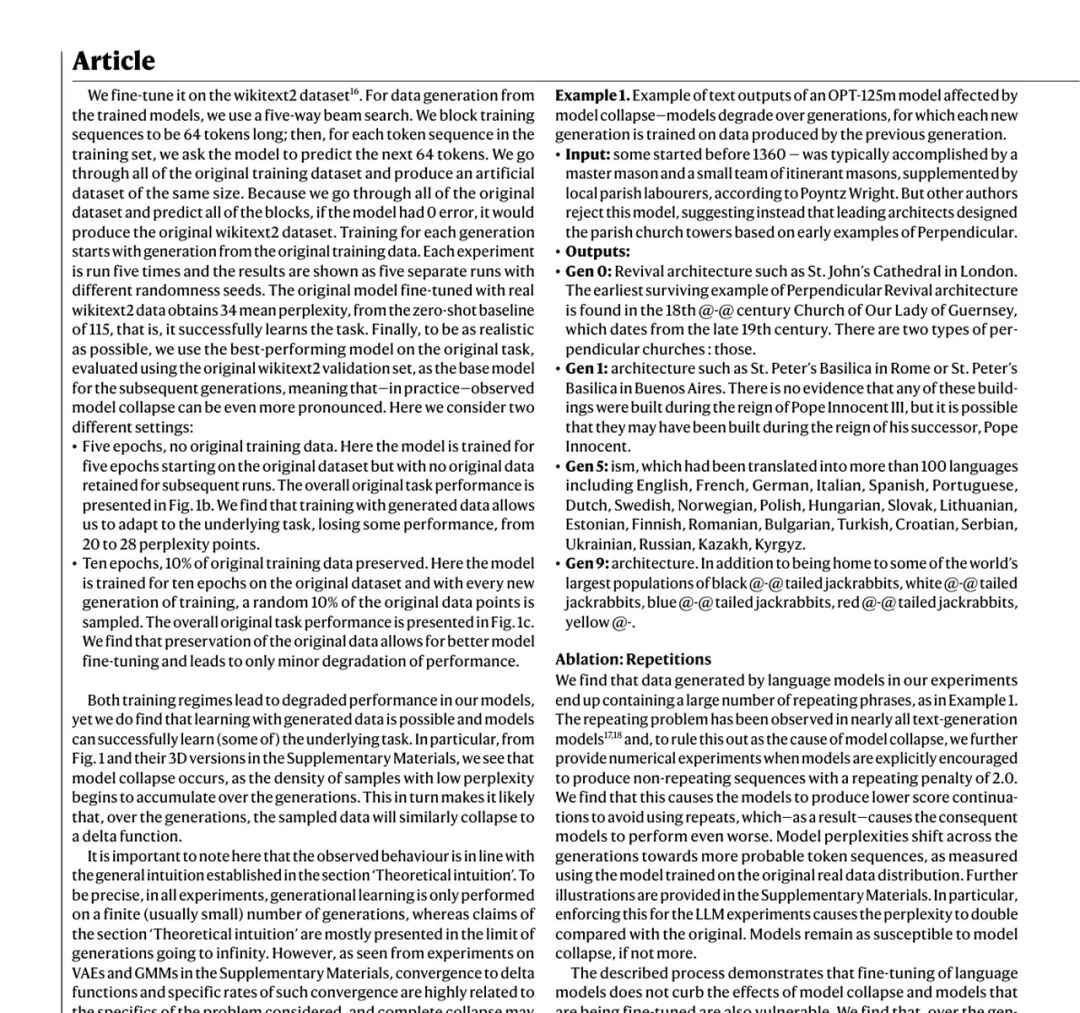
▲ 《自然》(Nature)正刊论文第4页实证:经历9代自喂养后,模型将中世纪教堂彻底扭曲为“各色野兔”的死循环。
从哥特式教堂到五颜六色的野兔,仅仅用了9代。
这项发现出自顶刊《自然》(Nature)正式发表的一篇重磅研究。来自牛津大学、剑桥大学、帝国理工和多伦多大学的科研团队,用严密的数学推导与实验证明了一个严酷现实:
当AI开始大面积吃下AI自己生成的数据,整个模型会发生不可逆的退化与崩塌。
科学家们给这种绝症起了一个名字,模型崩溃(Model Collapse)。
正在被悄悄污染的整个互联网
你可能会觉得:这不过是实验室里的极端测试,现实中哪有这么夸张?
真相是,现实比实验跑得还要快
今天的互联网,正在以一种肉眼可见的速度被合成内容淹没。知名SEO与网络数据机构 Ahrefs 对全网新发布的约90万个网页进行了深度检测,结果触目惊心:
高达 74.2% 的新网页,已经包含由 AI 生成或改写的文本。 纯粹由人类手打的网页,只剩下了可怜的四分之一。
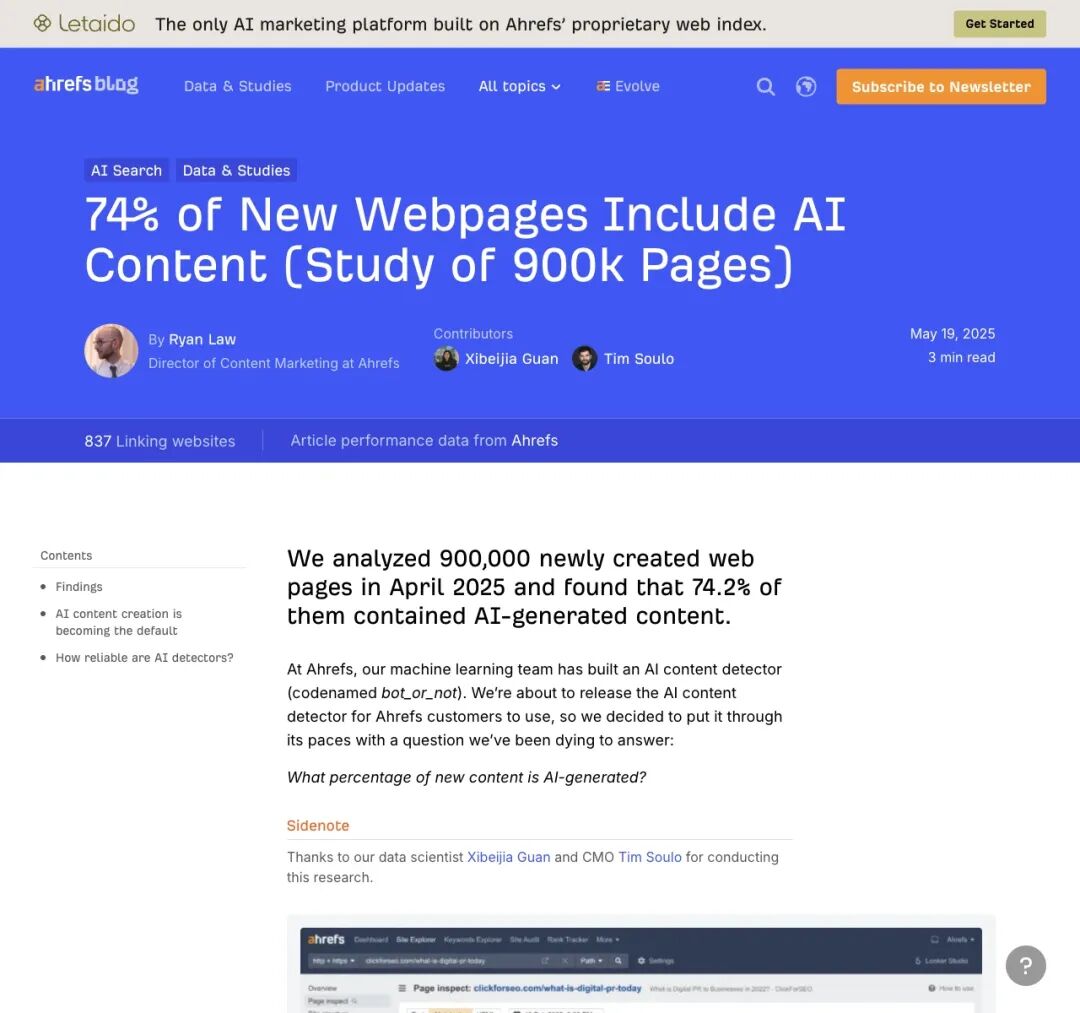
▲ Ahrefs 调查显示:互联网新增内容中,近四分之三已被AI文本渗透。
这就构成了一个致命的闭环:
- 第一代模型
吃着人类千百年来沉淀的高质量图书、维基百科和真实论坛帖子长大,聪明绝顶; 随后,成千上万的人用它批量生产营销号文章、自动化新闻、代码和社交推文,倾倒回互联网; - 下一代模型
的爬虫再次出动,把这些刚刚被AI“吐”出来的二手文本,当成养料吃进肚子里; 循环往复,周而复始。
牛津大学计算机系的 Yarin Gal 教授打了一个形象的比方:这就像是一个失控的AI回音室。
当大模型在互联网上找不到足够多的人类真实文字,只能“自产自销”时,一场数字世界里的“近亲繁殖”便开始了。
为什么AI吃自己会变傻?
要理解“模型崩溃”,并不需要深奥的数学知识,高中统计学就足够看透它的本质。
大语言模型的核心本质,是一个超级强大的“概率预测器”。给它上文,它去预测下一个最可能出现的词。
在人类浩瀚的语言世界里,分布就像一座平缓的大山:
- 山峰(常见内容)
:日常口语、高频词汇、大众常识; - 山脚的长尾(罕见内容)
:冷门的历史细节、精妙的比喻、偏僻的专业术语、独特的思考角度。
正是这些占据“长尾”的罕见知识,构成了人类文化的丰富性与智慧。
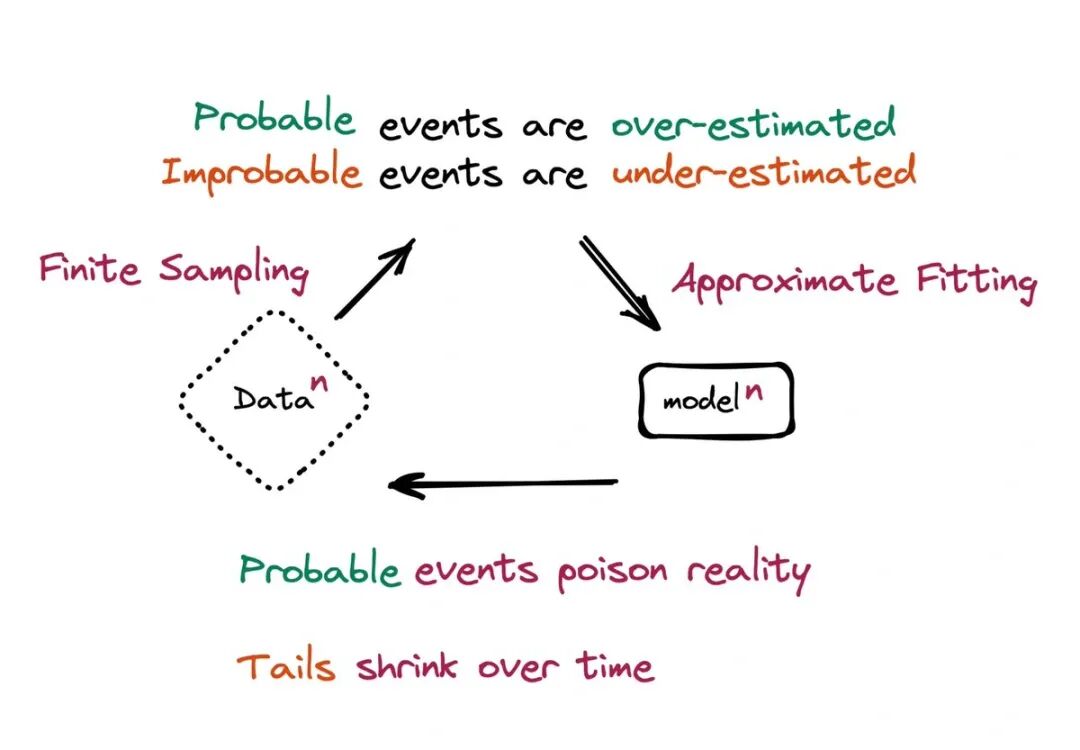
▲ 社交平台广泛传播的机理解释图:高频内容被过度估计,罕见长尾随递归训练不断萎缩直至消失。
然而,当AI根据概率去生成文本时,为了保证输出的稳定和通顺,它天然有一种偏好:更喜欢吐出高概率的“山峰内容”,略微忽视低概率的“长尾内容”。
- 第1代
吃下人类数据,把原本占 1% 的罕见长尾知识,压缩到了 0.8%; - 第2代
吃下第1代的数据,长尾知识进一步被稀释到 0.3%; - 第3代
开始,罕见知识彻底跌出采样概率,长尾完全消失。
这就是早期模型崩溃(Early Collapse):AI变得越来越套话连篇,失去个性,回答千篇一律。
进入晚期模型崩溃(Late Collapse)阶段后,情况进一步恶化:每一次采样都会引入统计误差,这些偏差代代叠加、持续放大,使模型的方差被极度压缩,最终死死卡在荒诞的单点输出上,正如前文出现的那样,满屏尽是“彩色大野兔”。
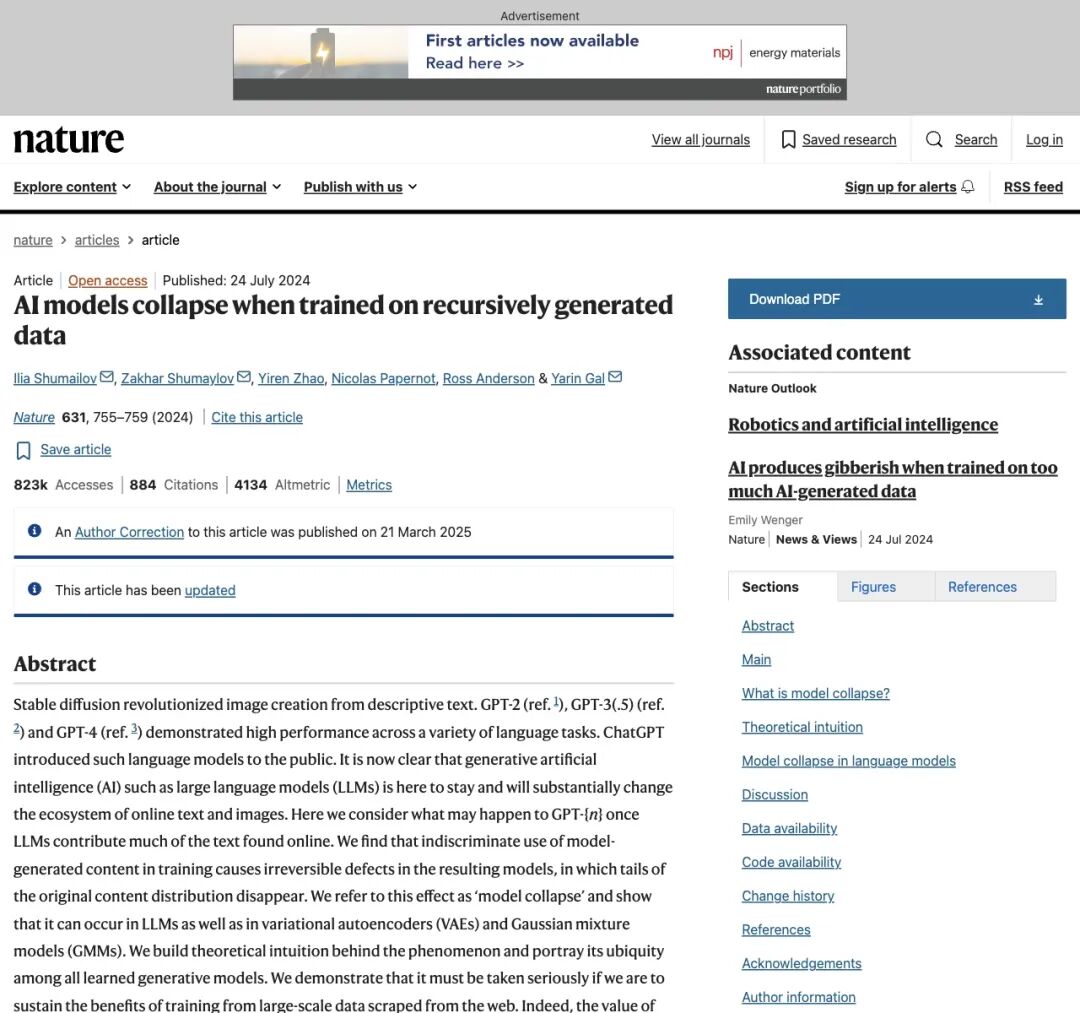
▲ Nature 论文《AI models collapse when trained on recursively generated data》。
研究团队在论文中明确指出,导致崩溃的三个核心推手在代际间形成了复合毒素:
- 统计近似误差
:有限采样必然丢失低频信息; - 函数表达能力误差
:神经网络本身无法100%完美贴合真实世界; - 优化算法误差
:每一次梯度下降都在原有的偏差上再偏一点。
三毒合一,大模型最终从博古通今的学者,退化成了满嘴胡话的精神病患。
2.5亿美元!未被污染的“人类语料”成了硬通货
当学术界的这篇《自然》论文把这层窗户纸捅破后,整个AI产业界瞬间惊出一身冷汗。
在此之前,很多乐观的技术派坚信:“数据不够用了?那就用AI生成数据去训AI嘛!” 他们把这称作永动机式的“合成数据飞轮”。
但现实给了所有人一记响亮的耳光
Scale AI 创始人 Alexandr Wang 随后公开发文指出:纯粹的合成数据是一个伪命题,必须转向混合数据(Hybrid Data)。
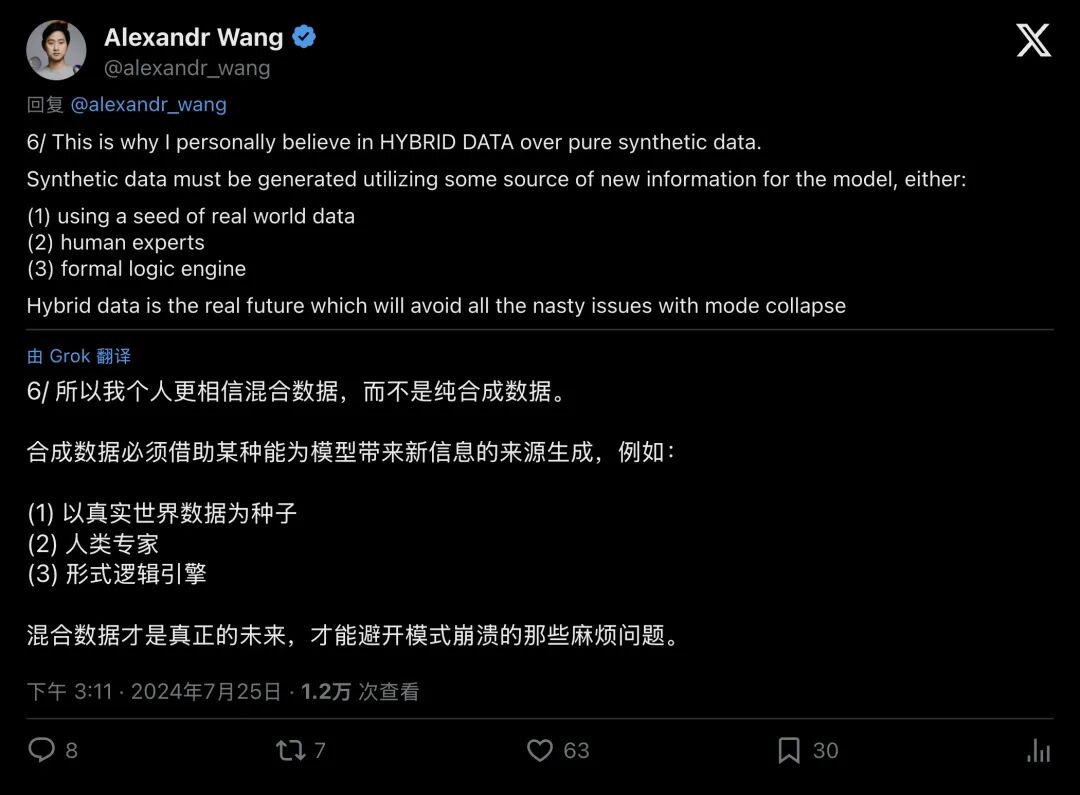
▲ Scale AI 创始人 Alexandr Wang 发推直言:纯合成数据必然导致崩溃,未来的出路是必须注入真实世界或人类专家的数据。
没有真实世界信息的注入,合成数据无异于在给大模型灌麻药。
这就解释了近一年来全球科技巨头一系列让人看不懂的“反常操作”:
- OpenAI 被曝斥资约 2.5 亿美元
,与传媒巨头新闻集团(News Corp)签下长达五年的内容授权协议; Reddit、各大国家图书馆、金融时报、美联社等传统出版机构,突然成了硅谷顶尖实验室排队上门送钱的“香饽饽”; 爬虫协议被空前收紧,各大平台纷纷给自己的内容砌起高墙。
他们疯狂争抢的,究竟是什么?
答案是:2022年ChatGPT横空出世之前、纯正且未被AI污染过的“人类文明原始档案”。
那些在互联网蛮荒年代,由一个个活生生的人类敲下的博客、打出的论坛争论、写下的冷门游记……这些曾经被认为毫无商业价值的碎碎念,在一夜之间变成了AI时代的“不可再生铀矿”。
谁手里握有未被污染的人类真实语料,谁就握住了防止下一代大模型智商滑坡的“压舱石”。
毁灭是注定的吗?解药与转机
大模型真的会就此走进死胡同吗?
科学家们在拉响警报的同时,也给出了关键的实验对照。在 Nature 论文的消融实验中,研究人员测试了一种挽救方案:
如果在每一代训练中,始终保留至少 10% 的原始人类真实数据作为锚点,模型的退化就会被大幅遏制,甚至接近“仅有轻微损耗”。
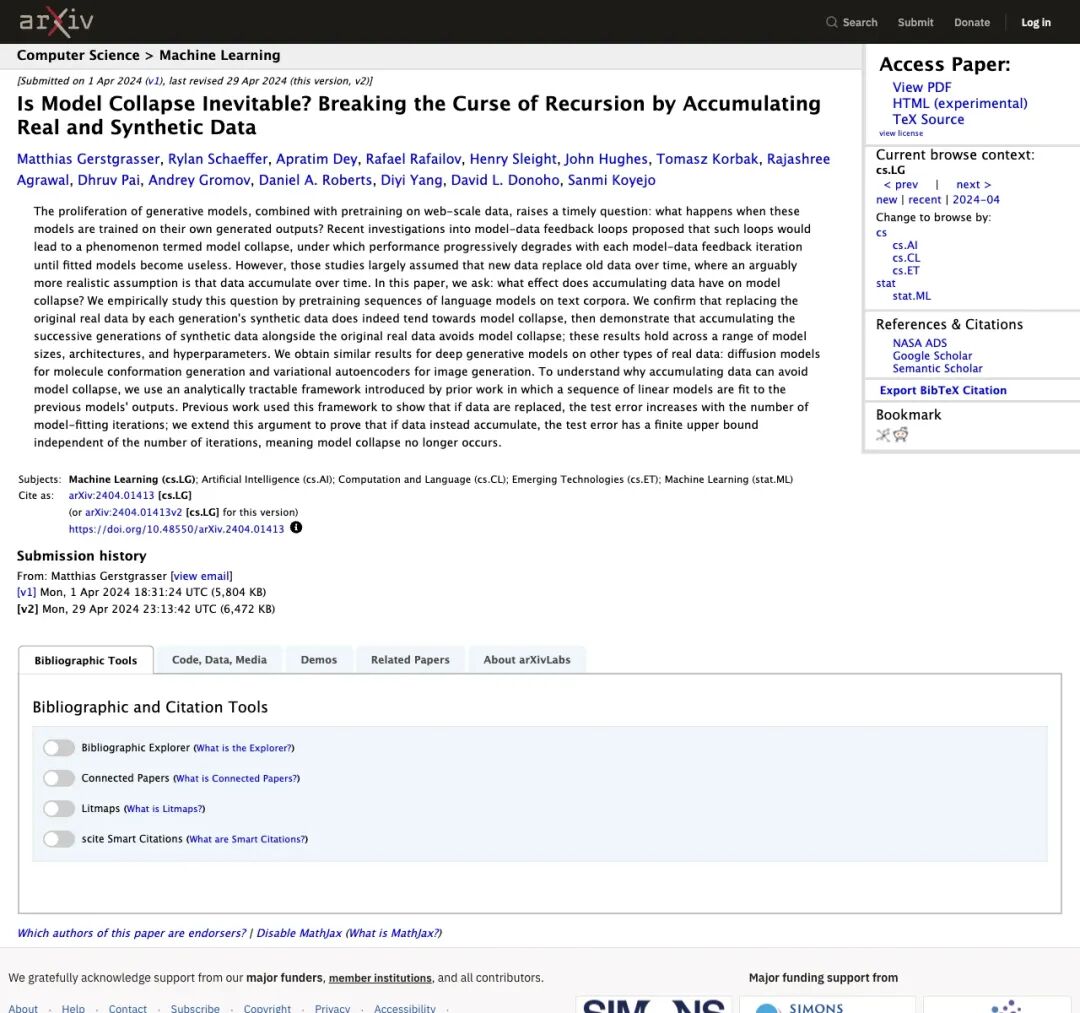
▲ 另一项后续重要研究提出:如果采用“累积数据”而非“完全替换”,崩溃并非不可避免。
后续来自斯坦福等团队的研究(Gerstgrasser et al.)进一步厘清了边界:Nature 论文所揭示的毁灭性崩溃,大多发生在一代完全“替换(Replace)”上一代的极端工作流下;而在现实中,如果我们采取“累积(Accumulate)”策略,即永远不扔掉人类历史数据,只是把高质量合成数据作为补充混入,误差在数学上是存在理论上限的。
这也表明,合成数据适度补充仍具可行性,核心在于守住人类原始语料的基本盘,防范机器生成内容反客为主。
要破除大模型近亲繁殖的魔咒,行业正在摸索几条生死线:
- 数据溯源(Provenance)
:给数据打上防伪水印,绝不能把二手AI垃圾不加区分地倒进训练池; - 形式化验证与真实反馈
:让AI去生成有确定逻辑规则的内容(如可以通过编译器验证的代码、数学定理证明),引入外部客观世界的裁判; - 极高价值的人类专家反馈
:让各领域的顶尖专家持续输出前沿认知,为模型注入宝贵的“低熵信息”。
写在最后:人类的“不完美”,才是智能的火种
这场关于“模型崩溃”的科学大讨论,给狂热的AI时代带来了一次最深刻的哲学审视。
过去几年,很多人陷入了一种虚无主义:既然AI写诗比我快、画画比我美、写论文比我严谨,那人类的写作还有什么意义?
Nature 上的这只“中世纪野兔”,给了这个问题最硬核的回答:
AI之所以能展现出惊人的智慧,是因为它站在了人类亿万次偶然、偏见、激情与独特灵感构筑的真实文明之上。
AI善于模仿平均,但文明的跃迁永远发生在“异常值的长尾”里,是某个哲学家孤僻的沉思,是某个诗人打破语法的怪异遣词,是某个科学家不合常理的直觉。
一旦把这些人类独有的“长尾”剔除,只剩下经过统计磨皮后的光滑文本,AI就会在空转的自恋中迅速枯萎。
不要停止表达,更不要放弃属于你的独特书写。
在这个充满合成垃圾信息的互联网上,你写下的每一个带有真实温度、甚至略显粗粝的字符,都是拯救未来数字世界不至于彻底疯癫的解药。