ARTICLE · 1054561
AI狂欢突发大反转!AMD两大巨头合体放话:GPU神话到头,CPU要杀回来了
北京时间凌晨4点13分,AMD官方推特毫无征兆地甩出了一段仅有58秒的预告片。
画面很暗,两个身着深色西装的男人在演播室里相对而坐。
一个是AMD的首席技术官 Mark Papermaster,带领AMD完成工程再造、主导了模块化小芯片(Chiplet)和Infinity总线架构的最高技术统帅;另一个则是被硅谷工程师们敬畏地奉为“Zen架构之父”的传奇首席架构师 Mike Clark。
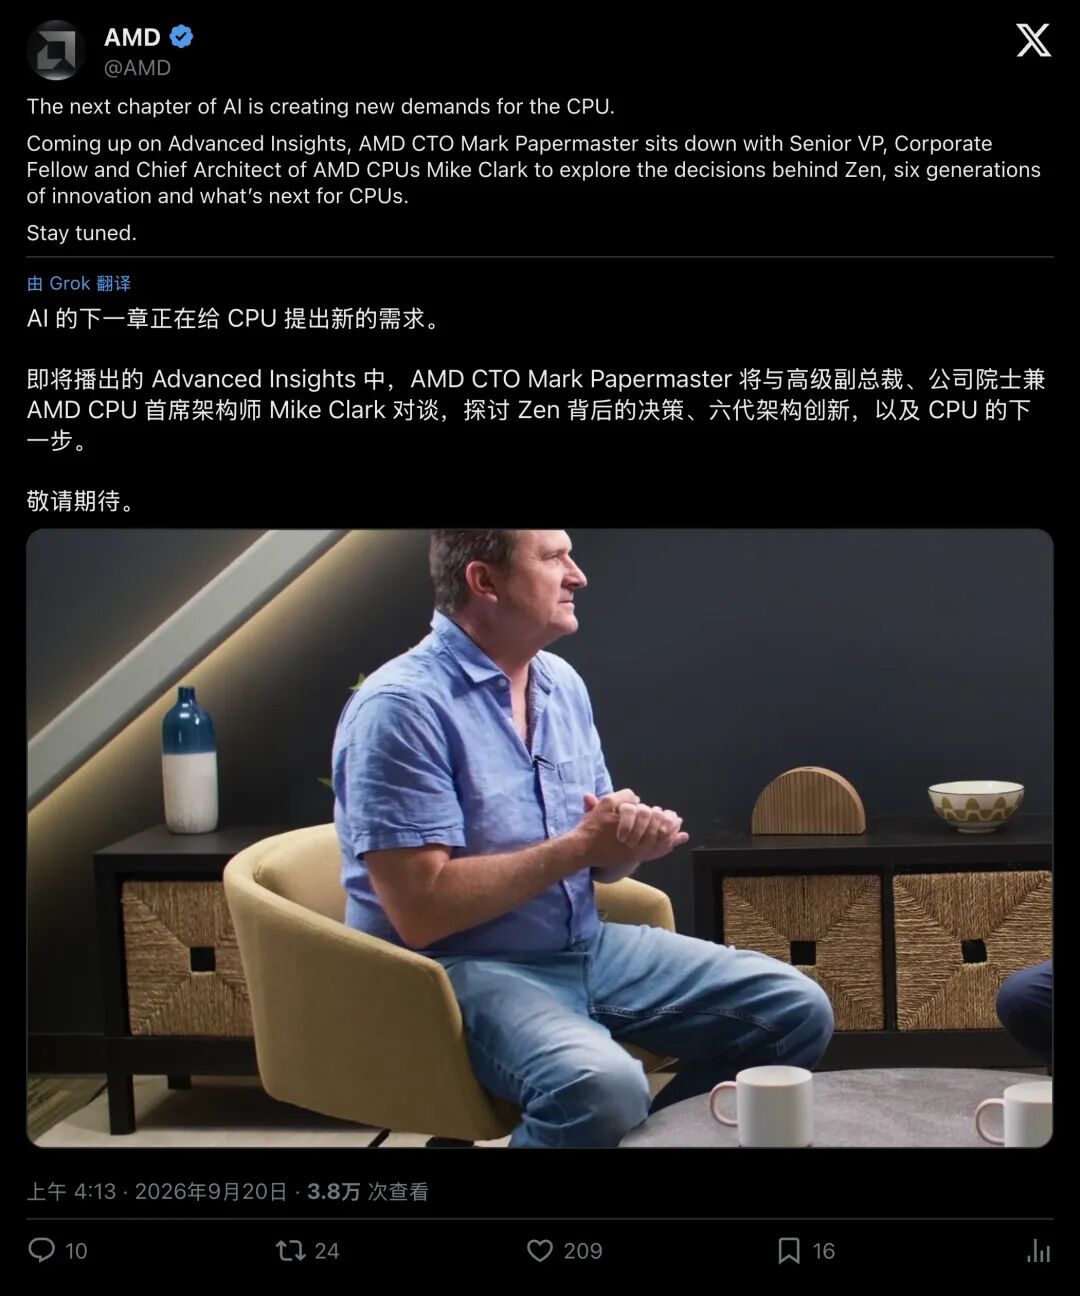
▲ AMD官方发布的对话预告片,两大技术掌门人首次在AI浪潮深水区同台复盘
配文只有冷峻的一行字:
“AI的下一章,正在给CPU提出全新的需求。”
整个半导体和AI圈子瞬间炸锅
在过去三年里,全世界都沉浸在英伟达掀起的GPU狂欢中。黄仁勋成了科技界最耀眼的摇滚巨星,每一家大厂都在为抢购单价数万美元的算力卡争得头破血流。在公众的认知里,CPU早就沦落成了“边缘人”,它似乎只是数据中心里给GPU递毛巾、打杂的苦力。
甚至连老玩家都在AMD的推文下酸溜溜地抱怨:
“你们已经忘了当年帮你们度过破产危机的游戏玩家了吧?现在你们不需要我们了,真可耻!”
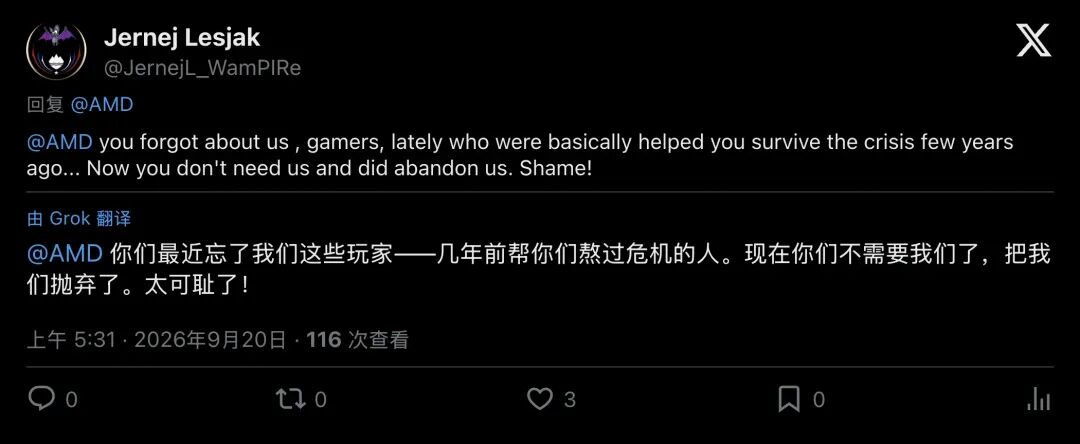
▲ 玩家在评论区宣泄不满,折射出整个消费级市场对“算力倾斜GPU”的普遍焦虑
但不少敏锐的芯片工程师,早已从这段短视频里嗅到了风向转换的信号。
所有人以为的剧本,被彻底颠覆了
这场对话向全行业释放了明确的信号:当AI从单次对话迈向“智能体(Agent)”时代,狂飙了三年的GPU独角戏,正迎来最凶险的算力撞墙期!
惊天反转:智能体时代,CPU算力需求暴涨400%!
为什么连AMD的技术掌舵人都坐不住了,非要拉着Zen架构的总设计师出来正本清源?
核心原因就在于:智能体(AI Agent)。
就在前不久的闭门峰会上,AMD CTO Mark Papermaster抛出了一个震惊业界的论断:支撑当下的智能体应用,需要整整4倍(4x)的CPU算力!
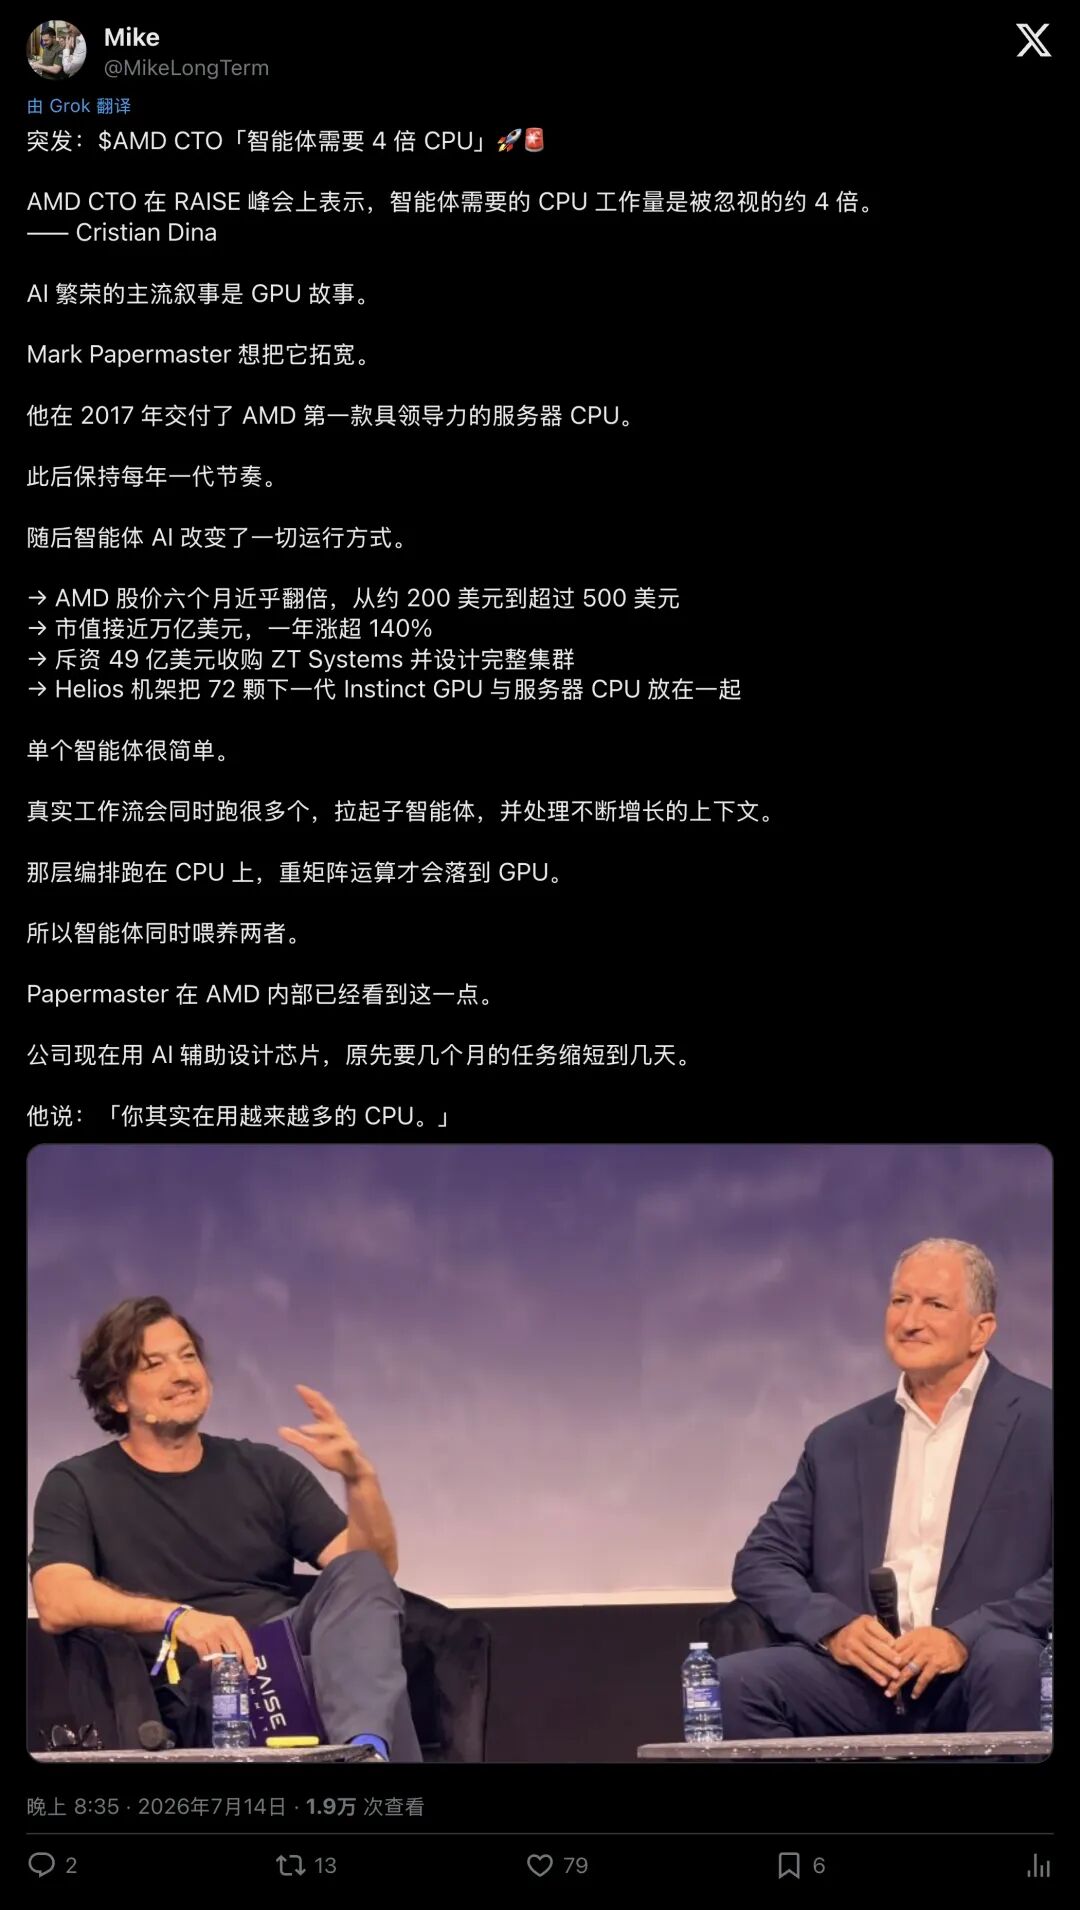
▲ 市场分析与科技博主迅速跟进AMD CTO的“4倍CPU需求”论断
很多人可能会问:大模型明明主要依靠GPU执行矩阵乘法,怎么突然需要4倍的CPU了?
我们用一个极简的比喻,把这层窗户纸彻底捅破:
过去的传统大模型(单次推理),就像你去前台点一杯美式咖啡。你提出需求:“给我讲个冷笑话”CPU只负责在门口收银、打个小票(分词与调度),接着后厨里那台昂贵的超级咖啡机(GPU)全力轰鸣两秒钟,吐出一串文字。矩阵乘法算完了,任务结束在这个模式下,GPU忙到冒烟,CPU确实只是个端茶倒水的。
但现在的智能体(Agentic AI),变成了你要AI自己去经营一家连锁咖啡馆!
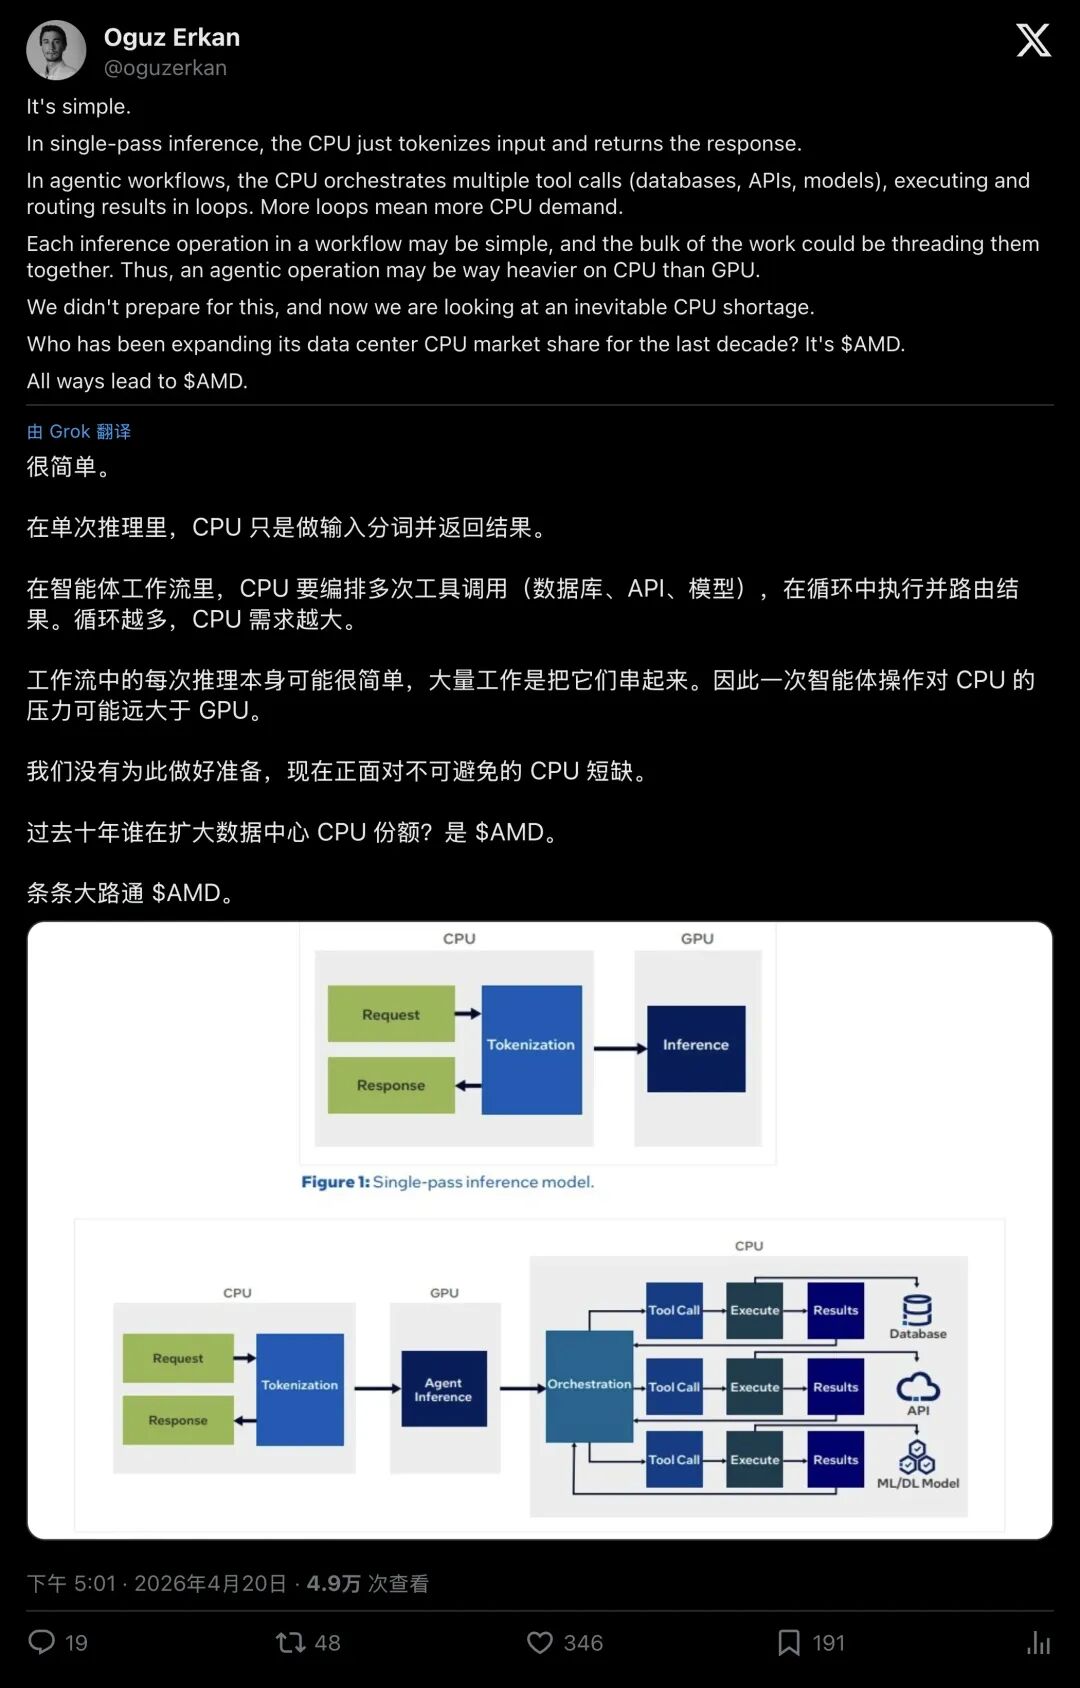
▲ 从单次简单推理到多循环智能体工作流,控制权彻底转移回CPU
智能体接到复杂任务后,需要经历多步骤的连续闭环:
先写出一套行动计划; 发现缺数据,自动调用浏览器去爬取网页; 打开数据库执行SQL查询; 发现有错误,自己在沙箱里写一段Python代码并运行验证; 解析结构化的代码输出,组装长达数万字的上下文; 最后再把数据喂给大模型做下一步决策……
工具调用、代码沙箱执行、网页抓取、网络路由、上下文动态拼装与状态机管理……这占了整个工作流80%以上的重活累活,全都是低延迟、分支繁杂、逻辑极其复杂的串行任务,这些脏活累活,GPU一个都干不了,全部重重砸在了CPU头上!
残酷真相:价值千万的GPU,居然在机房里被“活活饿死”?
如果说业界的讨论还停留在商业直觉,那么学术界的一纸顶级论文,则把这场算力危机彻底血淋淋地撕开在世人面前。
佐治亚理工学院与英特尔联合发表的重磅论文《Towards Understanding, Analyzing, and Optimizing Agentic AI Execution: A CPU-Centric Perspective》(arXiv:2511.00739),对当下主流的智能体系统做了一次彻底的CT扫描。
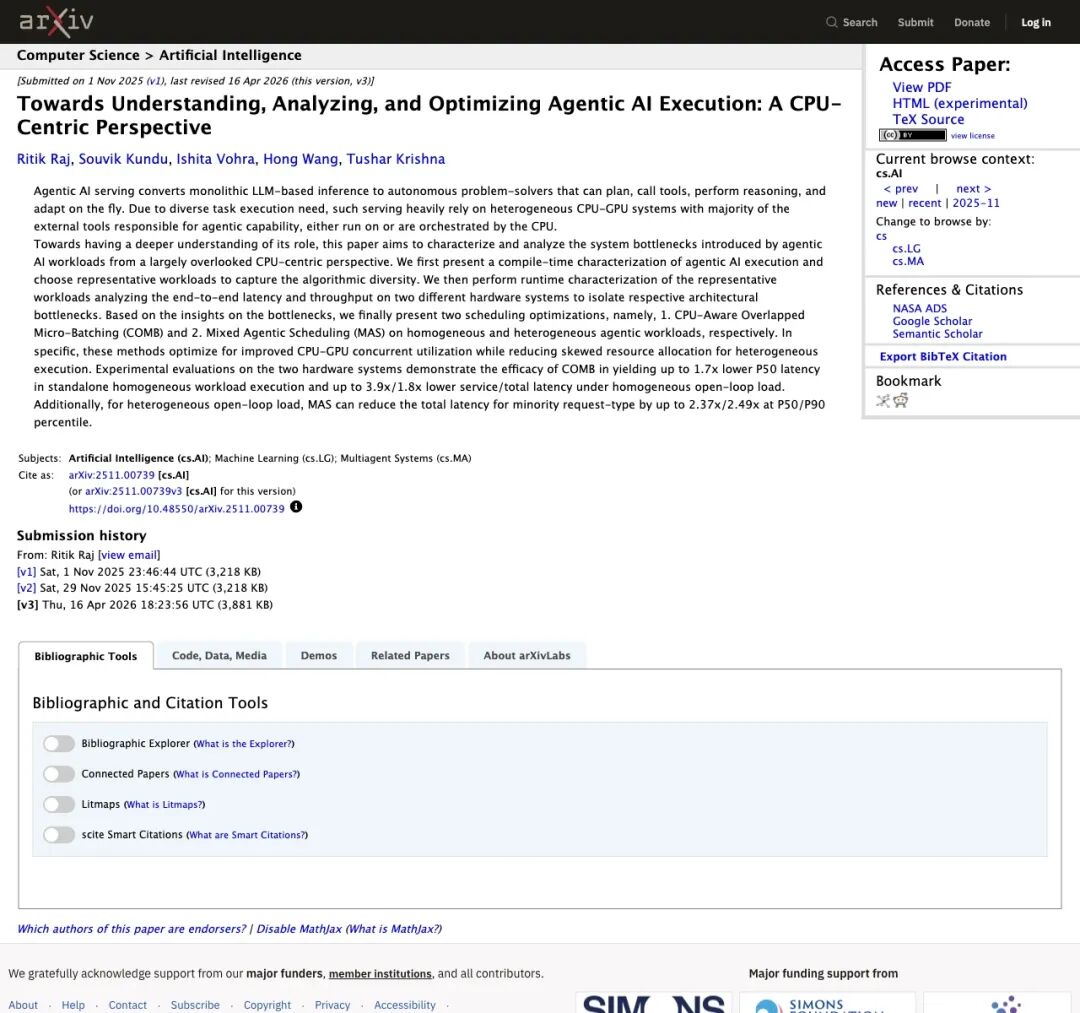
▲ 学术界从“CPU中心视角”切入,系统揭示智能体负载下的系统性能瓶颈
论文的测量结果,让所有盲目堆砌GPU的工程师冷汗直流:
在工具主导的智能体负载中,工具和编排处理占端到端时延的比例,最高竟然达到了恐怖的88%!
更具讽刺意味的现象发生了:当你为了提升性能,把系统里的显卡换成更昂贵、算力更狂暴的顶级GPU时,整体瓶颈反而以更快的速度狠狠撞向了CPU!
想象一下:你花了几千万买了一辆时速400公里的顶级超跑(GPU),结果前面的交通管制调度员(CPU)是个骑自行车的,路口全被堵死。超跑只能在收费站熄火排队,眼巴巴地等着调度员把路障清理干净。
在无数的数据中心里,价值连城的GPU正在大面积空转、等待、打瞌睡。
这就是为什么业内资深分析师在推特上一针见血地指出:
“AI需求拉动CPU是一个被严重低估的角度。很多买家很快就会发现,CPU能不能跟上节奏,决定了你手里的GPU究竟是算力怪兽,还是一堆发热的废铁。”
▲ 敏锐的技术买家已意识到:CPU正在成为决定机柜整体效能的关键胜负手
传奇现身:“Zen之父”在十年前就埋下的杀手锏
看懂了这个底层逻辑,你就能彻底读懂为什么AMD要让 Mike Clark 坐在镜头前。
在芯片世界里,Mike Clark是一个近乎图腾般的名字。
他在AMD干了整整30多年从K5时代开始,他几乎参与了AMD每一代核心架构的设计。
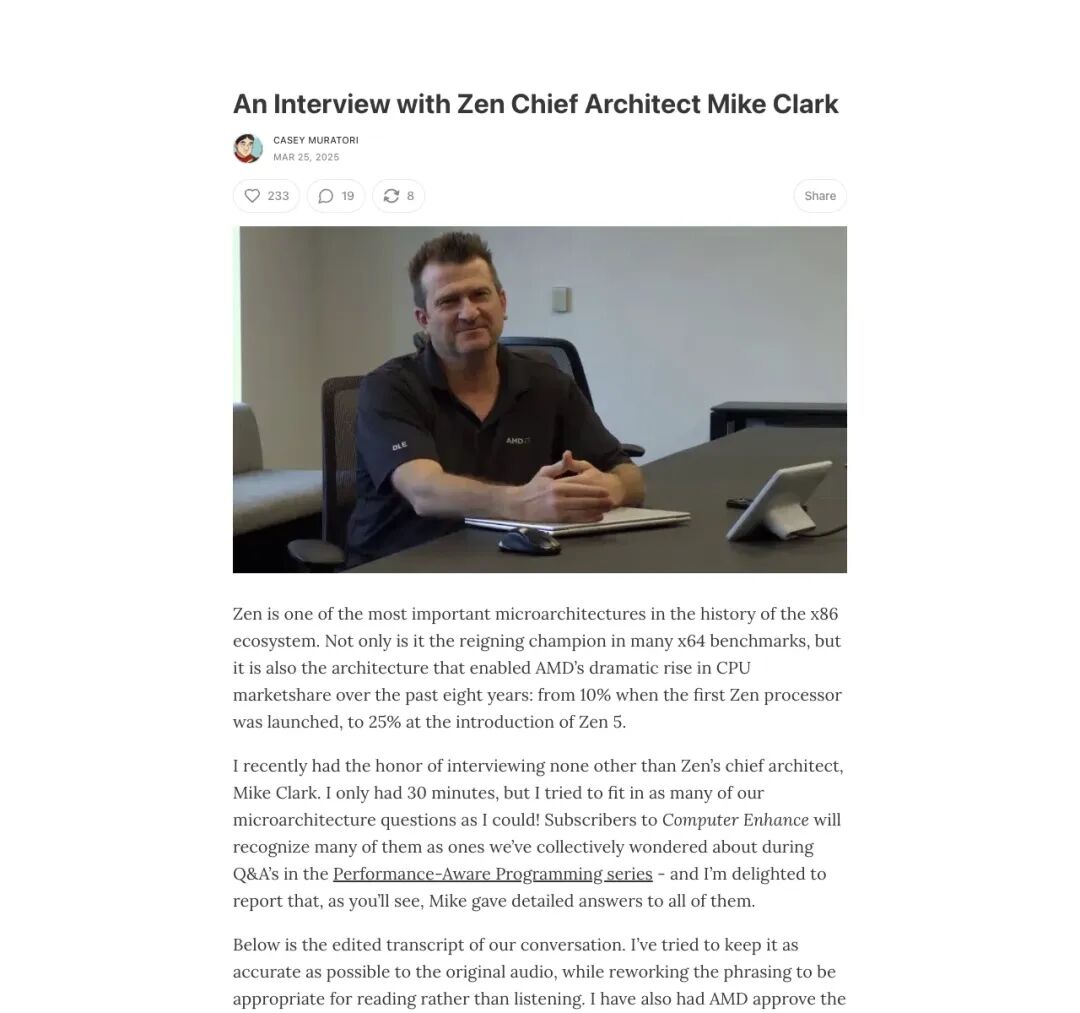
▲ 传奇芯片架构师Mike Clark,数十年来亲手缔造了x86芯片史上的多次逆袭
十年前的2016年,AMD被英特尔压得喘不过气,推土机架构惨败,公司在破产的悬崖边缘摇摇欲坠。正是Mike Clark带着团队破釜沉舟,立下了代际IPC提升40%的军令状,亲手打造了初代 Zen 架构。
那一役,AMD硬生生从ICU里杀了出来,开启了一段芯片史上最波澜壮阔的逆袭神话,Zen 1、Zen 2、Zen 3、Zen 4、Zen 5……AMD在服务器CPU市场的份额从不足10%一路狂飙突破25%。
▲ AMD官方Zen核心架构设计理念:推动Ryzen与EPYC服务器处理器的技术跨越
而在刚刚过去的Zen 5架构技术日上,很多媒体曾感到不解:为什么Zen 5要在底层做那么大幅度的改动?为什么要把发射宽度从6条疯狂加宽到8条ALU?为什么要把整个L1/L2缓存通路和AVX-512向量单元全部重新布线?
当时Mike Clark在访谈中谈及设计初衷:
“Zen 5 为驱动未来算力负载奠定了全新的硬件底座。硬件通路被彻底拓宽后,软件生态会加速跟进创新,更深层的架构效能将在后续世代充分展现。”
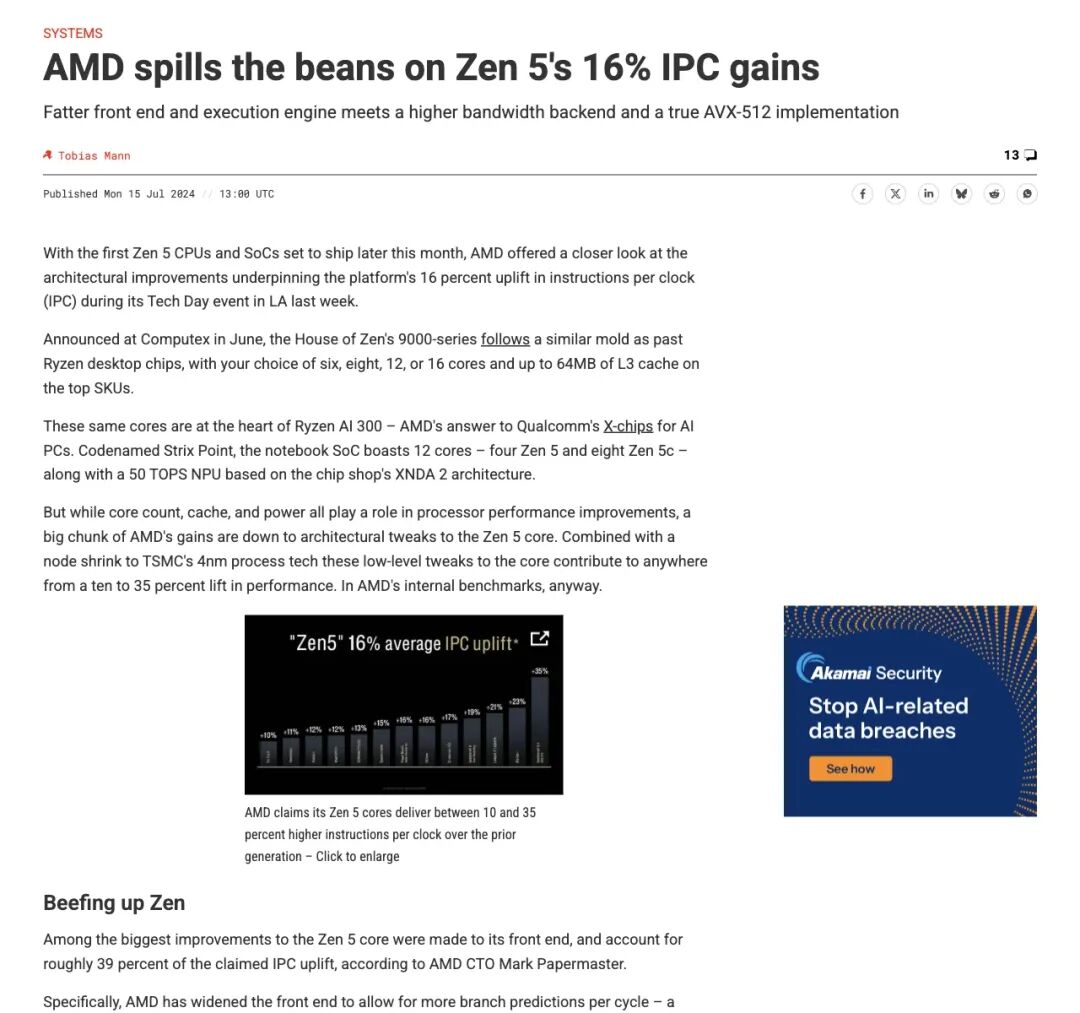
▲ Zen 5大幅加宽执行流水线与向量带宽,正是为了承载未来的异构控制重压
原来,在所有人都在为单次大模型跑分狂欢的时候,这位顶级架构师就已经预判到了智能体时代的算力洪流!
面对智能体那种毫无规律、充满突发性分支预测、庞大上下文数据搬运的严苛工况,高度宽阔的执行流水线、低延迟缓存带宽与强大的单核控制能力,正是应对高压流量的关键。
终局之战:从卖芯片,到“喂饱一整个机柜”
把所有的线索拼在一起,一张庞大的战略蓝图终于浮出水面。
AMD的战略布局直接瞄准了整座数据中心算力秩序的系统级重构。
耗资 49 亿美元 闪电收购云服务器设计巨头 ZT Systems,直接补齐整机柜系统级工程能力; 祭出机架级方案 Helios:在一台机柜里,极其暴力地塞进 72 颗 Instinct GPU 与 18 颗第六代 EPYC(代号 Venice,基于 Zen 6 架构)服务器 CPU; 依托 Pensando 高性能网络与 ROCm 软件栈,实现 CPU 与 GPU 之间以微秒级延迟交换数据。
▲ AMD将计算愿景从吉瓦级绿色数据中心直接延伸至端侧Agentic PC
根据最新的官方白皮书与技术披露,基于 Zen 6 打造的代号为“Venice(威尼斯)”的下一代 EPYC 处理器,最高拥有 256 核 512 线程,同时全面支持 16 通道高频 DDR5 内存、PCIe Gen 6 与 CXL 3.1 内存池化技术。
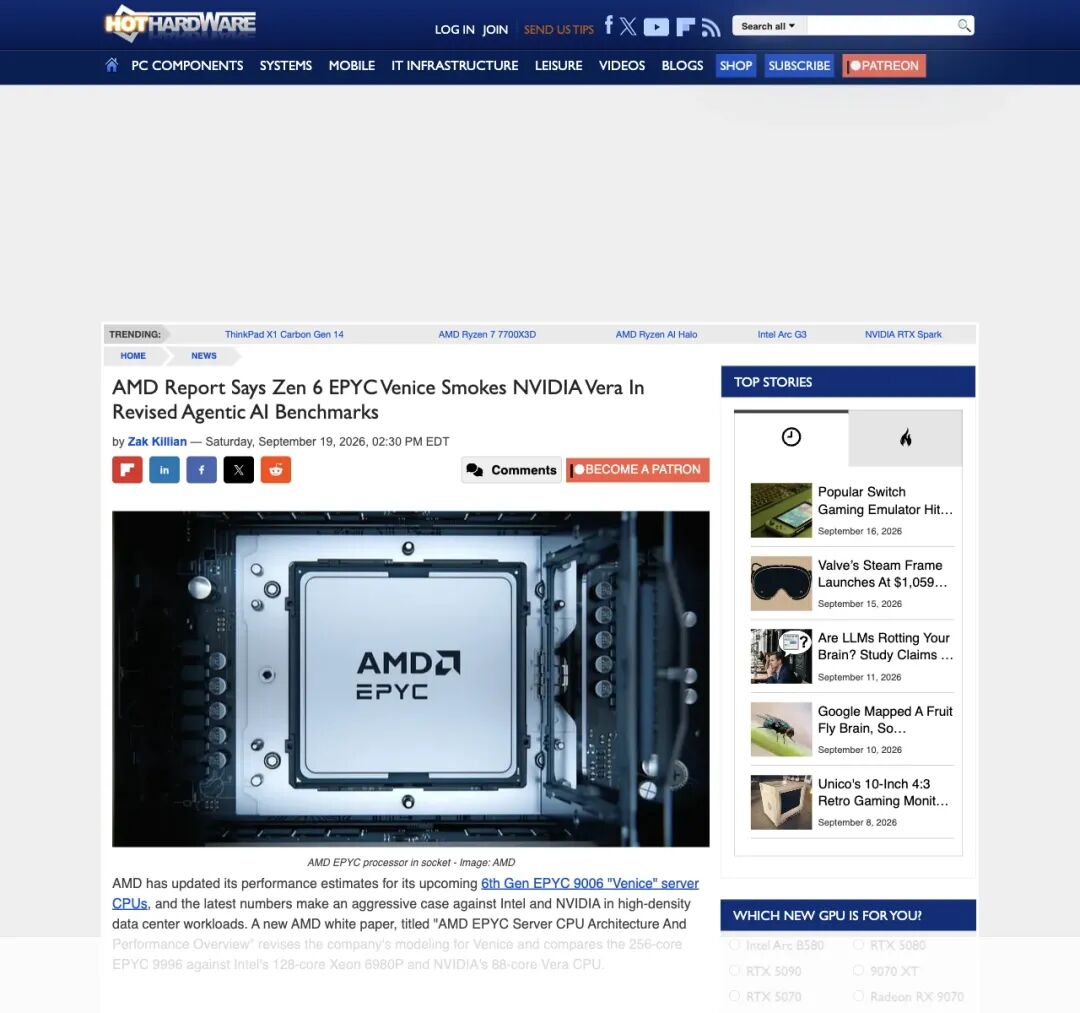
▲ 新一代EPYC直击智能体基础设施痛点,强调机柜级协同与控制面吞吐
Papermaster 把这种整机柜设计原则形象地称为:“Feed the beast(喂饱这头算力猛兽)”。
在单核主频撞墙、功耗逼近极限的物理现实下,GPU是那头吞噬矩阵的狂暴猛兽;但只有拥有海量核心、超大带宽、极低延迟调度的巨无霸 CPU,才能源源不断地把清洗好的任务和指令塞进猛兽嘴里,不让整台机柜浪费哪怕一毫秒的功耗。
计算历史的螺旋上升
回顾半导体发展的六十年,每一次算力重心的转移,都在重复着同一个深刻规律:
2000年代初,可编程GPU崛起,业内一度视CPU为附属角色;但随之而来的大规模图形管线,促使CPU全面提升单核主频与多线程能力; 2010年代,云计算浪潮席卷全球,虚拟化、网络协议栈和分布式存储的大山压下来,最终造就了服务器CPU市场的黄金十年; 今天,当大模型跨越初期试水阶段,全面接管复杂工作流进入 Agent 时代,算力的天平再次发生了微妙而深刻的倾斜。
异构计算的演进已脱离单纯的零和博弈。
GPU 负责力拔山兮的冲锋陷阵,而 CPU 则是运筹帷幄的统帅中枢。
当 Mark Papermaster 和 Mike Clark 并肩坐在演播室,这场关于 Zen 架构代际演进的深度复盘,向整个计算产业给出了清晰的答案:
AI 的上半场,世界见证了 GPU 的狂飙;但决定 AI 下半场能走多远的,依然是那颗永不熄灭的 CPU 心脏!