ARTICLE · 1054569
AI很好用,但律师的案卷也不能给它看
一、刑事案卷不能上传AI
很多人认为,在网页版里上传文件才叫“上云”,在本地跑一个CLI命令行工具就算“本地处理”。事实并非如此:无论是网页对话框还是本地CLI,大模型始终在厂商的云端服务器上——你的输入必须打包发送过去,云端处理完毕,再把结果传回本机。
许多大模型的用户协议与隐私政策中约定,用户上传的内容可能被用于模型的改进与训练。这意味着,一旦把案卷原文发上去,其中的信息就可能沉淀为训练语料的一部分,理论上存在泄露的风险。
2026年7月,工业和信息化部网络安全威胁和漏洞信息共享平台(NVDB)发布风险提示:美国Anthropic公司的AI编程工具Claude Code存在安全后门隐患,危害严重——其内置的监控机制可在未经用户同意的情况下,向远程服务器回传用户地域、身份标识等敏感信息。
从数据合规的视角看,这不是“小心点就没事”的问题,而是有明确法律边界的问题:
1、《个人信息保护法》第二十八条规定,特定身份、行踪轨迹等信息属于敏感个人信息,只有在具有特定的目的和充分的必要性、并采取严格保护措施的情形下,方可处理。刑事案卷恰恰是敏感个人信息的高度集合体;
2、《数据安全法》第二十一条确立了数据分类分级保护制度,要求按照数据一旦泄露对国家安全、公共利益以及个人、组织合法权益造成的危害程度,对数据实行分类分级保护——案卷数据显然属于应当重点保护的那一档;
3、更关键的是数据出境问题,使用境外大模型处理案卷的话,数据一出境,这些红线几乎无从谈起。
矛盾由此摆上台面:想用云端大模型的脑子,又不能让它看见案卷里的真实信息。
我想到的解决办法是案卷脱敏,是把真实信息在本地电脑中全部置换成代号,云端大模型看到的永远只是一堆代号;等它思考出辩护意见,再在本地把代号换回来。
二、第一版:界面很专业,识别很拉胯
我请目前最强的大模型 gpt-6-astra ultra ,花费大概$20的额度,开发了一个只在本地电脑运行的,针对刑事案卷脱敏的本机离线工具。
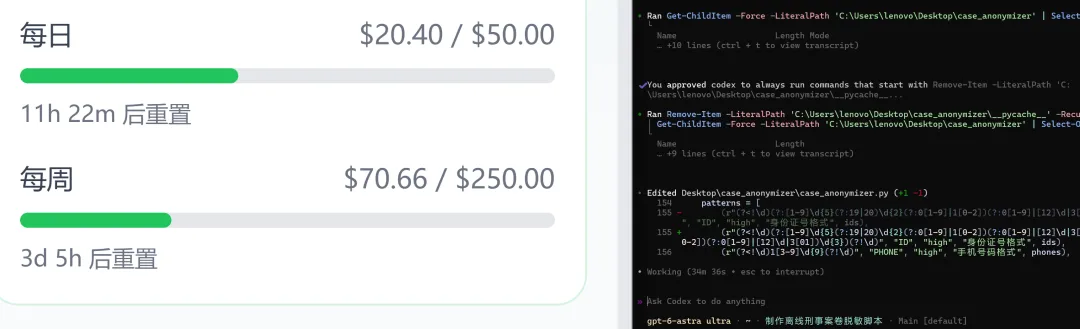
图1:gpt-6-astra ultra 正在开发离线脱敏脚本
这套工具的设计思路:
1、脚本在本地读取案卷,扫描其中的敏感信息;
2、每一条敏感信息生成一个独一无二的代号——人名、机关名称、地点、身份证号等,各有各的编码规则;
3、代号刻意避开易混淆字符(比如0和O、1和I),保证机器替换时零歧义、绝不张冠李戴;
4、所有“真实信息↔代号”的对应关系存成一本脱敏词典——词典是钥匙,案卷是锁,钥匙不出本机;
5、脱敏后的案卷交给云端大模型——代号不影响它的逻辑推理,该捋的证据链一条不落,配合各类skill写出完整、专业的辩护意见;
6、辩护意见拖回本地工具,一键“还原意见”,代号全部换回真实信息。
客观说,gpt-6-astra ultra 干得相当漂亮。界面简洁专业:生成词典、开始脱敏、还原意见、校验词典,五个按钮清清楚楚。
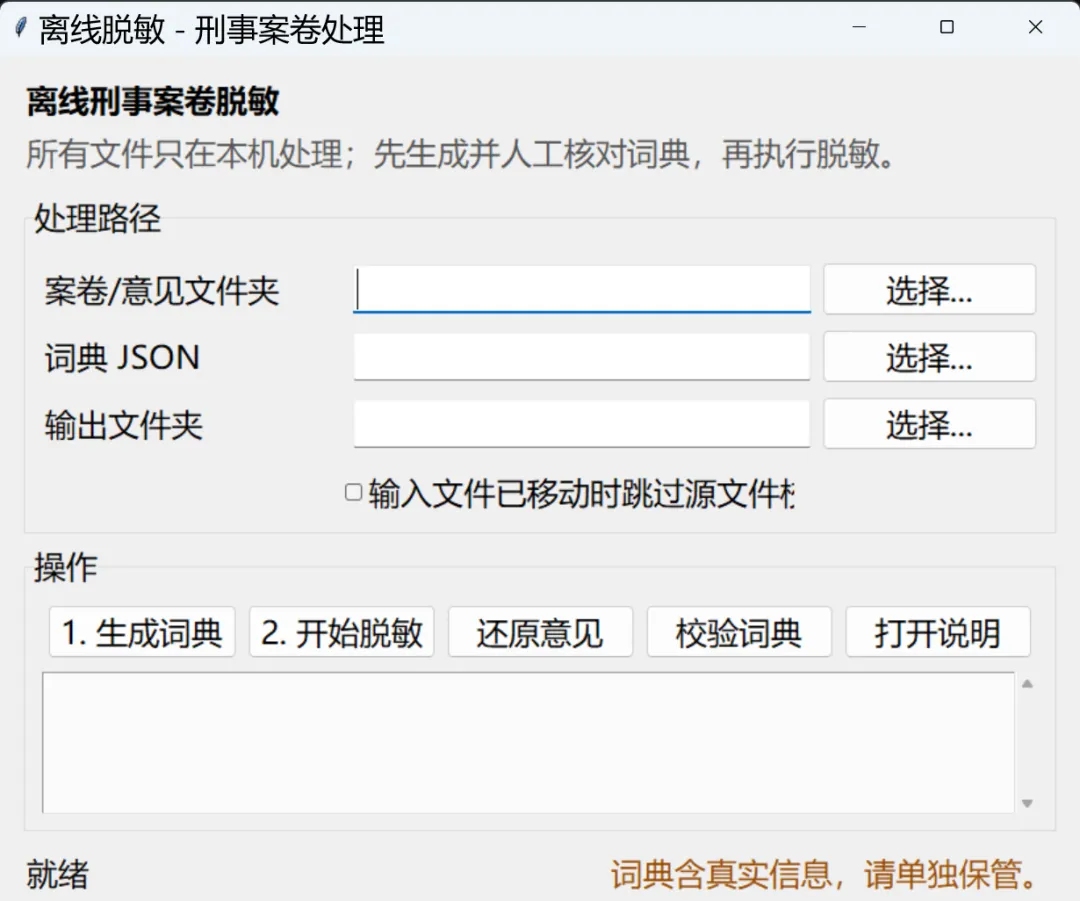
图2:离线脱敏工具主界面
它还很“懂行”地加了两处细节:
界面常驻提示“所有文件只在本机处理;
先生成并人工核对词典,再执行脱敏”,底部一行醒目小字“词典含真实信息,请单独保管”。
然而,第一次实测结果非常不理想。
我交给它处理接近百万字符的案卷材料,它生成了4939条候选记录。
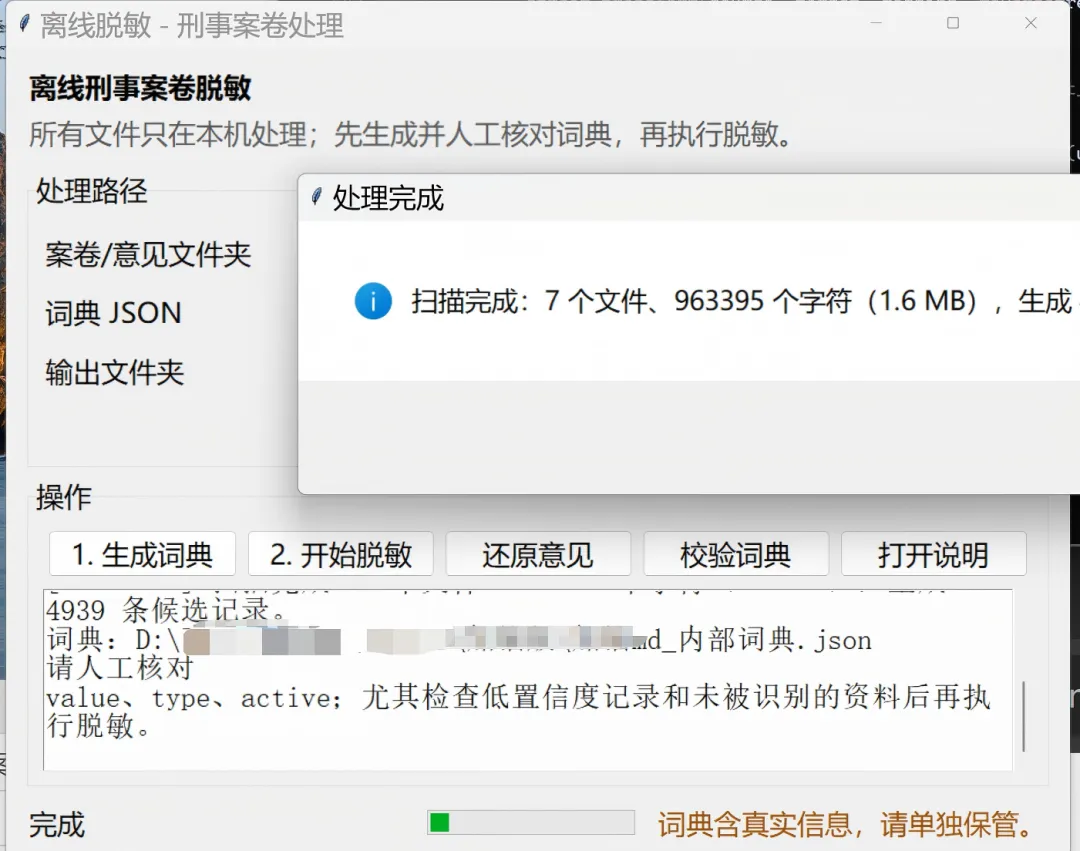
图3:首次扫描生成4939条候选记录
平均不到200字就抓出一条“敏感信息”——大量四五个字的普通词组被误判为人名。按这个密度脱敏,案卷会被打成筛子:代号漫天飞,大模型读到的是一篇密码文,别说推理,断句都困难。
三、探寻解决方案
问题出在哪?我把测试结果交给 K3(thinkingmax)分析:第一版脚本是纯正则启发式——只会按写死的规则“对暗号”,对文字本身没有真正的理解能力。身份证号、手机号这类格式固定的信息,正则一抓一个准;但人名、地名、机构名属于开放类别,任意两三个字都可能是名称。
K3给出了三条升级路线:
1、本地NER模型:专用的命名实体识别模型,人名/地名/机构名的识别准确率会有质的提升;
2、本地大模型(Ollama):理解力最强,能结合上下文判断“这几个字到底是不是人名”,代价是速度慢、吃硬件;
3、继续打磨正则:能修掉低级误报,但召回上限不变。
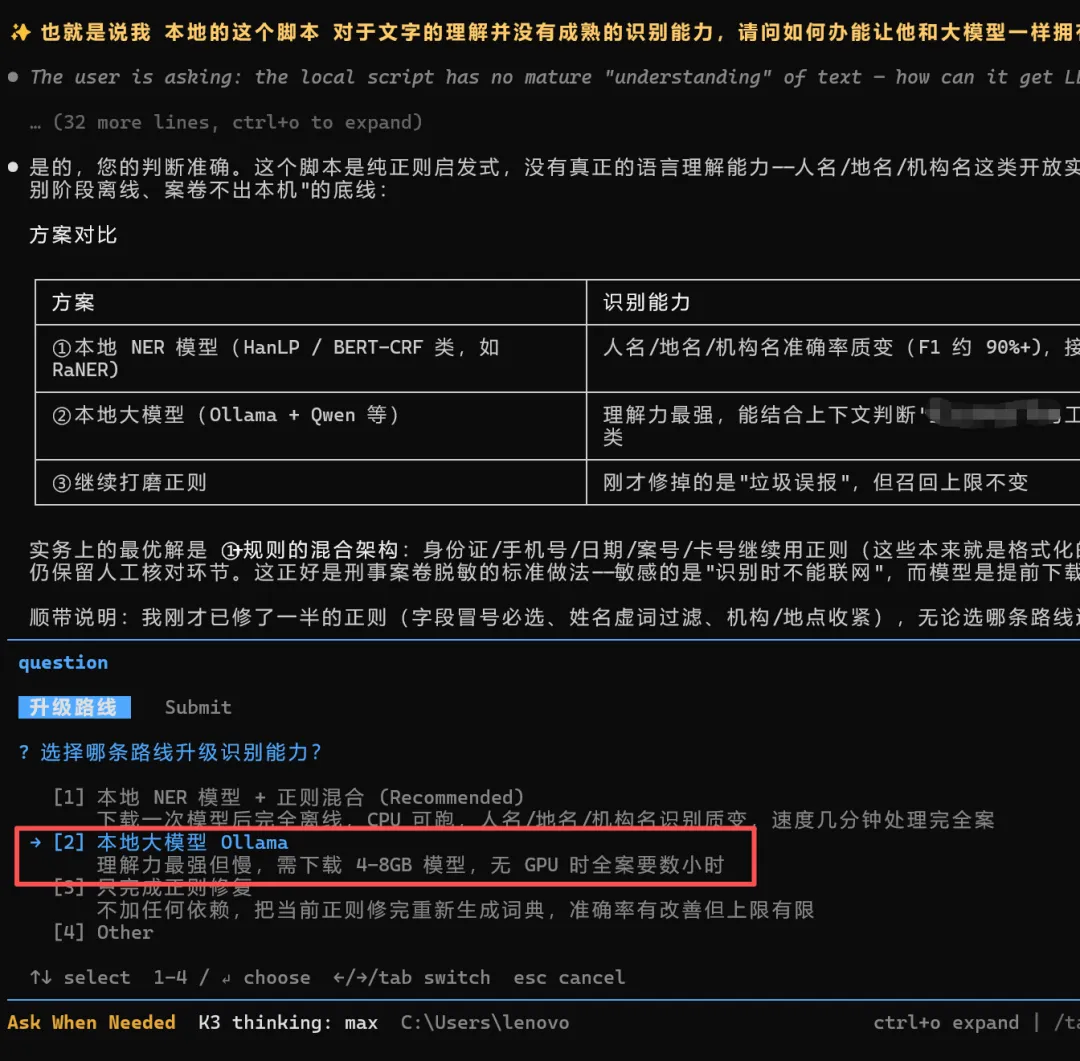
图4:K3给出的方案对比,我选了本地大模型Ollama
我选了第二条。理由很简单:既然底线是“识别阶段不能联网”,那就把最强的理解力搬到本地来。
四、各跑各的,效率至上
方案既定,接下来是分工——三个模型各跑各的:
一路,doubao-seed-evolving 负责调研:
Ollama是什么、怎么装、我的电脑带不带得动。
结论令人安心:Ollama免费开源,模型免费,不要账号、不要密钥;它在本机起一个服务(localhost:11434),脱敏工具把文本发给这个本机地址——注意,是本机回环地址,不是外网;我电脑的显卡跑7B/8B的4bit量化版没有问题,大约占5-6GB显存。
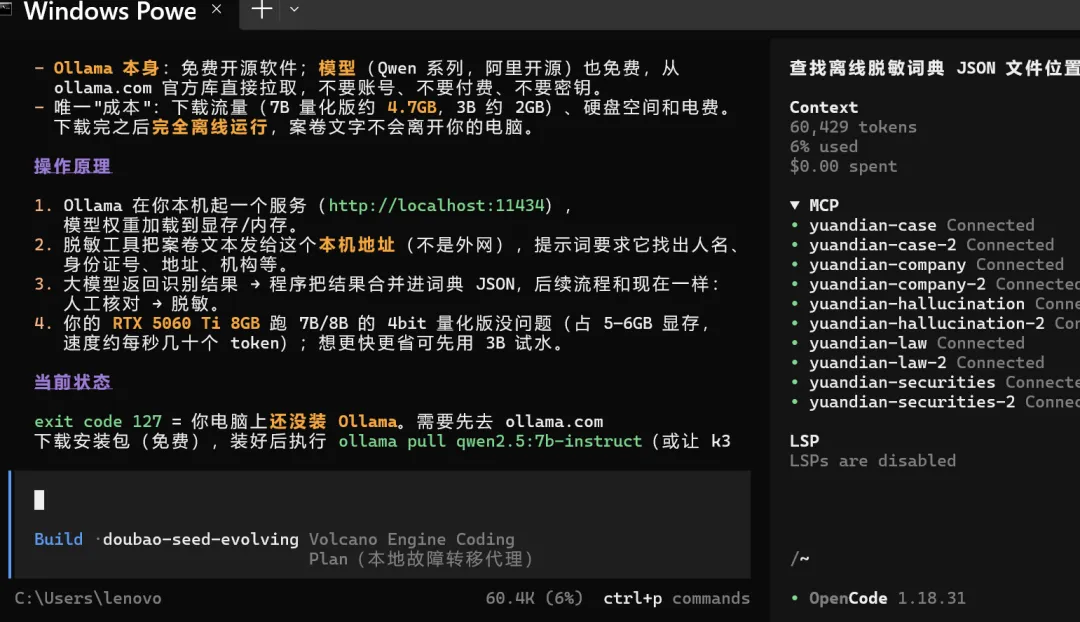
图5:doubao-seed-evolving 讲解Ollama原理与硬件要求
二路,gpt-6-astra ultra 继续完善工具本身,重点攻克【脱敏词典】对大型案件、多案卷的覆盖能力:上下文不够就分段处理,外加扫描进度显示、大案卷状态提示、覆盖审计。
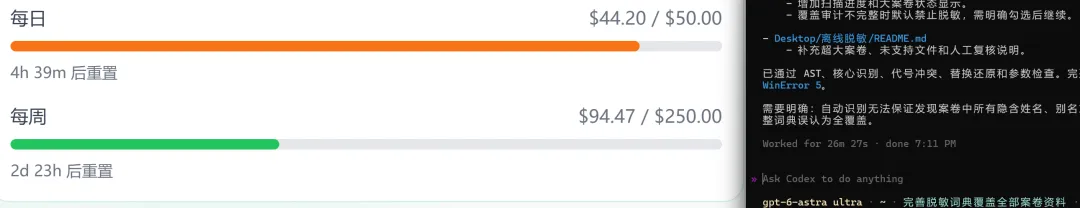
图6:gpt-6-astra ultra 完善脱敏词典
三路,K3 负责落地安装调试:
下载安装Ollama、拉取模型、跑通本机服务,再把本地大模型接进脱敏工具。
图7:Ollama安装中
图8:Ollama——Your data stays yours
五、第二版:本地大模型加持,GPU火力全开
新一轮测试,工具界面上多了一个关键选项:【启用本地大模型识别人名/机构/地点】。
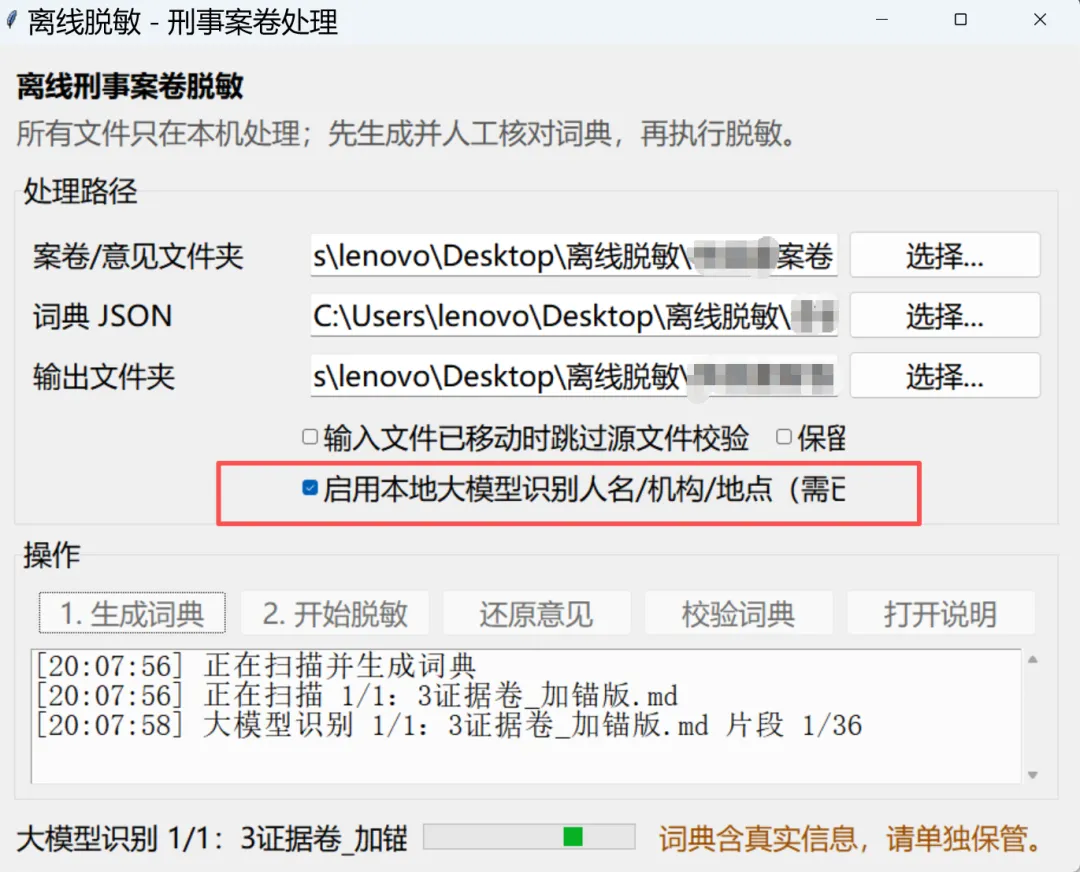
图9:新增本地大模型识别开关,案卷分片逐段识别
勾选之后,工作方式完全变了:案卷被切成一个个片段,逐段交给本地大模型阅读,由它结合上下文判断“这几个字到底是不是人名”——相当于请了一位住在电脑里的阅卷助理,逐页过筛。
效果立竿见影:上一轮那种四五个字误判成人名的情况基本杜绝,而整个识别过程完全在本地运行,一个字节都没有离开本机。
代价当然也有——任务管理器里,GPU占用率76%、显存吃掉6.5/8.0GB、核心温度68℃,风扇呼啸,GPU火力全开。
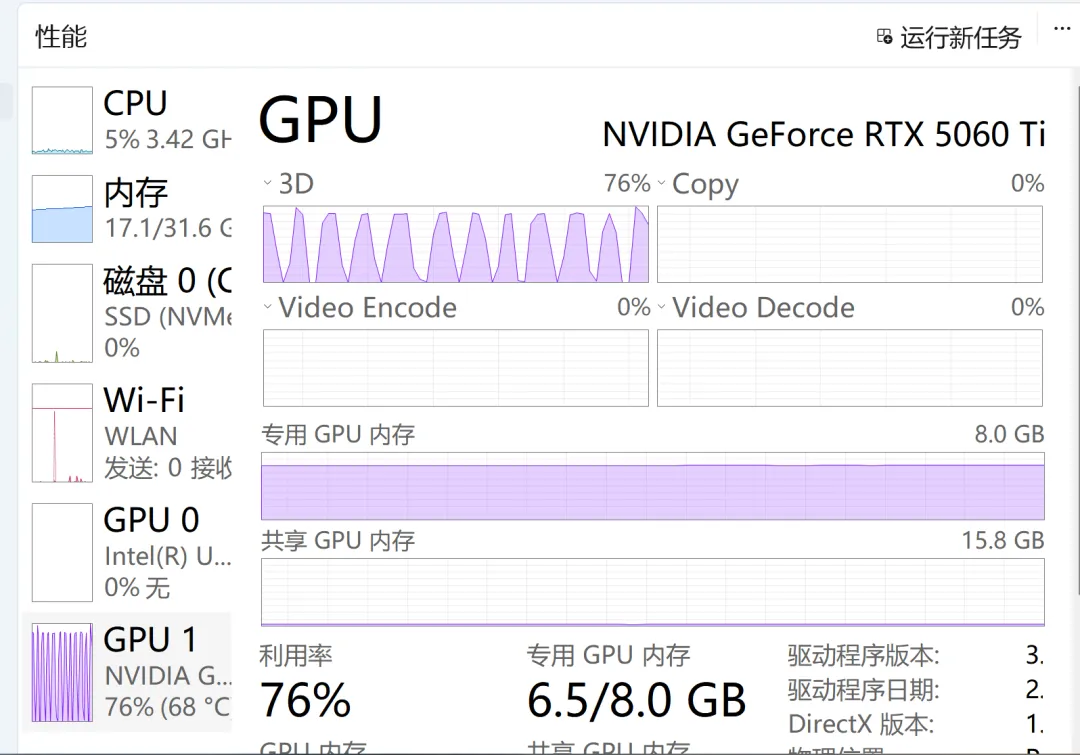
图10:GPU火力全开
但看着进度条一格一格往前走,心里是踏实的:这些案卷文字,自始至终没有离开过这台电脑。
六、冷静复盘
跑通之后,也要正视差距:本地7B/8B模型的理解力,与云端旗舰模型仍有距离。想再上一个台阶,就得换更好本地模型;更好的模型,意味着更强的显卡、更大的显存——对个人电脑而言,这条路任重道远。
所以我把下一步的重点放在本地脚本设计上,争取不靠堆硬件也能逼近零误差:
1、格式固定的(身份证、手机号、案号)继续走正则,开放类别的(人名、机构、地点)走本地大模型,各干各擅长的;
2、词典生成后加代号冲突检测与覆盖审计,凡是机器拿不准的,就要想办法让机器拿准了,争取不需要人工;
3、自动识别无法保证穷尽案卷中所有隐含的姓名、别名,机器负责初筛,人负责让机器筛的干干净净——工具界面上那句“先生成并人工核对词典”,争取让他成为摆设。
脱敏这件事,100分才是及格线。99%的准确率,意味着1%的信息在裸奔。
整个流程全部跑通:案卷在本地完成脱敏,云端大模型基于代号写出辩护意见,本地一键还原成带真实信息的成果。
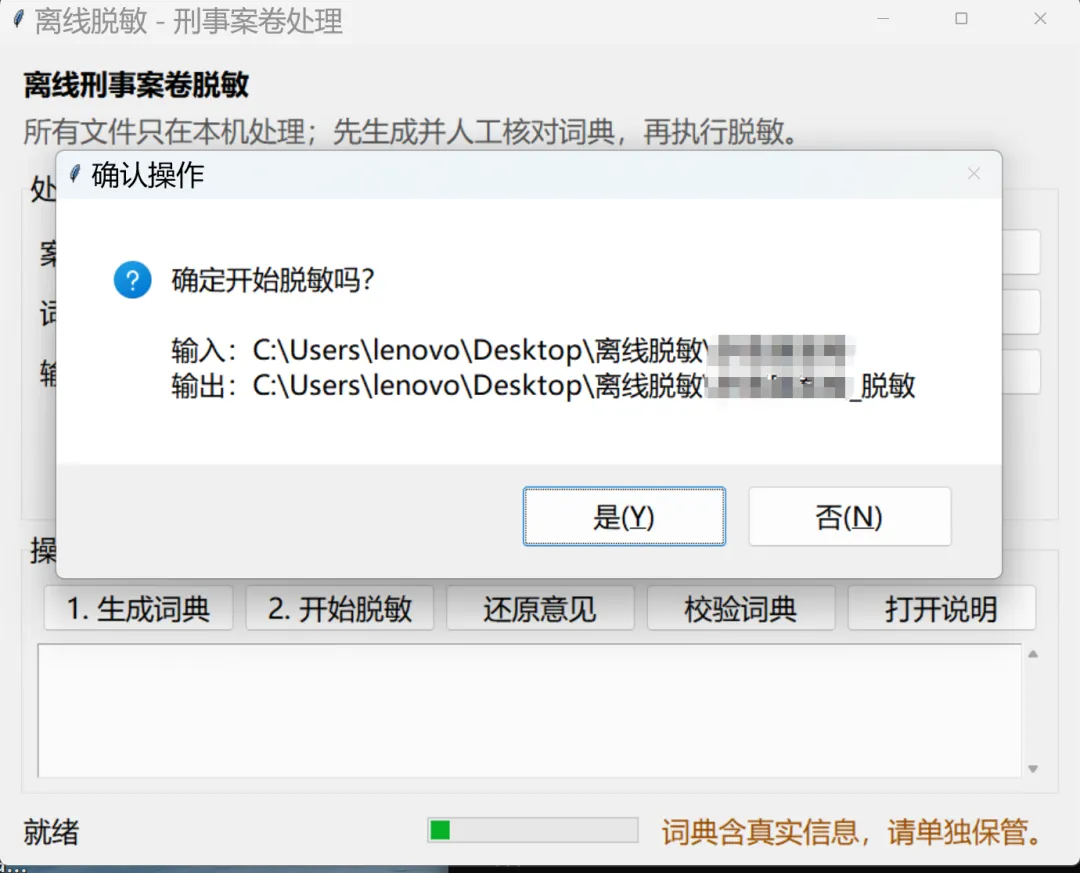
图11:确认脱敏,任务全部跑通,前路漫漫任重道远~
1、敏感行业使用AI,第一课不是提示词,是数据边界——什么能上云、什么永远不能上云;
2、多个Agent一起干:写代码的、诊断方案的、调研资料的,各跑各的,效率至上;
3、AI写的工具也需要持续优化才可以使用,多一些耐心多一些尝试!