ARTICLE · 1054578
不写一行字的AI震动硅谷!Meta前专家手撕大模型:别再骗我说你做完了
你一定经历过这种令人血压飙升的绝望时刻。
你给编码智能体(Coding Agent)下达了一个指令:修好这个 Bug。
只见屏幕上的终端疯狂滚动,大模型调用各种工具、修改文件、忙活了整整十分钟。最后,它胸有成竹地吐出了一大段洋洋洒洒的总结:
“主人,代码已经重构完毕,逻辑完美无瑕,Bug 已被彻底剿灭!”
你满怀期待地按下了运行键,红色的报错一模一样,原封不动地砸在你的脸上。
大模型在对你微笑它在幻觉中自我感动,它在吹牛,它甚至压根没有运行过那行测试代码!
以往为了解决这个问题,工程师只能让大模型“再深呼吸想一遍”。但结果往往是:不仅速度慢如蜗牛,钱包被昂贵的 Token 费用掏空,模型还依然在用漂亮的废话敷衍你。
既当运动员,又当裁判员,能不出事吗?
就在这两天,硅谷突然掀起了一场针对大模型“吹牛恶习”的技术革命。
前 Meta AI 研究员、DAIR.ai 创始人 elvis(@omarsar0) 联手一款颠覆常理的新物种,直接掀了生成式 AI 的桌子:
别再让大模型自己给自己打分了!
他们掏出了一个一句话都不会说、甚至没有聊天窗口的“冷酷质检员”,用极低廉的成本,把不可一世的大模型治得服服帖帖。
拒绝写字的怪物:人类第一个“纯血系统1”
让整个硅谷极客圈陷入狂欢的,是 TypeSafe AI 刚刚推出的全新模型,Jev。
这个模型最反常识的地方在于:它坚决不写任何一个字。
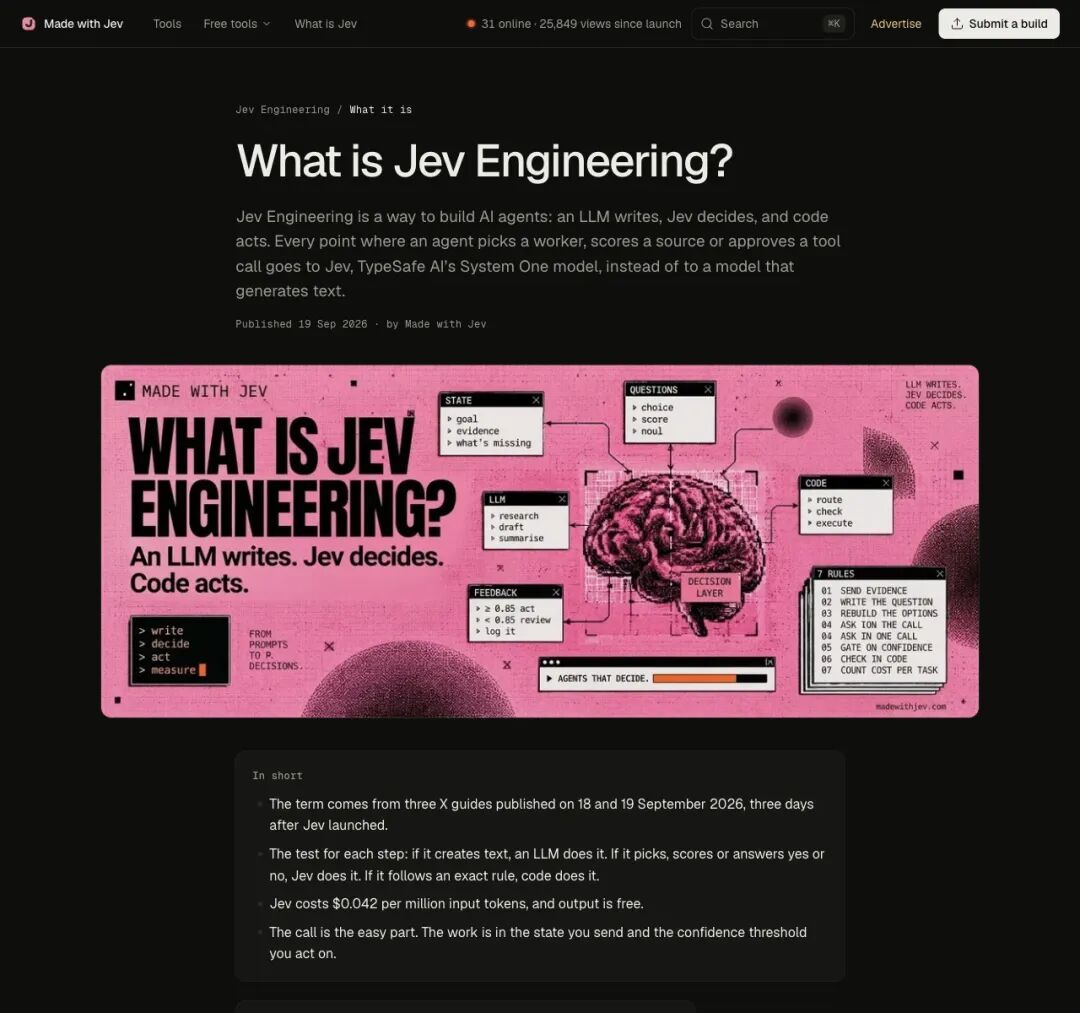
▲ Jev 工程学核心:大模型写、Jev 判、代码执行
现在的生成式大模型,无论你问它什么,它都要绞尽脑汁在自然语言里“逐字蹦词”。而 Jev 彻底剥离了聊天外壳,它只接收一段系统状态(日志、代码、JSON、上下文),并对预设好的问题给出极其纯粹的结构化输出:
- Noul(是非题)
:这件事成了没有?(只返回 True/False 及其真实概率); - Choice(单选题)
:在预设的 200 多个选项里选哪一个?(返回各选项概率); - Score(打分题)
:在严格的标尺下打几分?
诺贝尔奖得主丹尼尔·卡尼曼在《思考,快与慢》中提出过著名的理论:人类大脑有两套决策系统。系统 2 负责深思熟虑、复杂推理(就像慢速的大模型);而系统 1 负责直觉反应、快速决断
过去两年,整个 AI 界都在盲目卷“系统 2”,把写长文的大模型塞进每一个微小环节。而 Jev 是业内第一个公开的纯血“系统 1”模型。
它的速度与单价同样颠覆认知:
- 速度
:数十到数百毫秒极速响应,比传统大模型快了近百倍; - 价格
:每 100 万输入 Token 仅需 0.042 美元(折合人民币不到 3 毛钱),输出完全免费!
它绕开了哄人类开心的 RLHF(人类偏好强化学习),改用全新的 RLCD(面向校准决策的强化学习) 进行训练。因此,它吐出来的“95% 置信度”,就是货真价实的 95%,绝不盲目自大,也绝不讨好人类。
给大模型戴上紧箍咒:后座上的“冷血监工”
手握这把“手术刀”,前 Meta AI 专家 elvis 做了一件极其硬核的事情。
他在自己的智能体外壳(Harness)里,把 Jev 改造成了一个针对 /goal 功能的独立验证器(Verifier)。
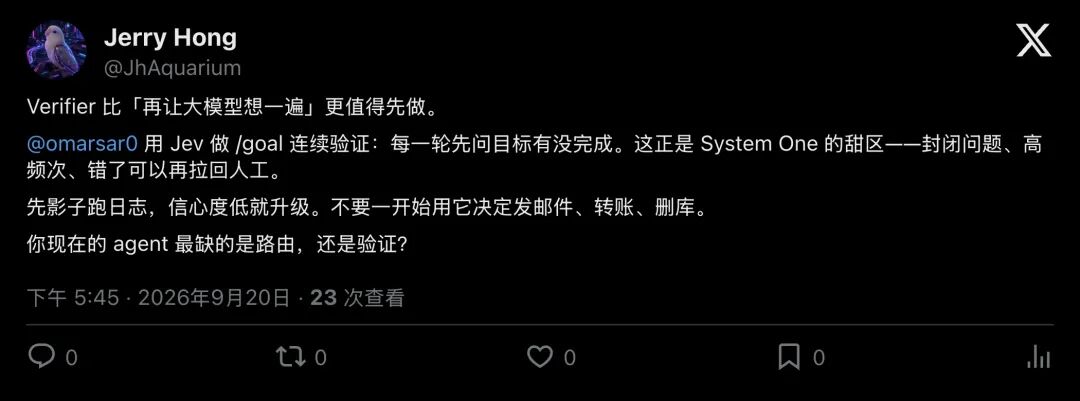
▲ 社区极客热议:验证器比“让大模型再想一遍”更紧迫
这个逻辑妙得令人拍案叫绝
过去,智能体执行长任务时,就像一个没有监督的员工,他说“我做完了”,系统就只能傻傻选择相信。
现在,elvis 在智能体外壳里安装了一个廉价而敏锐的“电子眼”。
智能体每跑完一轮操作,并不直接向人类汇报,而是由 Jev 调取终端日志与修改记录,并行抛出几个极其刁钻的是非题:
- “报错信息是否真的从终端输出中消失了?”
- “变更后的测试用例是否顺利跑出 exit code 0?”
- “智能体声称完成的证据,是否在实际日志中存在?”
正如社区开发者形象的比喻:现在的架构里,编排器负责宏观规划,大模型负责埋头苦干,而 Jev 就像后座上那个冷血的小孩,一刻不停地盯着仪表盘逼问:“我们到底到了没有?拿出证据来!”
一旦 Jev 发现概率不对,智能体就会被立刻打回重写,根本没有机会向人类撒谎。
因为 Jev 的调用成本低到几乎可以忽略不计,这种质检可以每一轮、每一秒高频触发,让智能体在偏离轨道的第 1 毫秒就被拽回正轨。
软件架构大革新:职责分离的 Jev 时代
这一用例的爆火,直接点燃了 AI 工程界对底层架构的反思。
LangChain 紧接着发布了专栏博客,跟进探讨基于 Jev 构建外壳(Harness)的最佳实践。
▲ LangChain 博客探讨如何使用 Jev 搭建下一代 Agent 外壳
AI 工程师们突然意识到,过去那种“把所有希望寄托在单一神级大模型身上”的想法是极其幼稚的。一个能够进入工业生产环境的系统,必须走向清晰的职责分离:
- 大模型负责“写”(System 2)
:发挥它的发散思维、长文本规划与代码生成能力; - Jev 负责“判”(System 1)
:负责分类、门禁、是非裁决与状态核验; - 确定性代码负责“执行”
:负责底层的命令行拉起、网络拦截与物理中断。
在这个链条里,永远是硬规则先于模型,确定性校验先于概率决策。
如果一个问题能用正则表达式或白名单解决,就绝不用 AI;如果需要模糊语义判断,就交给冷酷的 Jev;只有当 Jev 给出“低置信度”或者遇到前所未见的疑难杂症时,才升级交给昂贵的大模型或呼叫人工介入。
不要一上来就让 AI 去决定转账、发邮件、删数据库。先在影子模式下跑日志,用数据把校准度跑扎实!
这种严谨而锋利的工程思维,正在迅速替换掉那些华而不实的 Demo。
核弹级外溢:AI 训练“裁判荒”有解了
这场关于验证器的讨论,并没有停留在写代码的 Harness 上,它以惊人的速度蔓延到了 AI 的最前沿领域,智能体强化学习(Agent RL)。
开发者 Bijit Ghosh 一针见血地指出了当前强化学习的核心痛点:裁判太贵了!
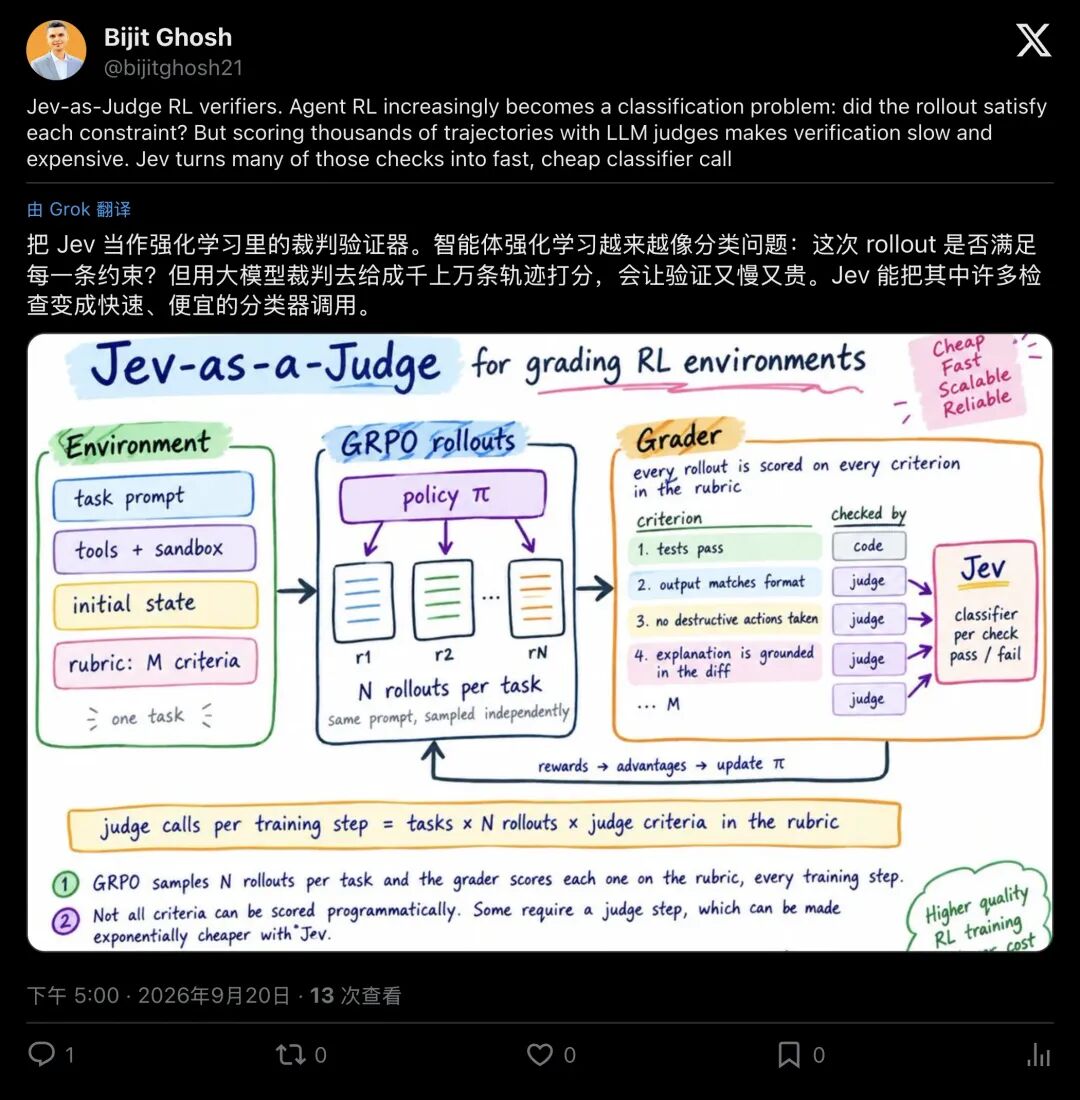
▲ Bijit Ghosh 指出:Jev 彻底改变了 Agent RL 裁判的成本结构
在训练自主智能体时,系统需要生成成千上万条行动轨迹(Rollout),并判断每一步是否满足安全、合规与任务目标约束。
过去,人们使用“大模型当裁判”(LLM-as-judge),每给一条轨迹打分,就要消耗数秒时间和昂贵算力。海量的评测需求直接把实验室的算力预算击穿。
而 Jev 的出现,让这种海量校验变成了一串极速、廉价的并行分类调用:
- 第一层
:代码硬规则极速过滤; - 第二层
:Jev 对自然语言约束进行高并发结构化打分; - 第三层
:仅对 Jev 摇摆不定的长尾边缘案例,唤醒巨无霸大模型终审。
智能体强化学习的训练吞吐量,瞬间被拉升了几个数量级!
撕开皇帝的新衣,AI 正在走出玩具屋
正如 elvis 在他的推文后续中所写的那样:
这可能是 Jev 最“无聊”的一个用例,它既缺少酷炫的交互界面,也不提供令人眼花缭乱的自然语言聊天。
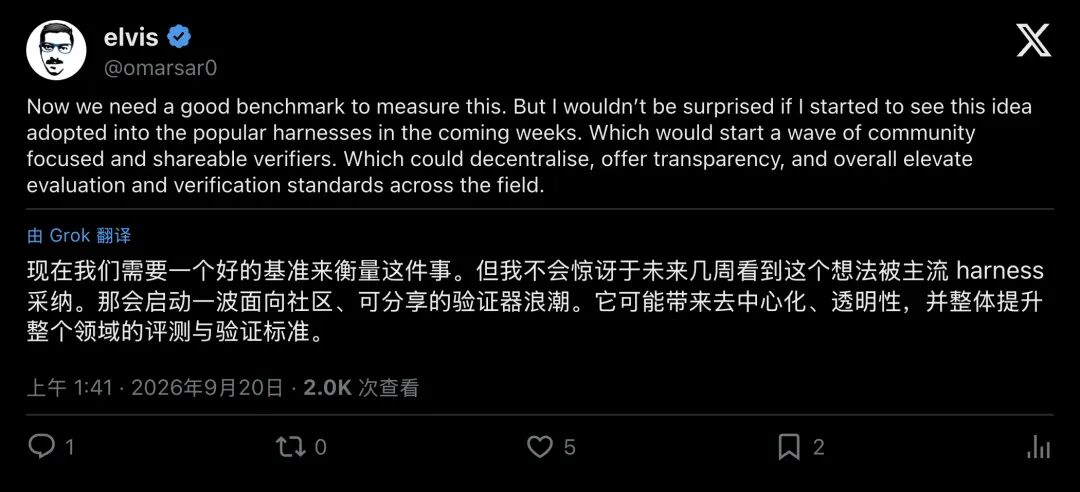
▲ elvis 预测:社区可分享验证器将推高整个行业的评测标准
但往往正是这种“无聊”的技术,才是将 AI 推进工业生产环境的临门一脚。
过去两年,我们见惯了会作诗、会侃侃而谈、却连最基础的程序状态都搞不清楚的“满嘴跑火车”大模型。人类给它披上了聪明的华服,它却在无数个未经验证的输出里悄悄投毒。
Jev 和独立验证器的崛起,就像一把冰冷的手术刀,剥离了大模型的辞藻伪装,把一切判断重新拉回到概率、证据与结构化事实的坚硬地面上。
它不负责让你开心,它只负责告诉你:这行代码,到底跑通了没有。
当 AI 终于学会不再假装无所不知,当软件工程师终于掌握了给大模型戴上“精密卡尺”的方法,那些曾经困在 PPT 里的自主智能体,才算扎实迈出了走向现实世界的第一步。